2026 开源论坛(第四届)
会议日程
8月22日(周六)会议(白天:逸夫管理科学楼20楼报告厅;晚上:唐仲英楼B501)
| 时间 | 题目 | 报告人 | Slides |
|---|---|---|---|
| 08:30-09:00 | 签到 | ||
| 09:00-09:10 | 欢迎词 | 姚舸(南京大学) | 下载 |
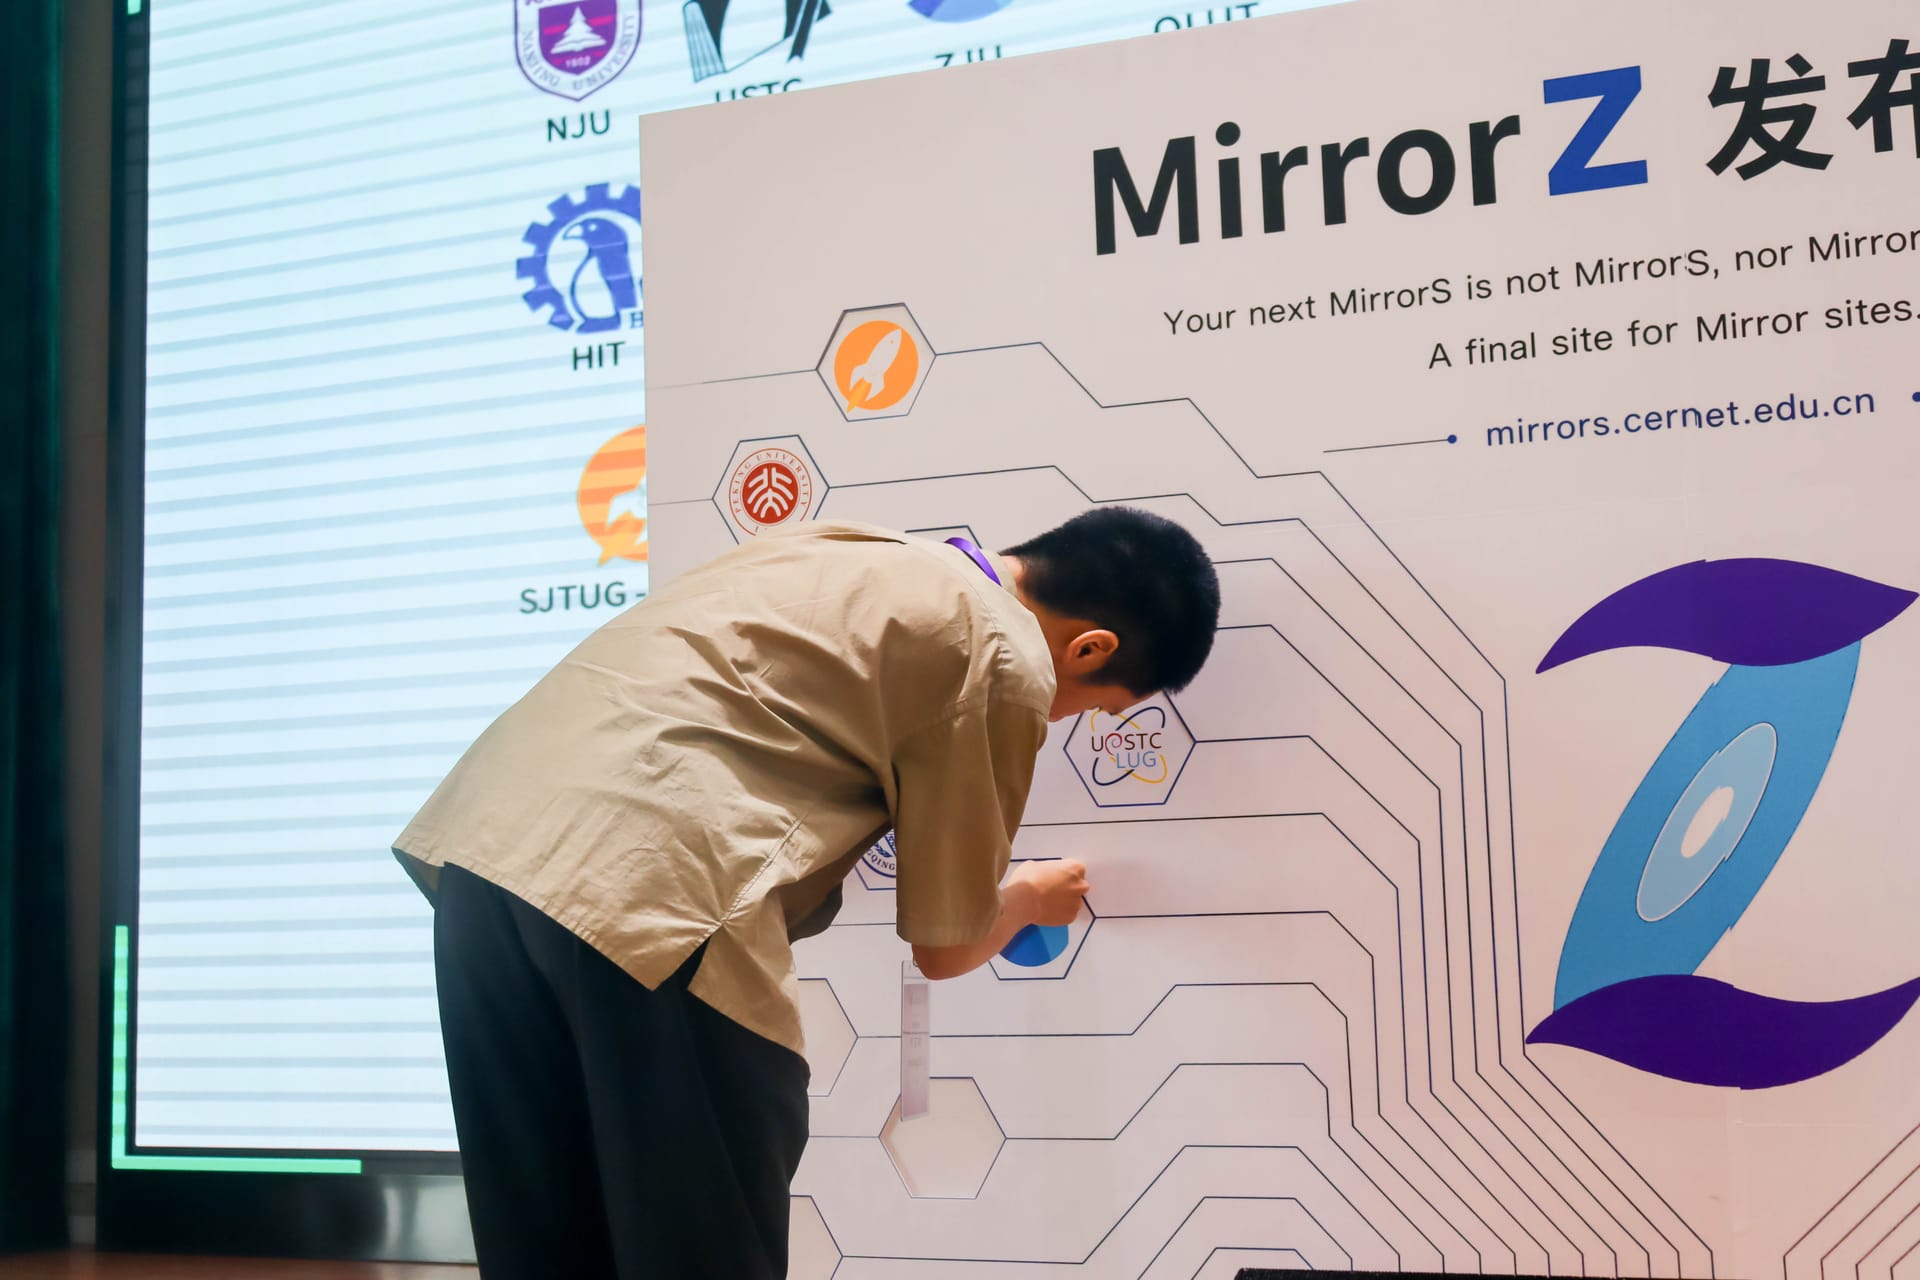
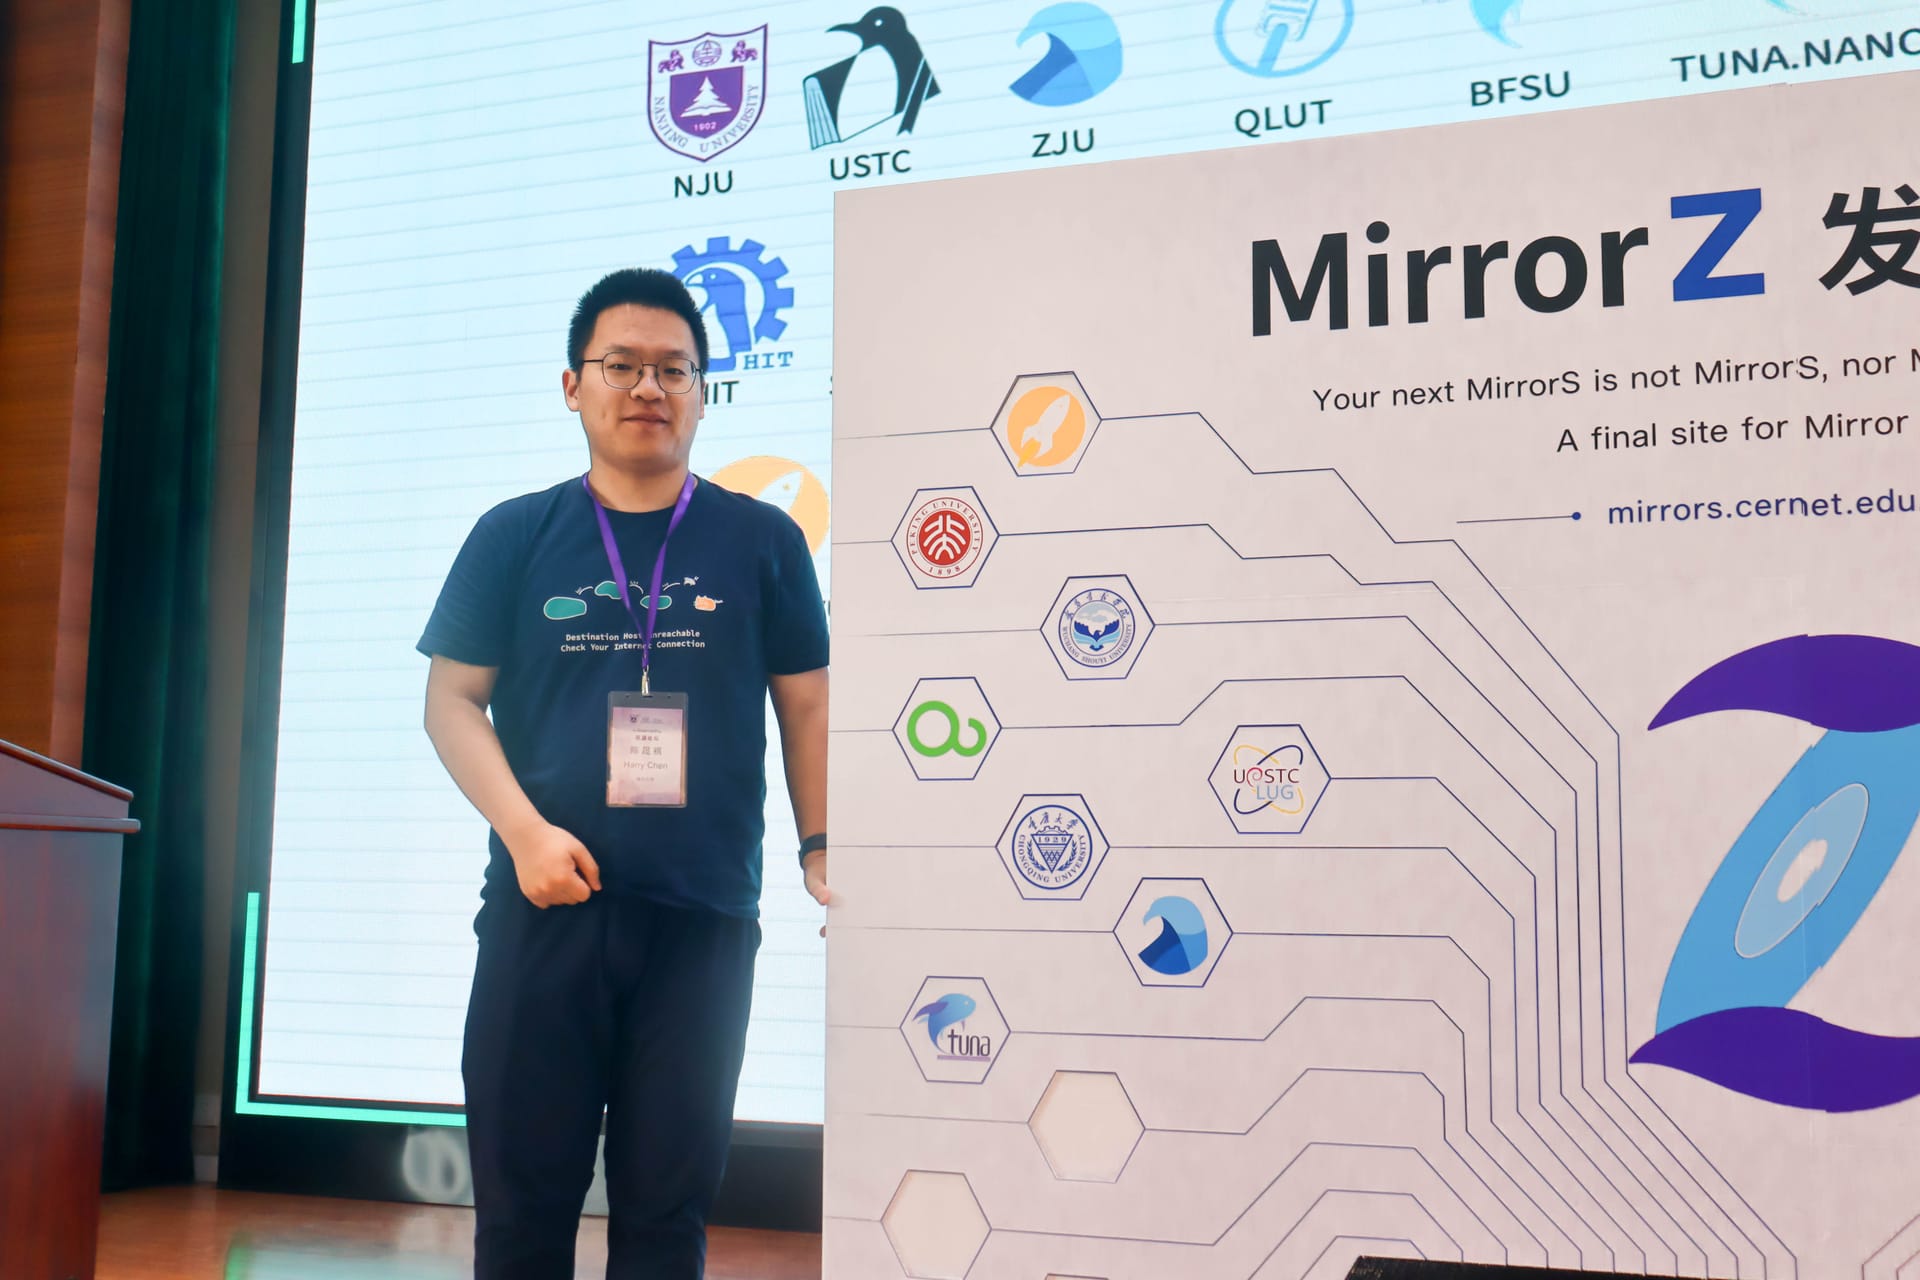
| 09:10-09:40 | MirrorZ 发布仪式及其介绍 | 镜像站们代表 | 下载 |
| 09:40-10:10 | 如何在镜像站里优雅地“点击房子”——从一台镜像服务器到 HERNET Mirrors 的高校开源基础设施实践 | 潘富(河南省教育科研网) | 下载 |
| 10:10-10:40 | 镜像站云原生FS与可观测性实践 | 尚子焜(东南大学) | 下载 |
| 10:40-11:00 | 讨论 | ||
| 11:00-11:30 | 面向全球用户的网络优化实践 | 穆佃舜(TeXPage) | 下载 |
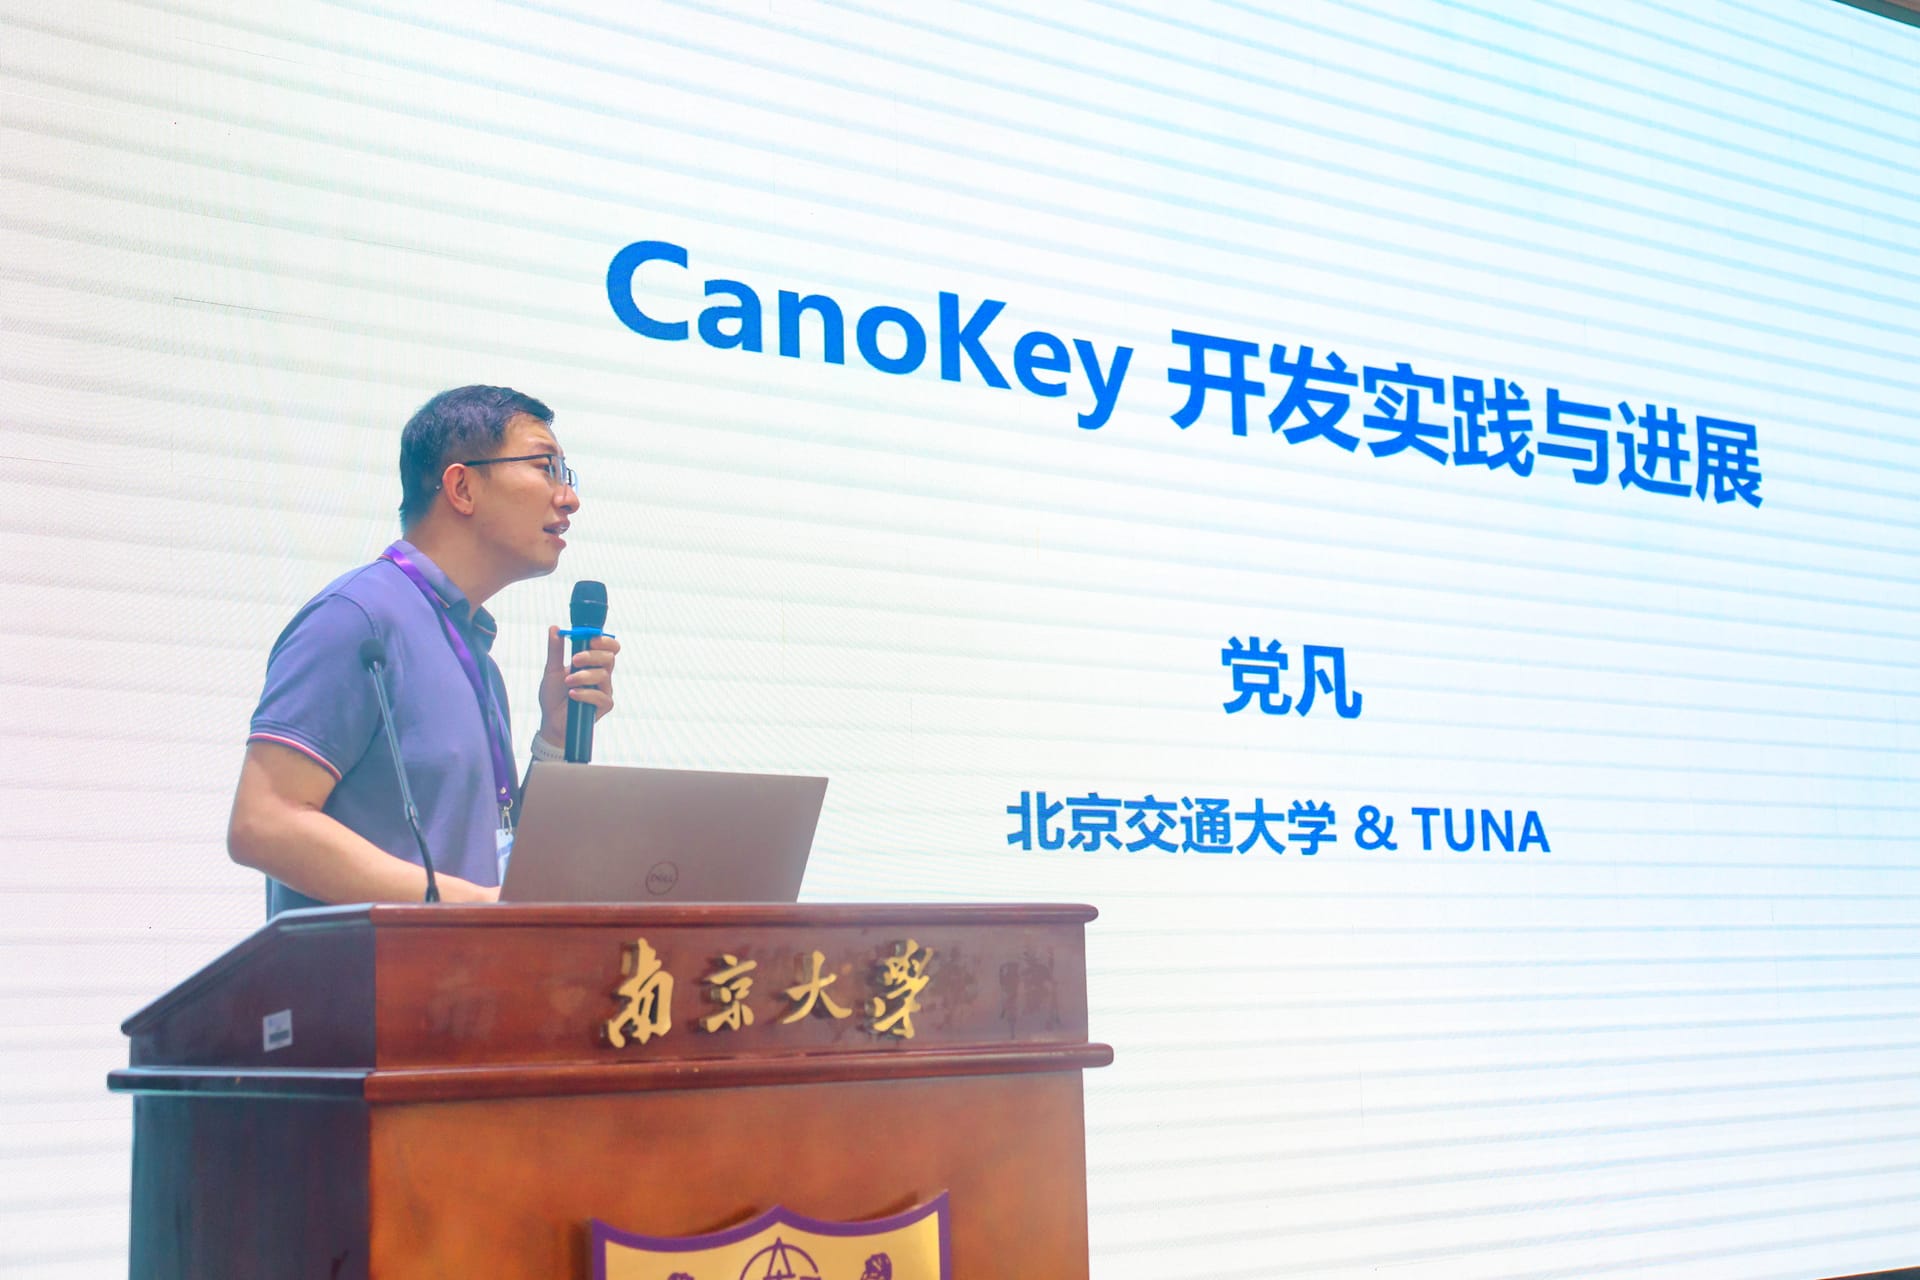
| 11:30-12:00 | CanoKey 开发实践与进展 | 党凡(北京交通大学 & 清华大学 TUNA 协会) | 下载 |
| 12:00-14:00 | 午餐 | ||
| 14:00-14:30 | 清华大学学生超算团队介绍与未来规划 | 金煜阳(清华大学) | 下载 |
| 14:30-15:00 | Puro-2B:全流程开源语言模型训练——用5万人民币在 RTX5090 上挑战 Qwen2-1.5B | 陈晟祺(清华大学) | 下载 |
| 15:00-15:30 | Kimi K3 in vLLM | 朱江云(Inferact) | 下载 |
| 15:30-15:50 | 讨论 | ||
| 15:50-16:20 | FPGAOL Next—在线FPGA实验平台 | 罗嘉宏(中国科学技术大学) | 下载 |
| 16:20-16:50 | 中国科大大模型公共服务平台建设 | 王永福(中国科学技术大学) | 下载 |
| 16:50-17:20 | e-Science 中心的开源基础设施 | 姚舸(南京大学) | 下载 |
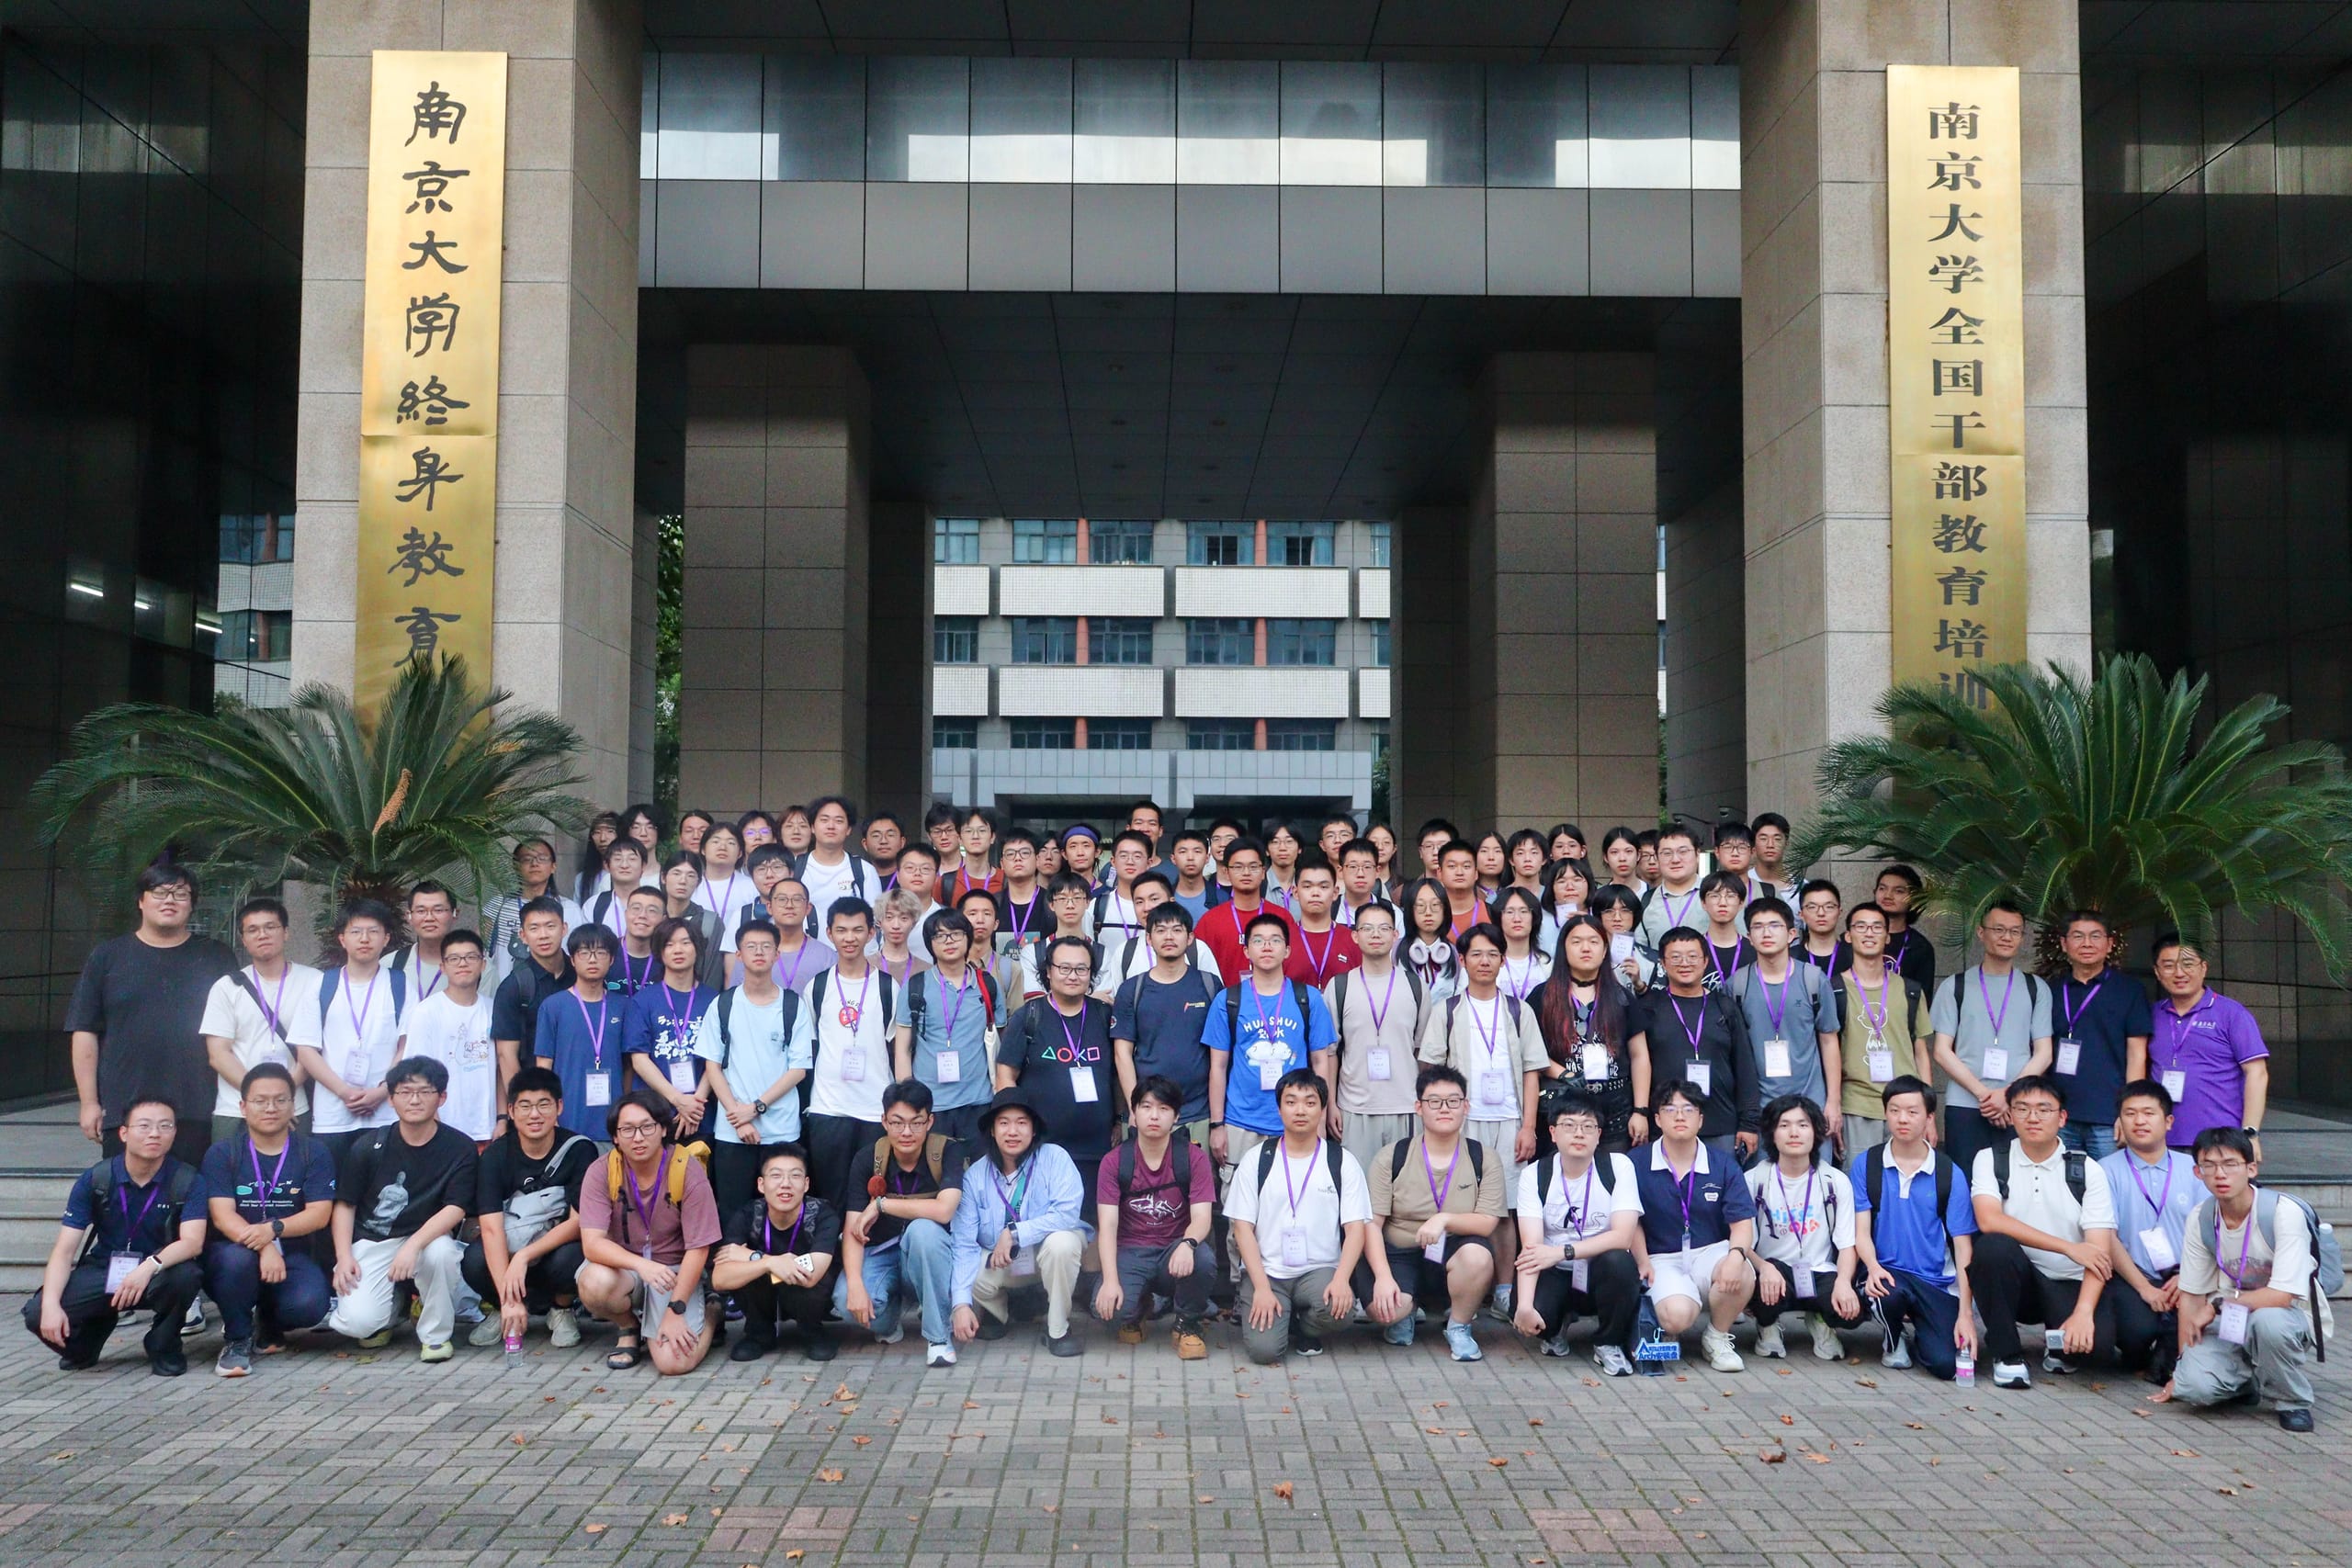
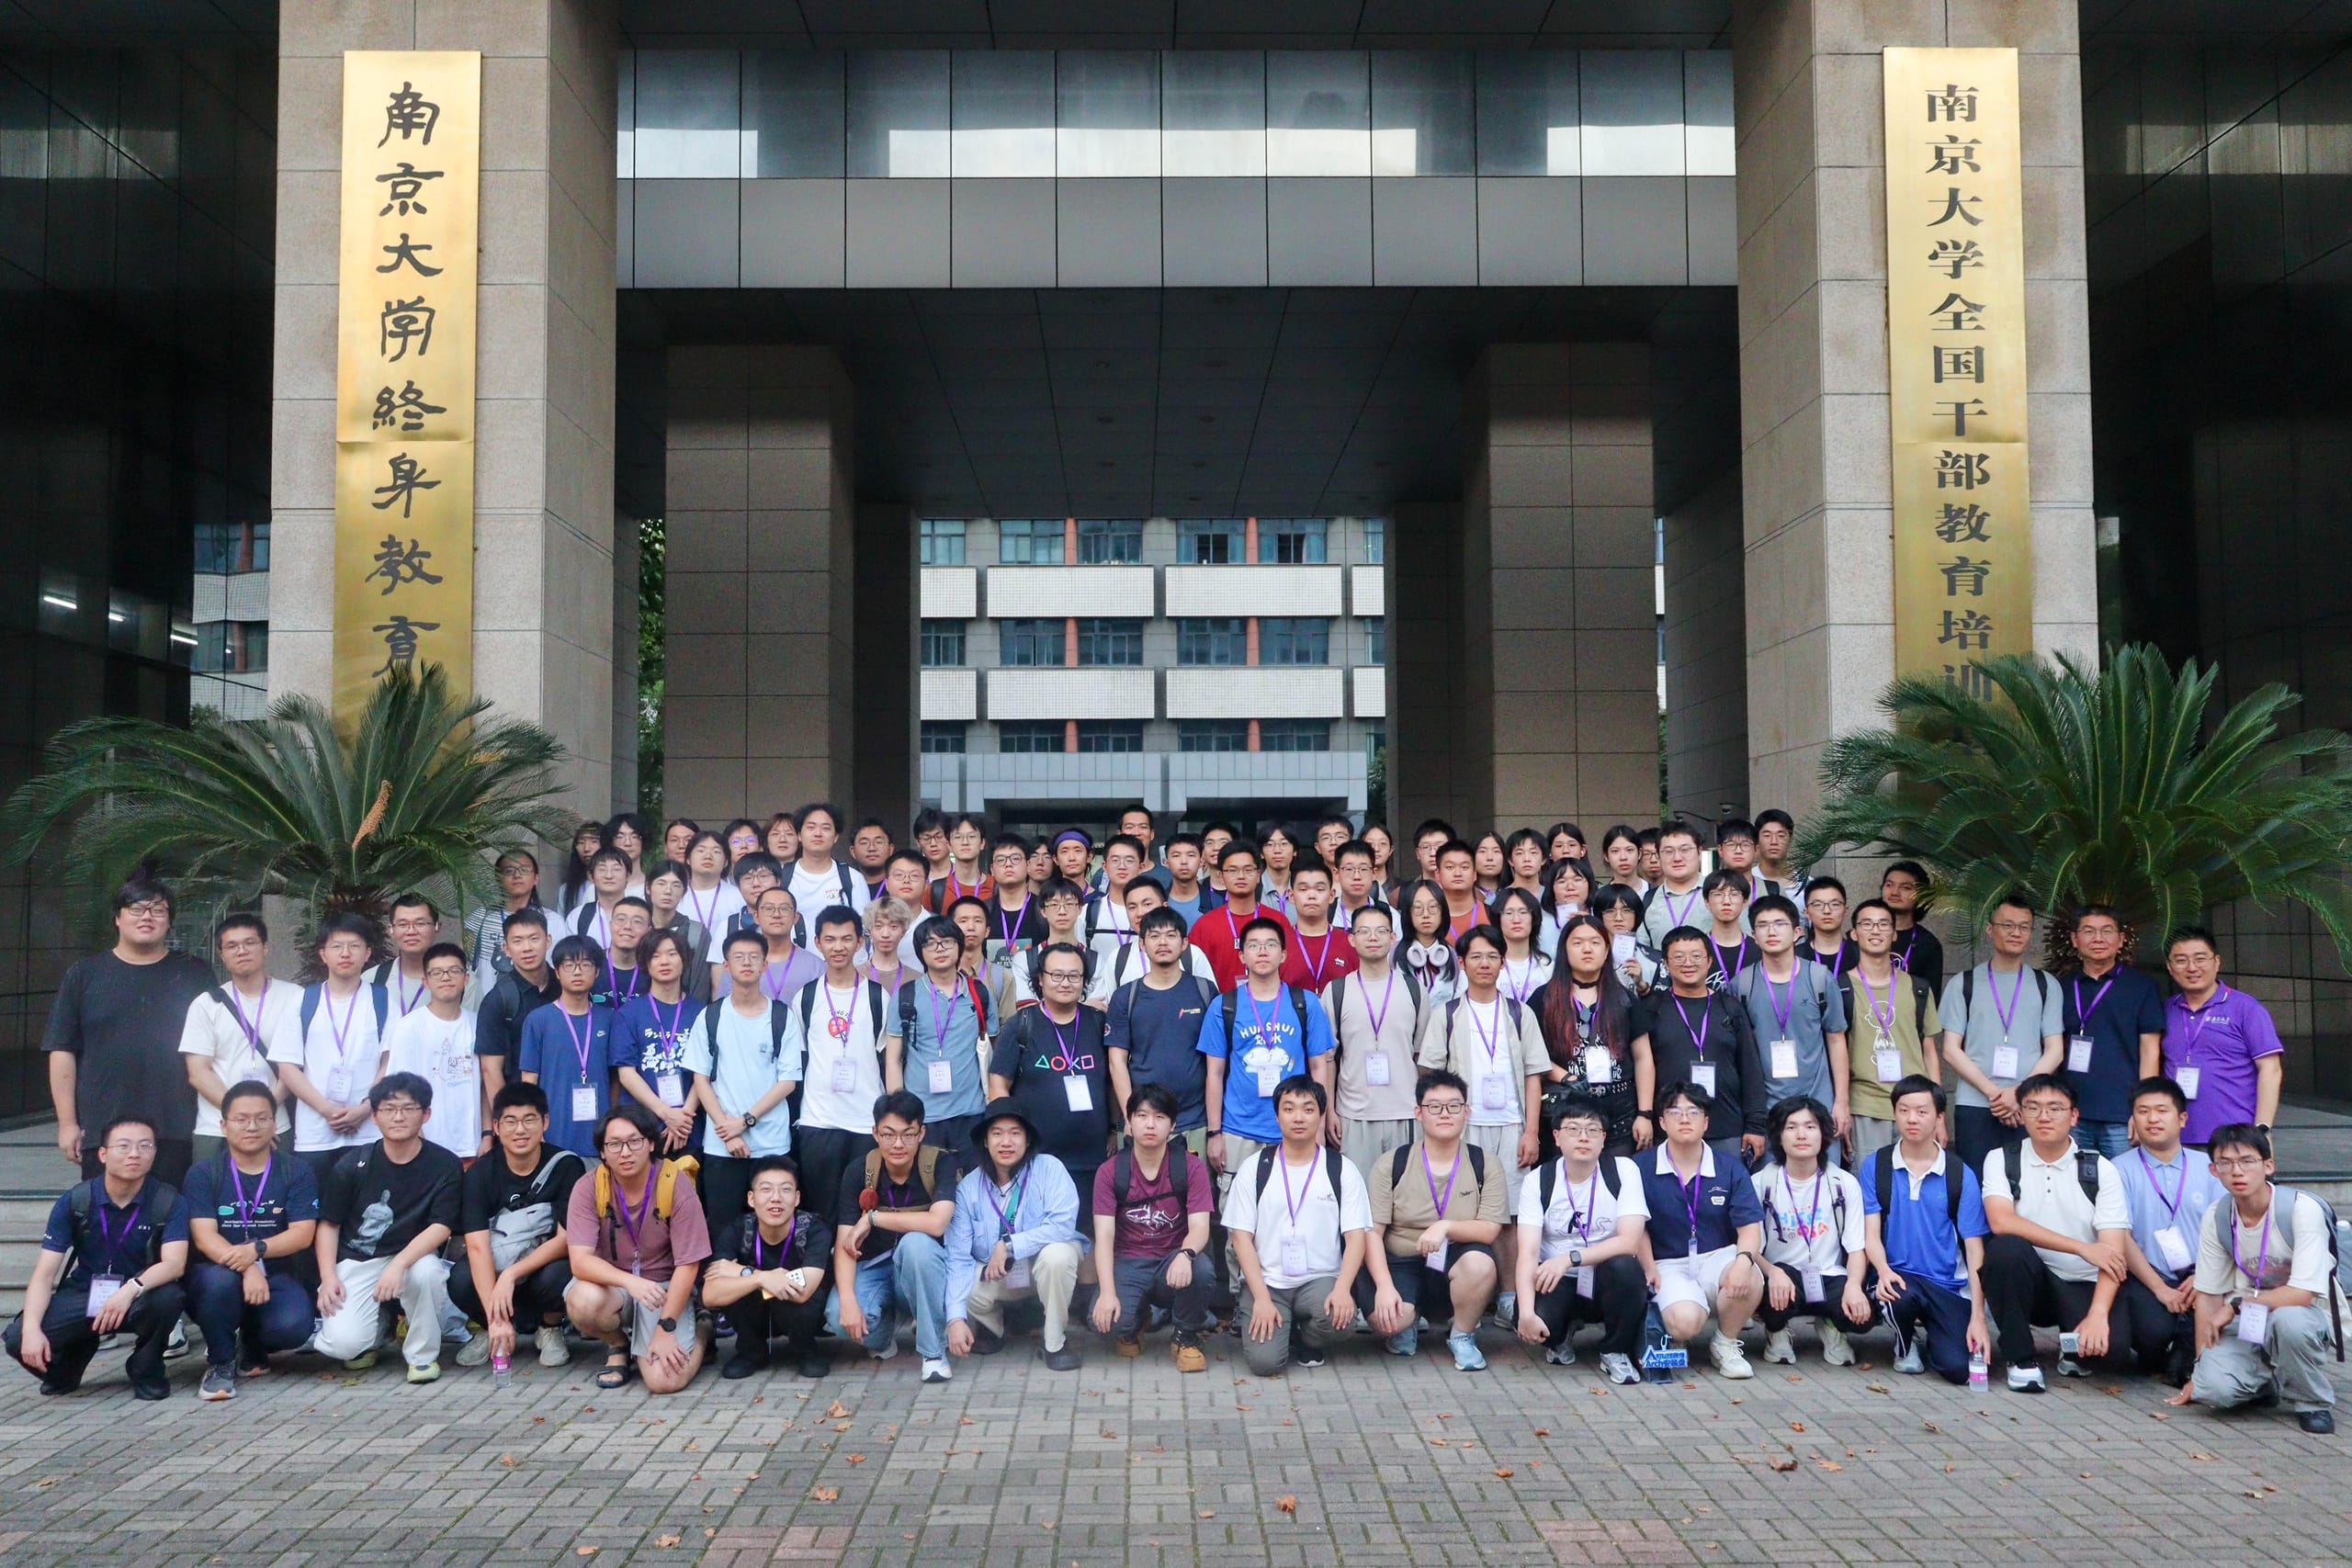
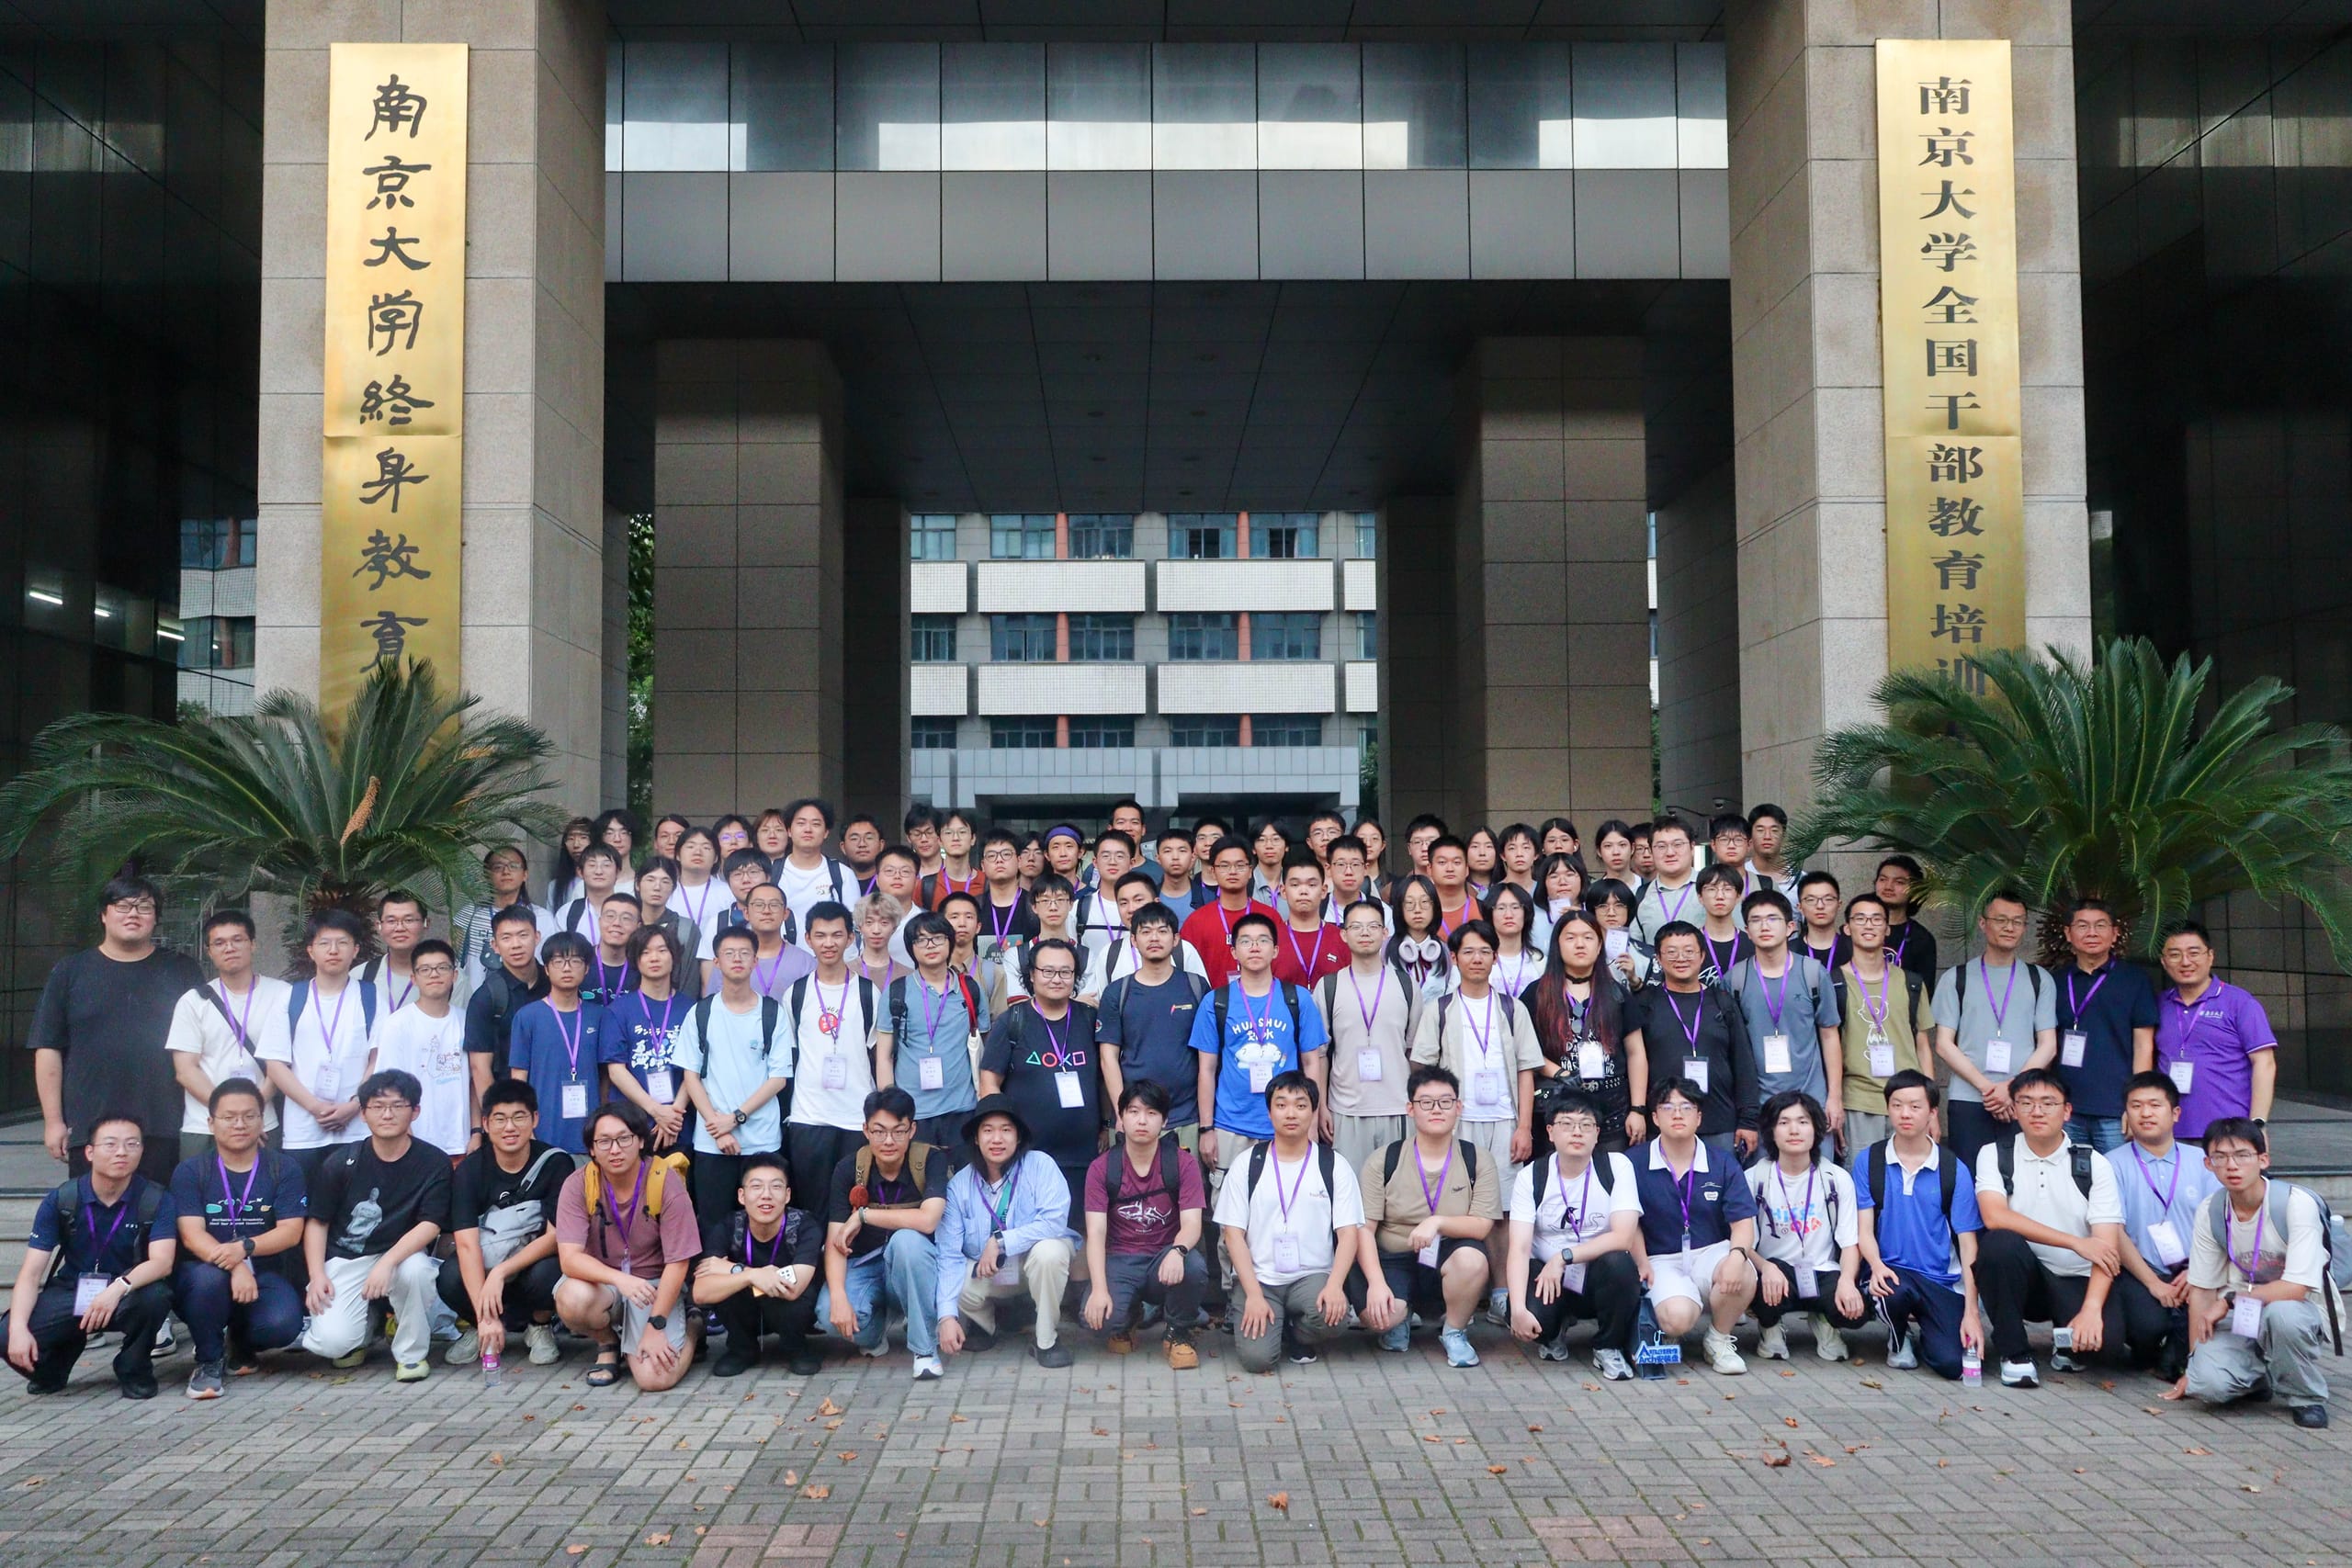
| 17:20-17:30 | 合影 | ||
| 17:30-19:00 | 晚餐 | ||
| 19:00-22:00 | 自由交流 | 唐仲英楼B501 |
会议总结
2026年8月22日,eScience中心主办的2026年第四届开源论坛顺利召开。会议汇聚高校师生与企业代表,围绕开源镜像基础设施、大模型训练与推理优化、硬件安全与教学实验平台等议题展开深度分享。
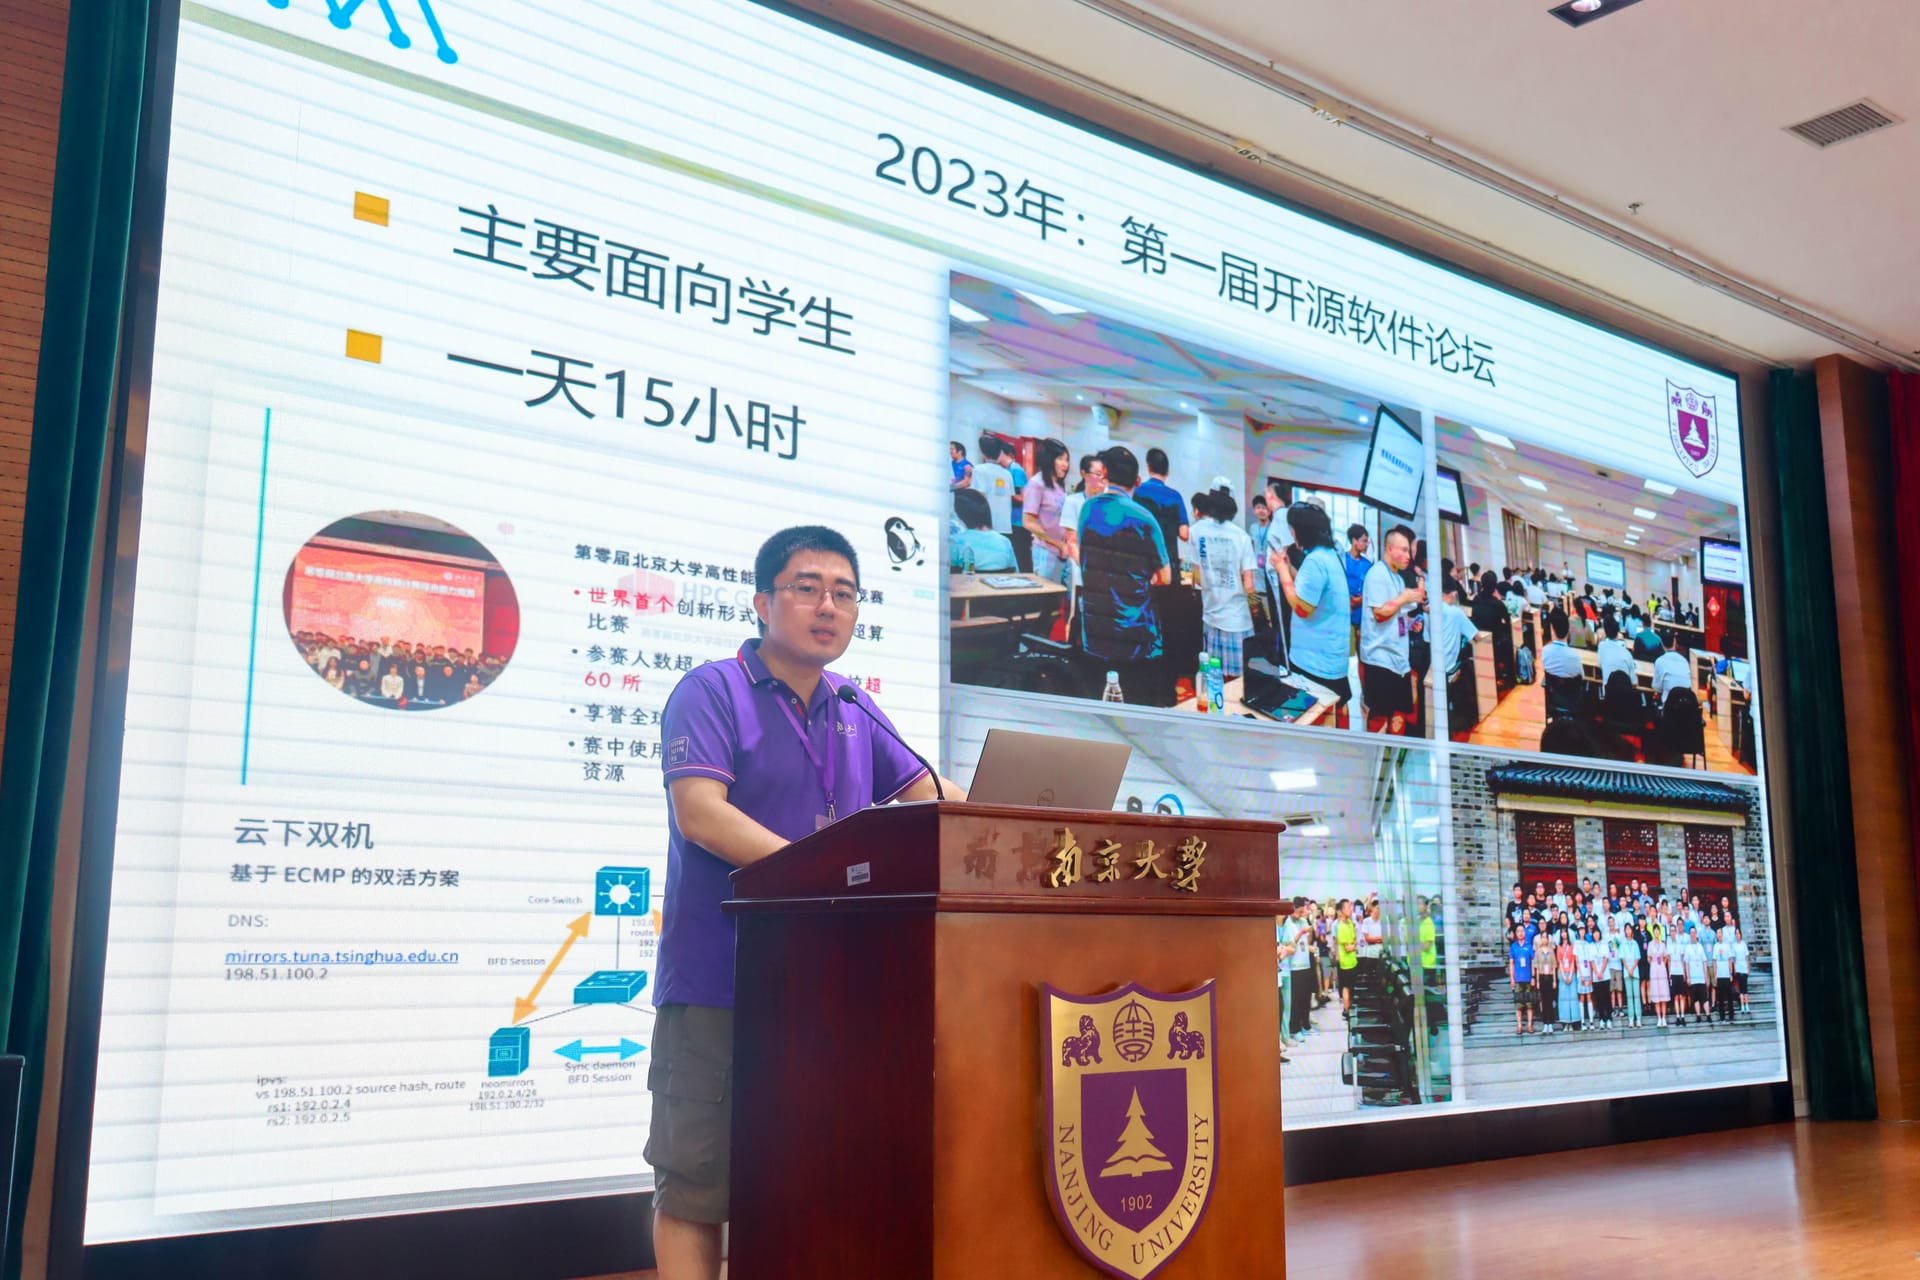
上午9点30,南京大学信息化建设管理服务中心副主任、e-Science中心负责人、高级工程师姚舸致欢迎词,拉开会议序幕。
姚舸回顾了历届开源软件论坛的举办历程——从2023年第一届“一天15小时”的高强度议程,到2025年第三届持续到近24点的热烈讨论,论坛规模与氛围一年更胜一年。本届论坛延续“主题开源相关、范围不设限制”的传统,为校内外开源爱好者提供自由交流的平台。
MirrorZ教育网联合镜像站正式发布
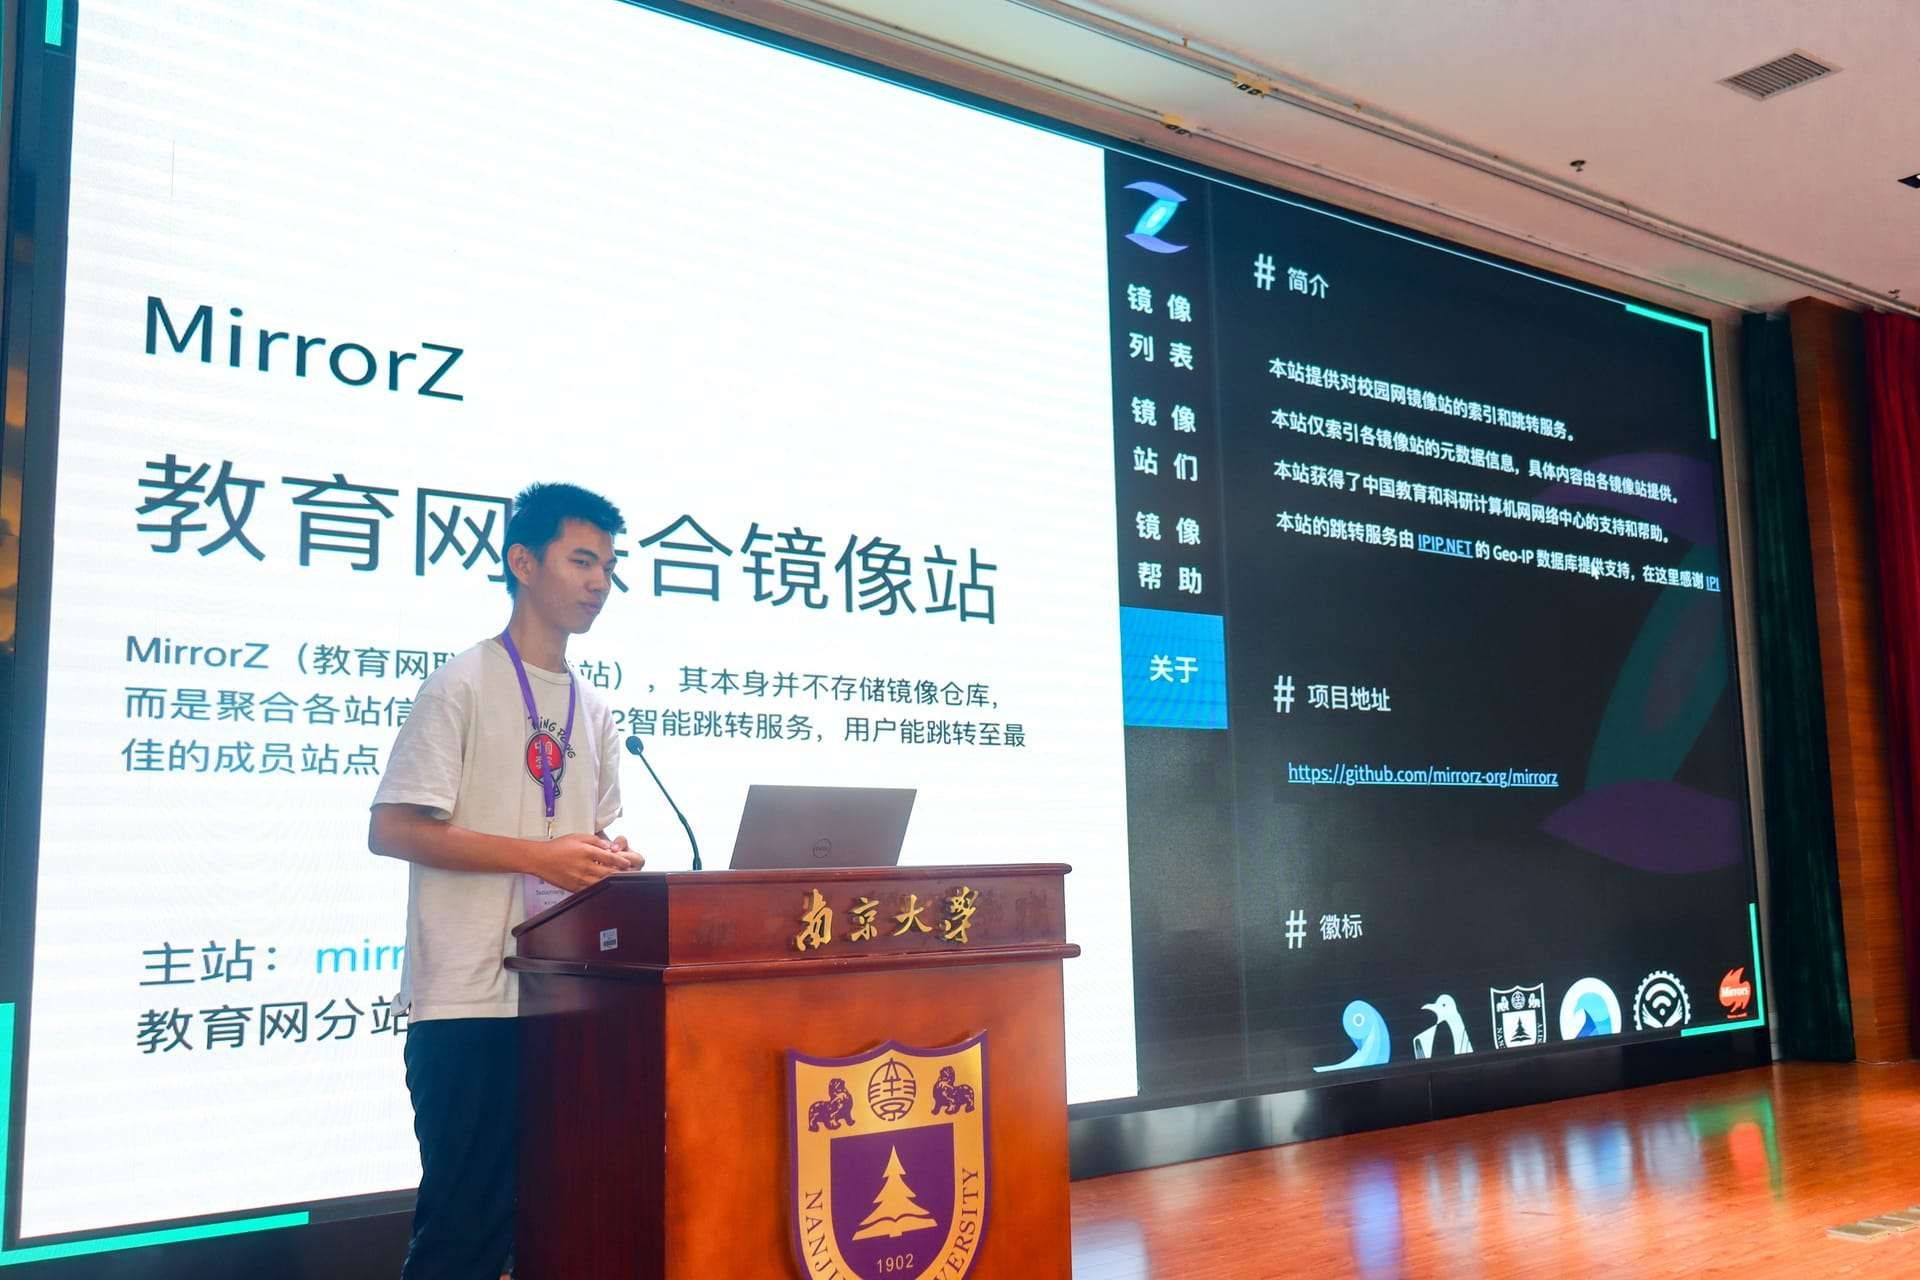
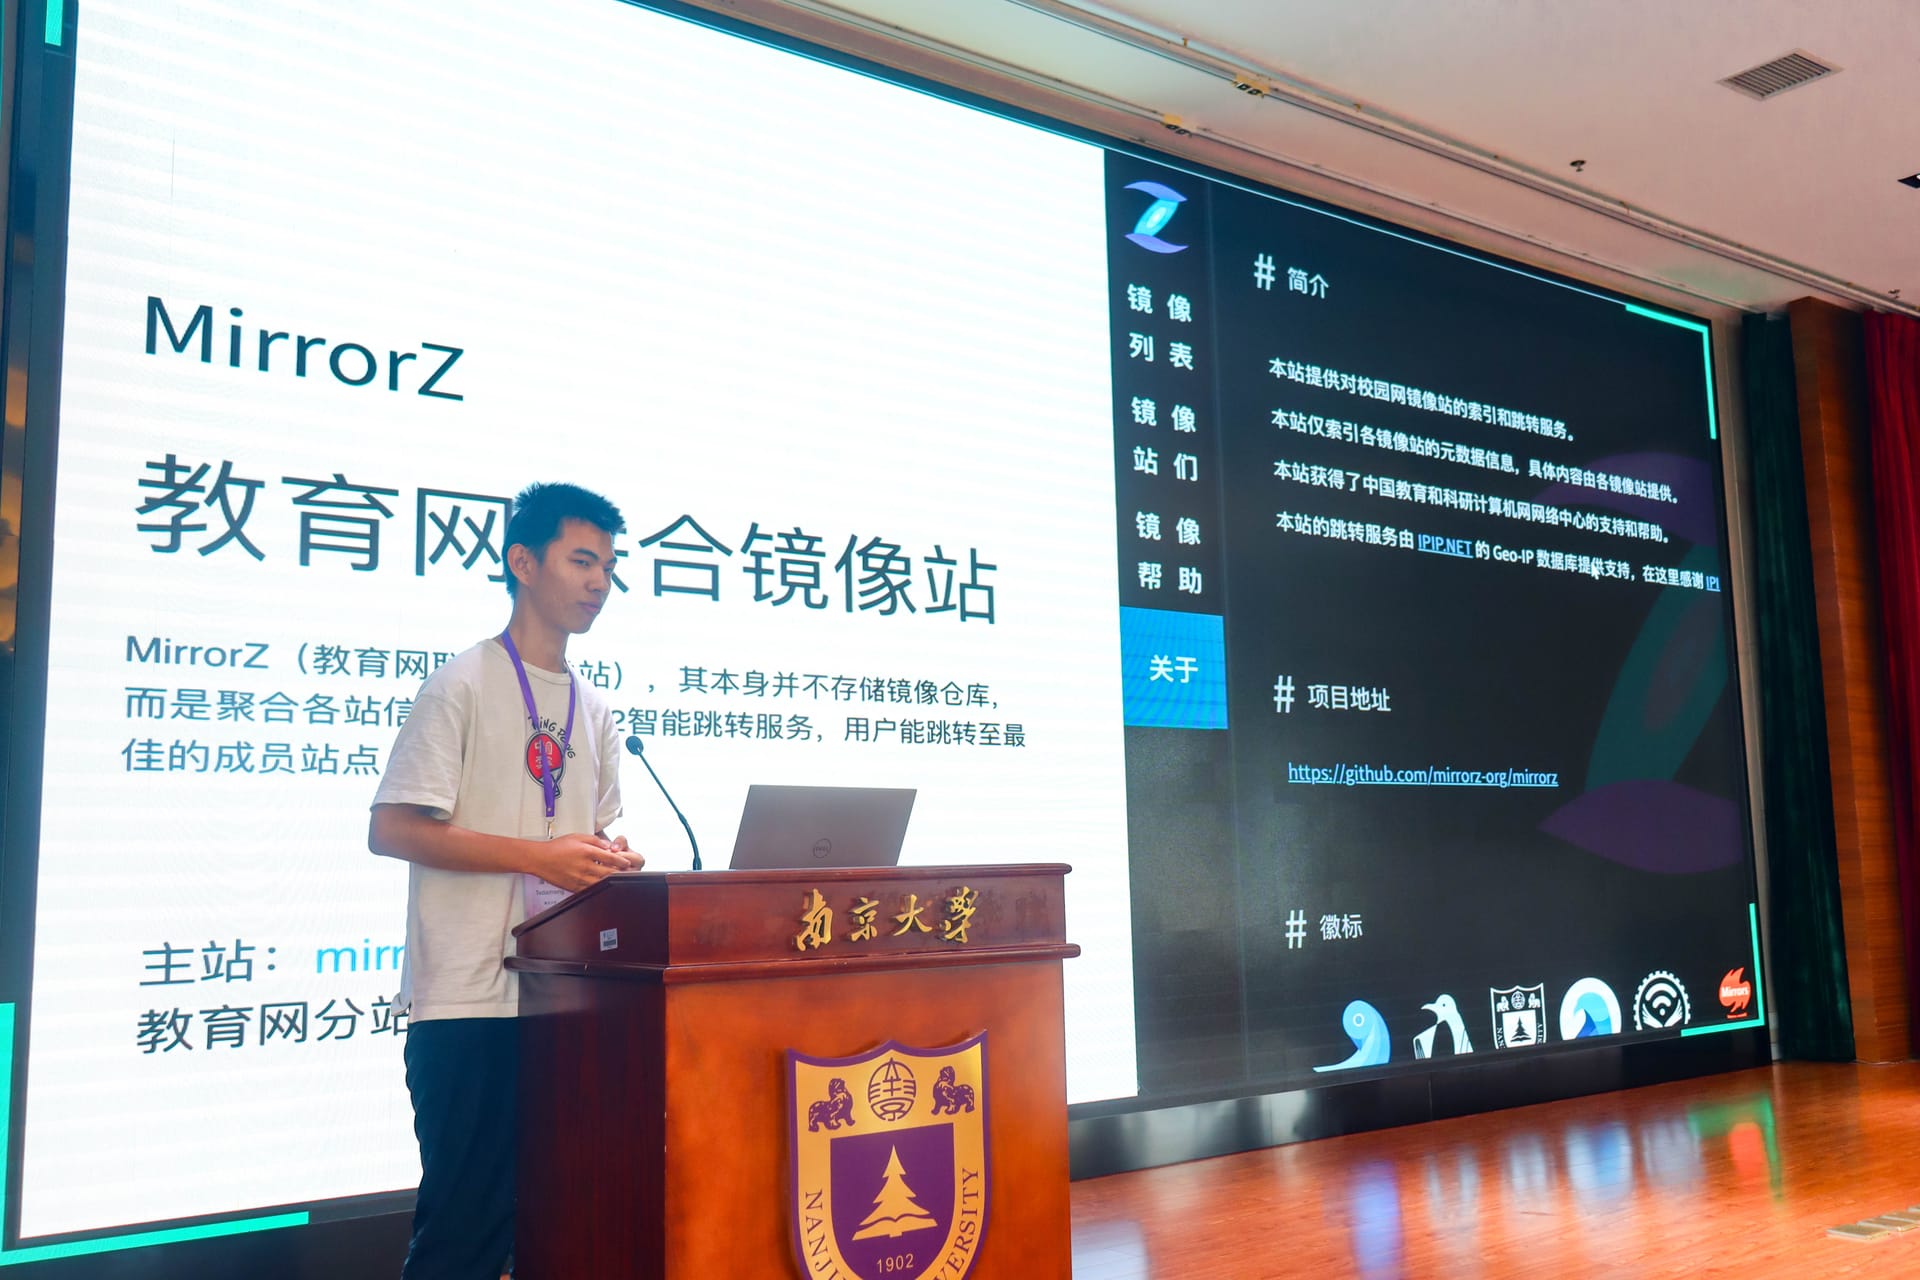
上午议程中,首先登场的是由重庆大学微电子与通信工程学院谭浩然带来的教育网联合镜像站 MirrorZ 的介绍。
MirrorZ 本身不存储镜像仓库,而是聚合各校镜像站的同步信息,通过 302 智能跳转把用户分发到最佳成员站点,实现“一次查找,多站可用”,既为 TUNA、USTC 等大站减负,也提升了小站的利用率。
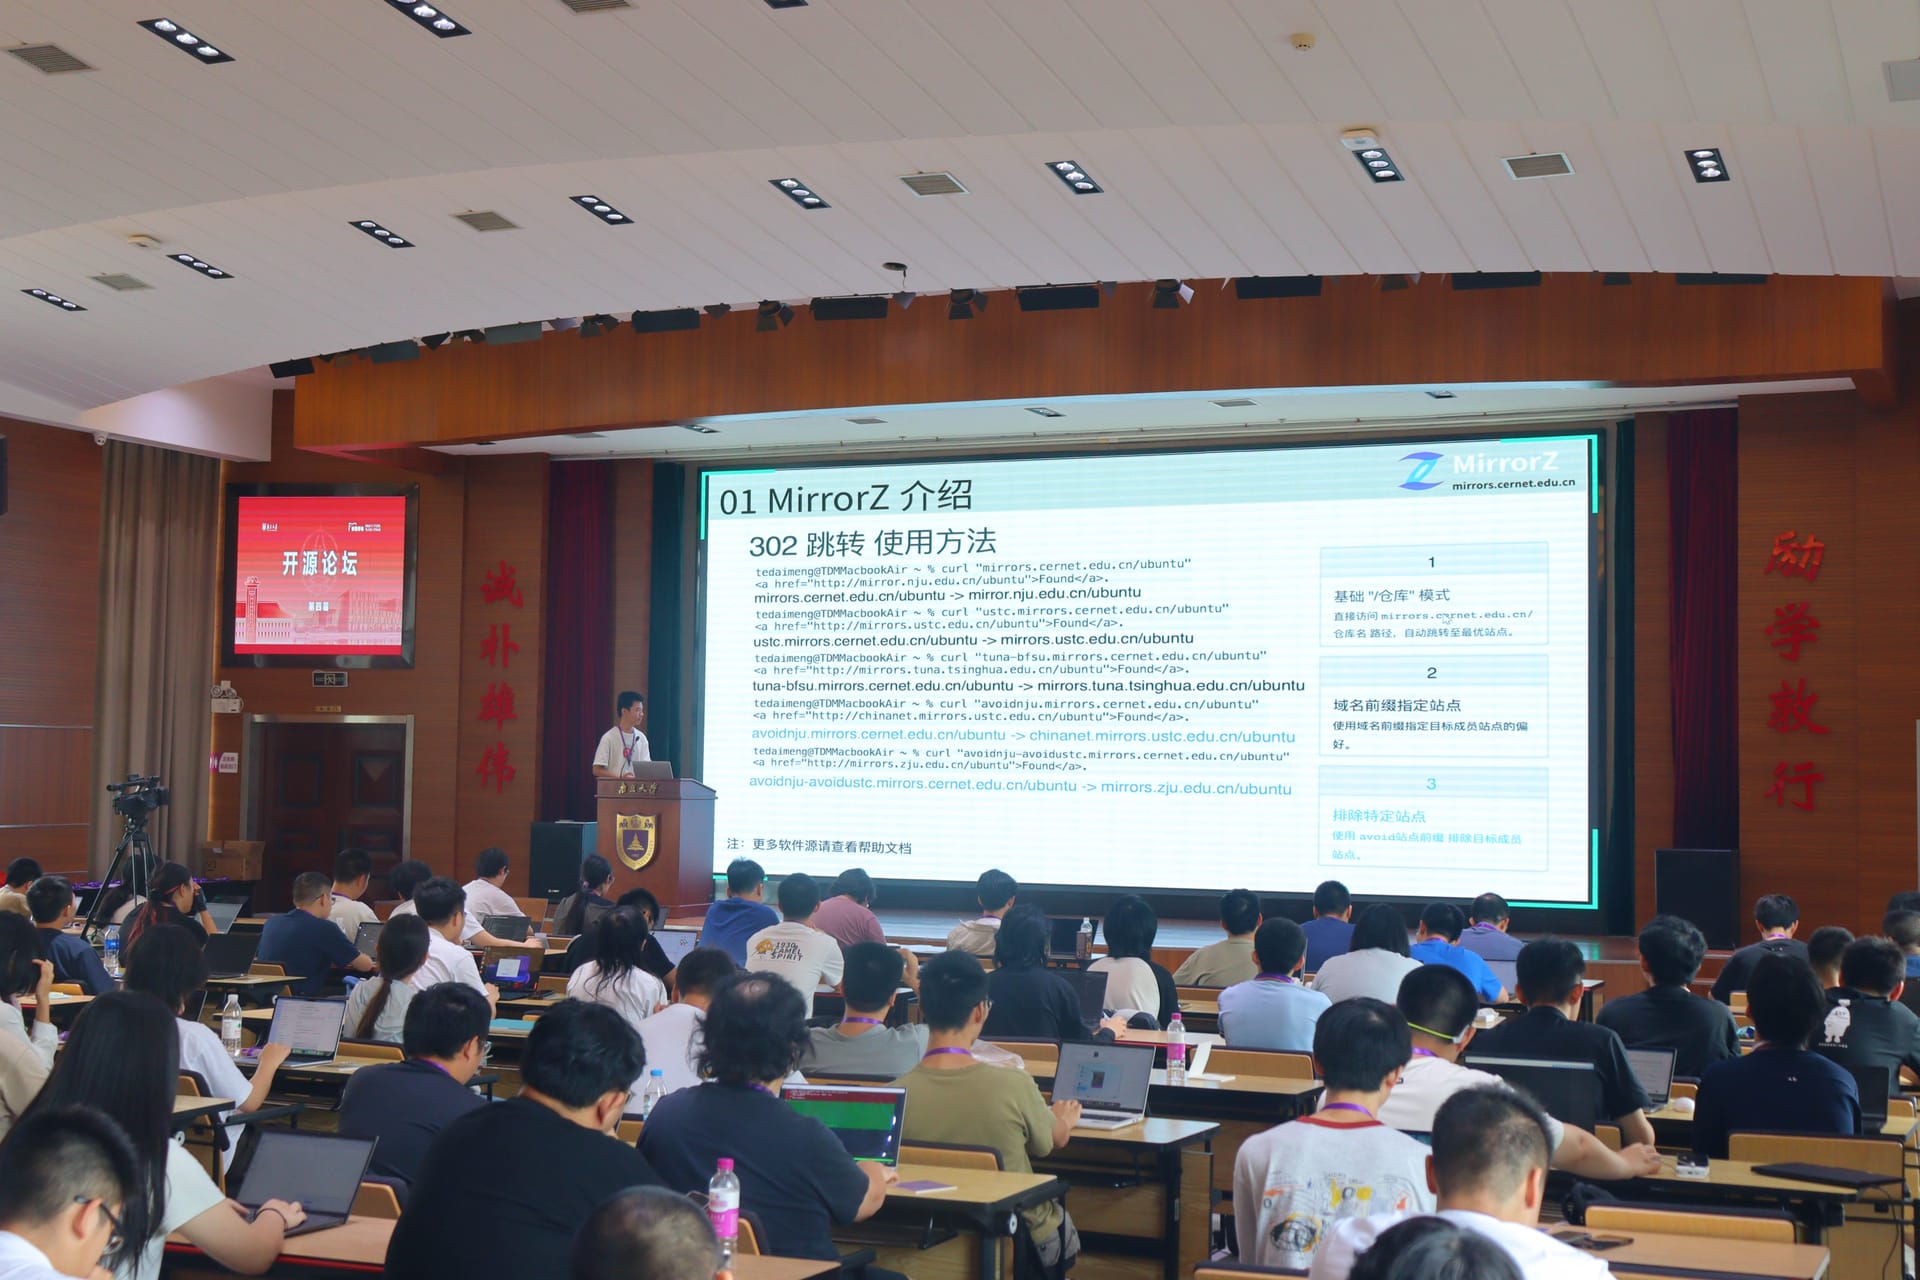
报告介绍了 MirrorZ 的三大功能:查看各站同步状态、跨站点搜索镜像仓库、统一帮助文档。同时,报告展示了丰富的跳转方法——通过域名前缀即可指定偏好站点,如:
ustc.mirrors.cernet.edu.cn/ubuntu或用 avoid 前缀排除站点。MC 模组社区 BMCLAPI 正是依靠各站 rsync 同步加 MirrorZ 智能跳转,分散了海量访问压力。
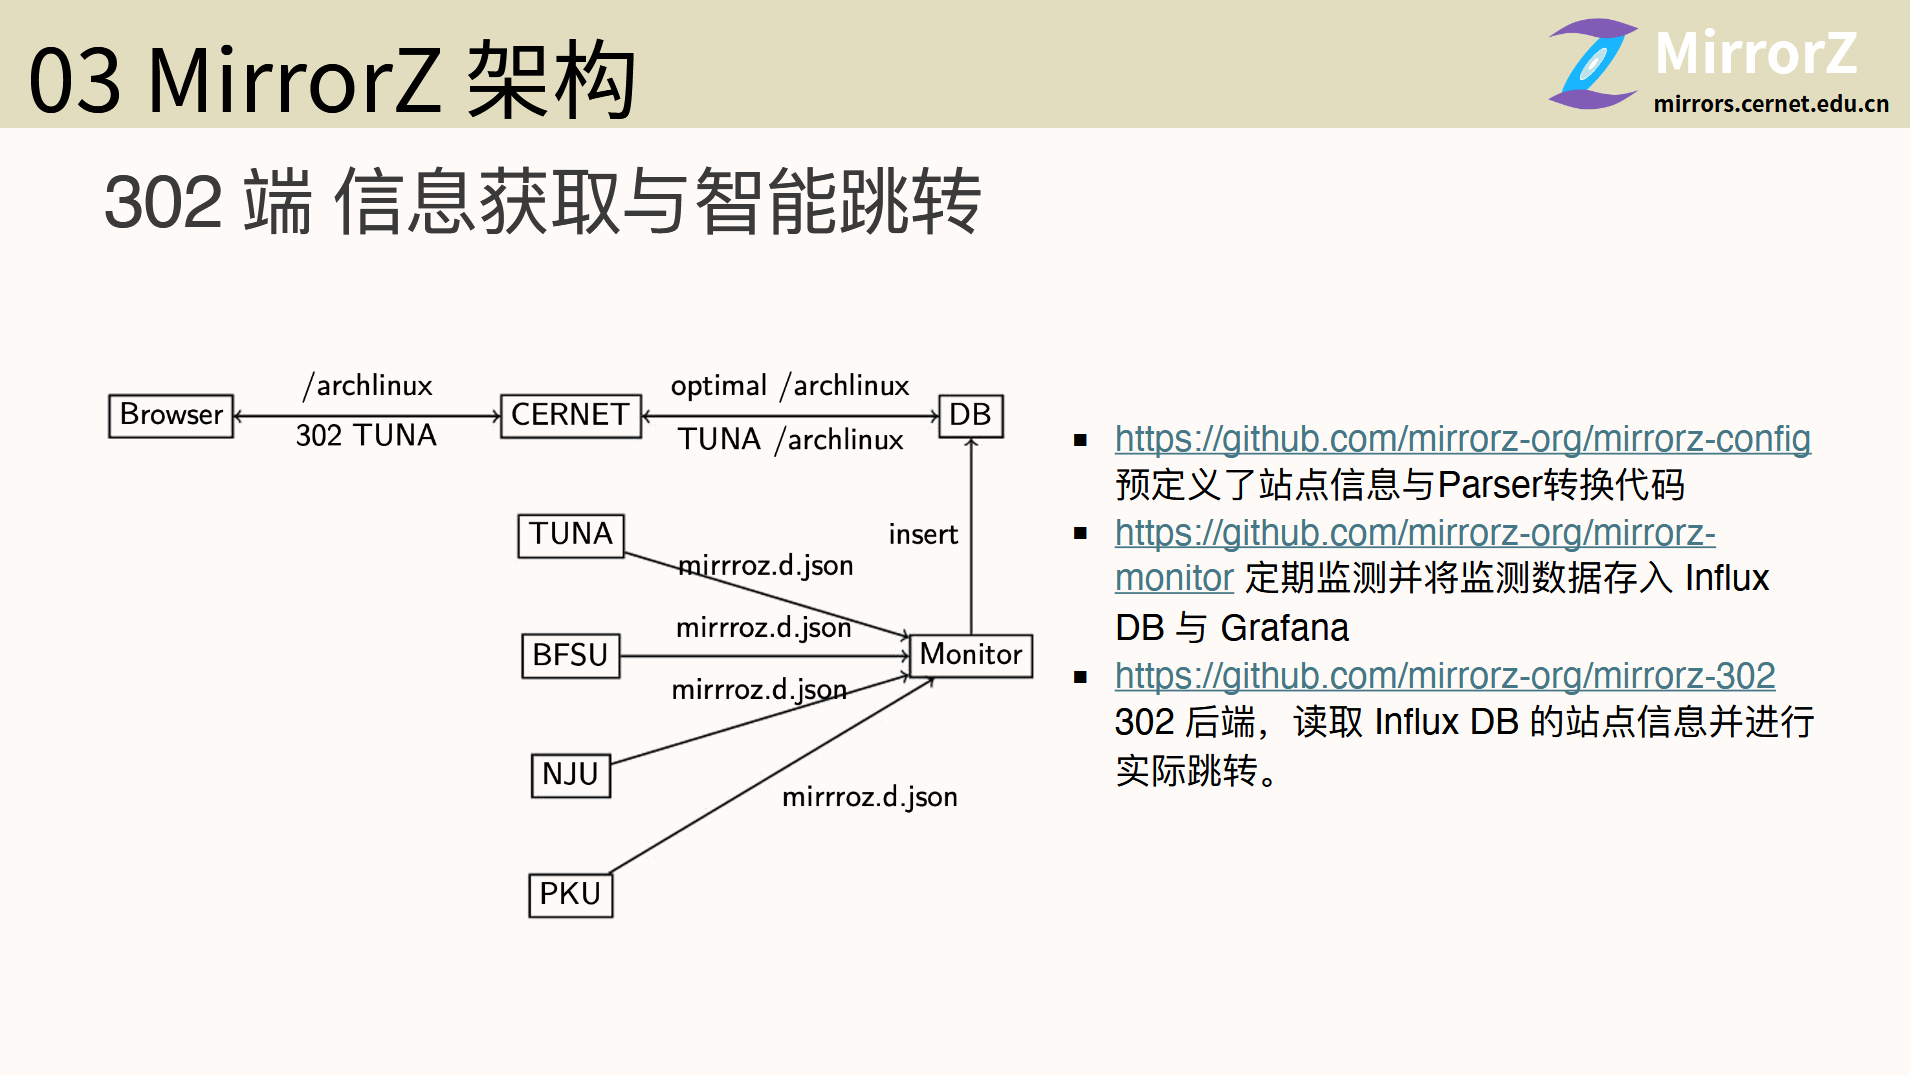
技术架构上,mirrorz-config 预定义站点信息与 Parser,mirrorz-monitor 定期监测各站状态并存入 InfluxDB + Grafana,mirrorz-302 读取监测数据,综合同步时间、IP 地理距离、IPv4/IPv6、校内 IP 段等因素执行跳转决策,“优中选优”。
报告回顾了 Mirroz 项目的诞生与演变,并介绍了近期 URL 路径重写、仓库健康监测与故障报告机制的规划。
关于 MirrorZ 的使用介绍请查看本站报道:教育网联合镜像站 MirrorZ 正式发布。
如何在镜像站里优雅地“点击房子”
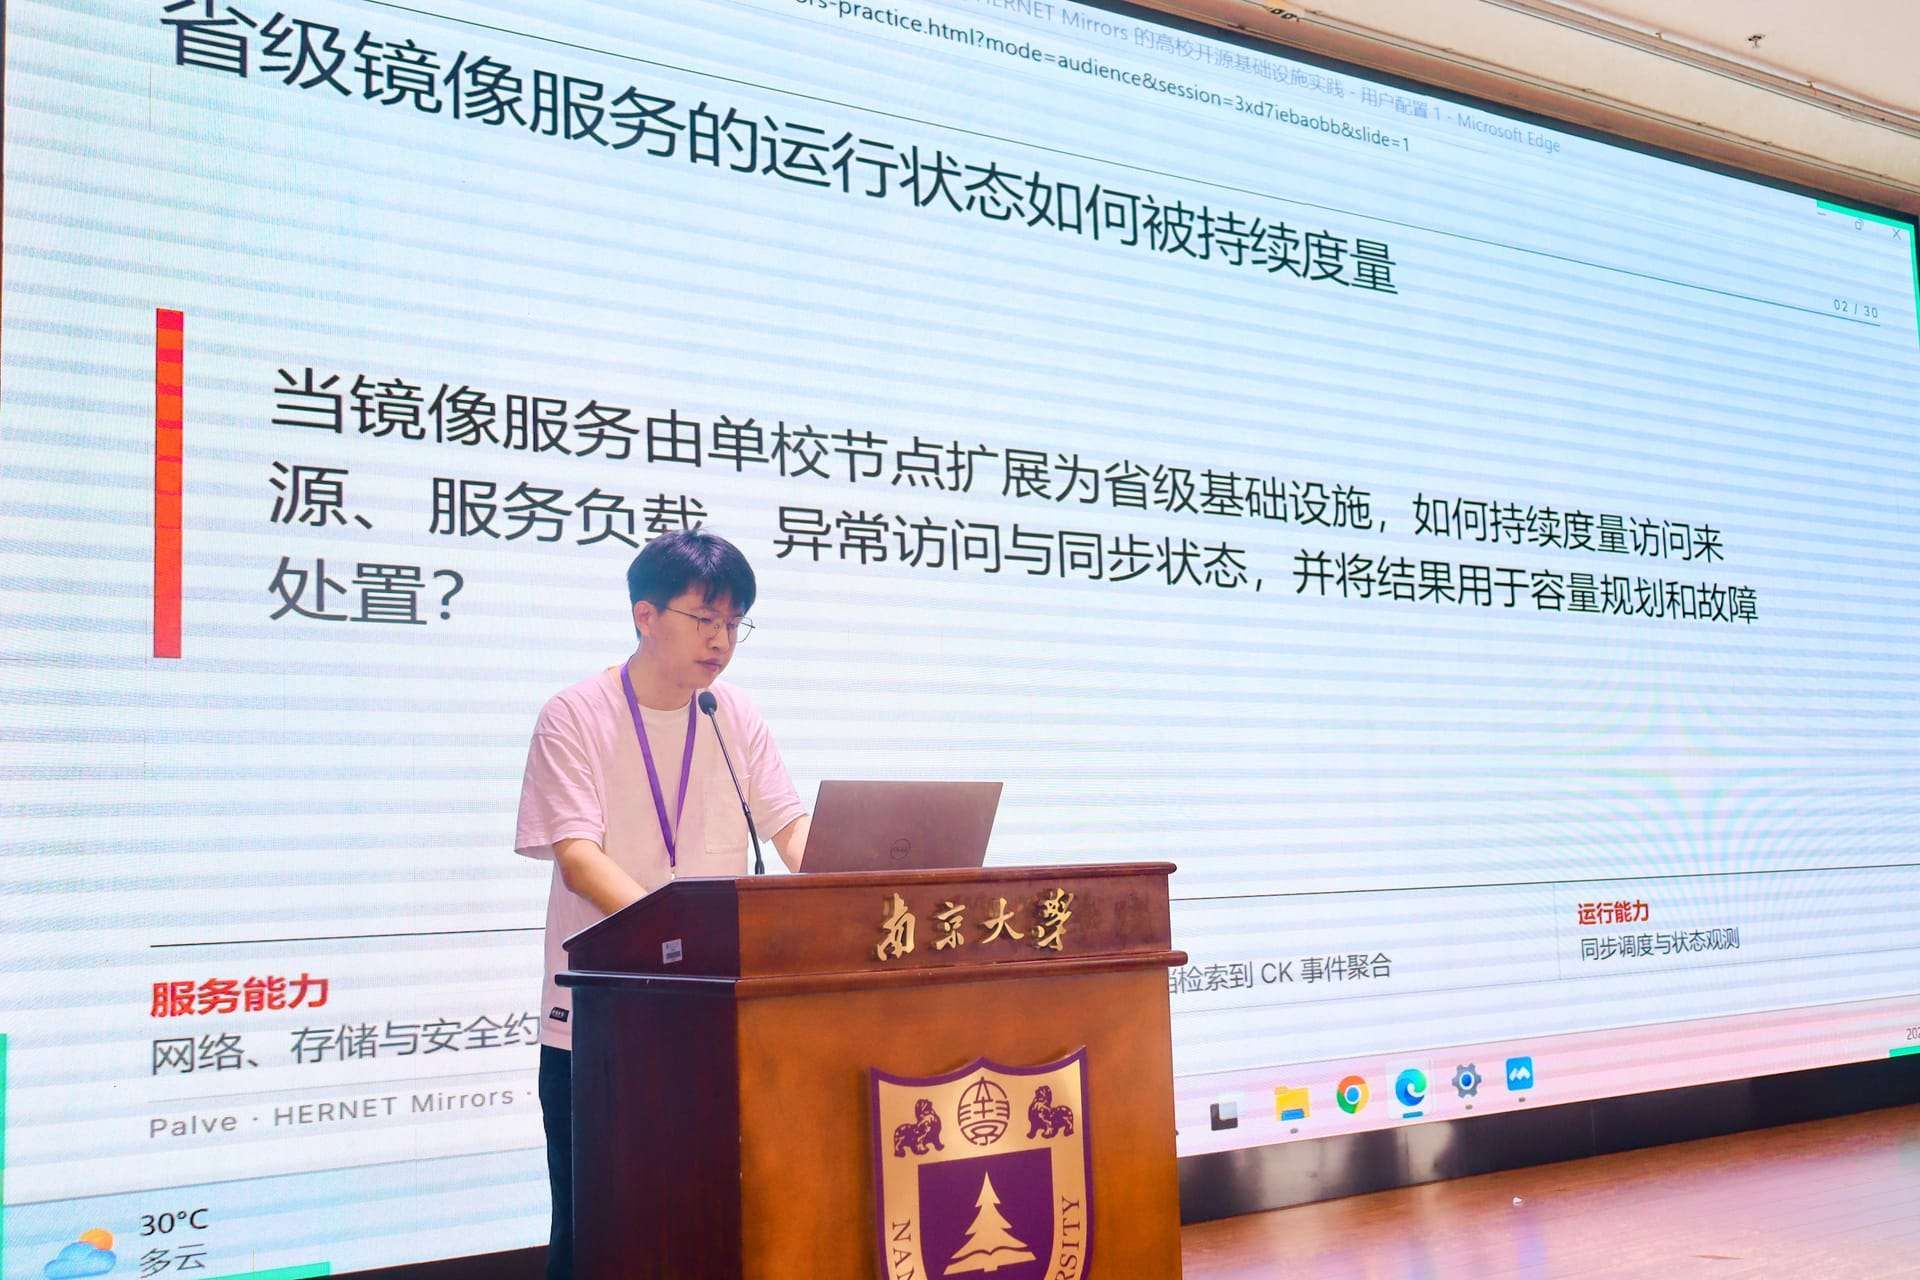
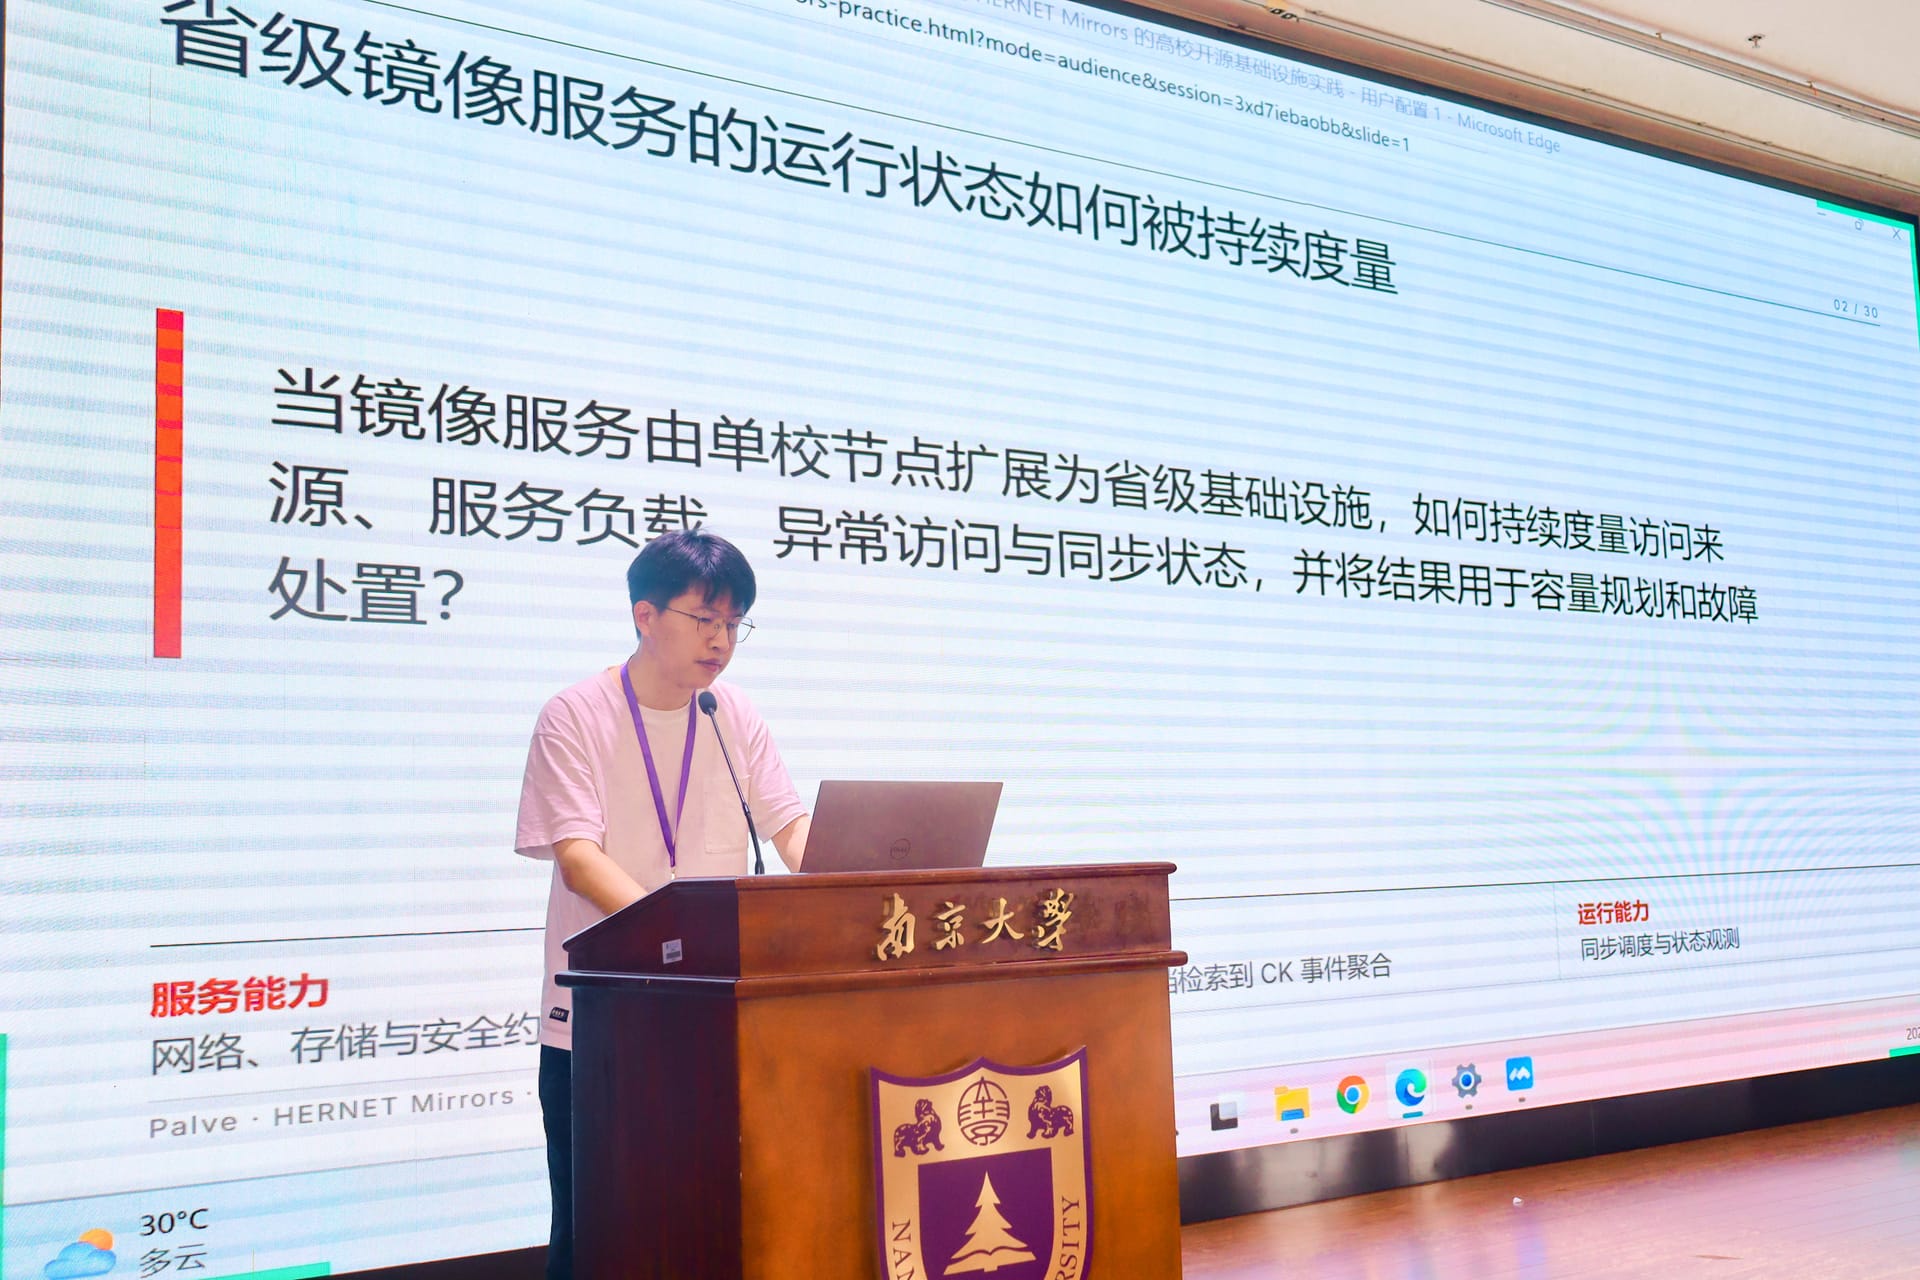
随后,HERNET Mirrors(河南省教育科研网镜像站)的潘富分享了从单校镜像服务(NYIST Mirrors)演进为省级开源基础设施的历程。如今 HERNET Mirrors 已具备教育网 20 Gbps 接入、IPv4/IPv6 双栈、300 TB 企业级 SSD + ZFS 全闪存储的生产规模。
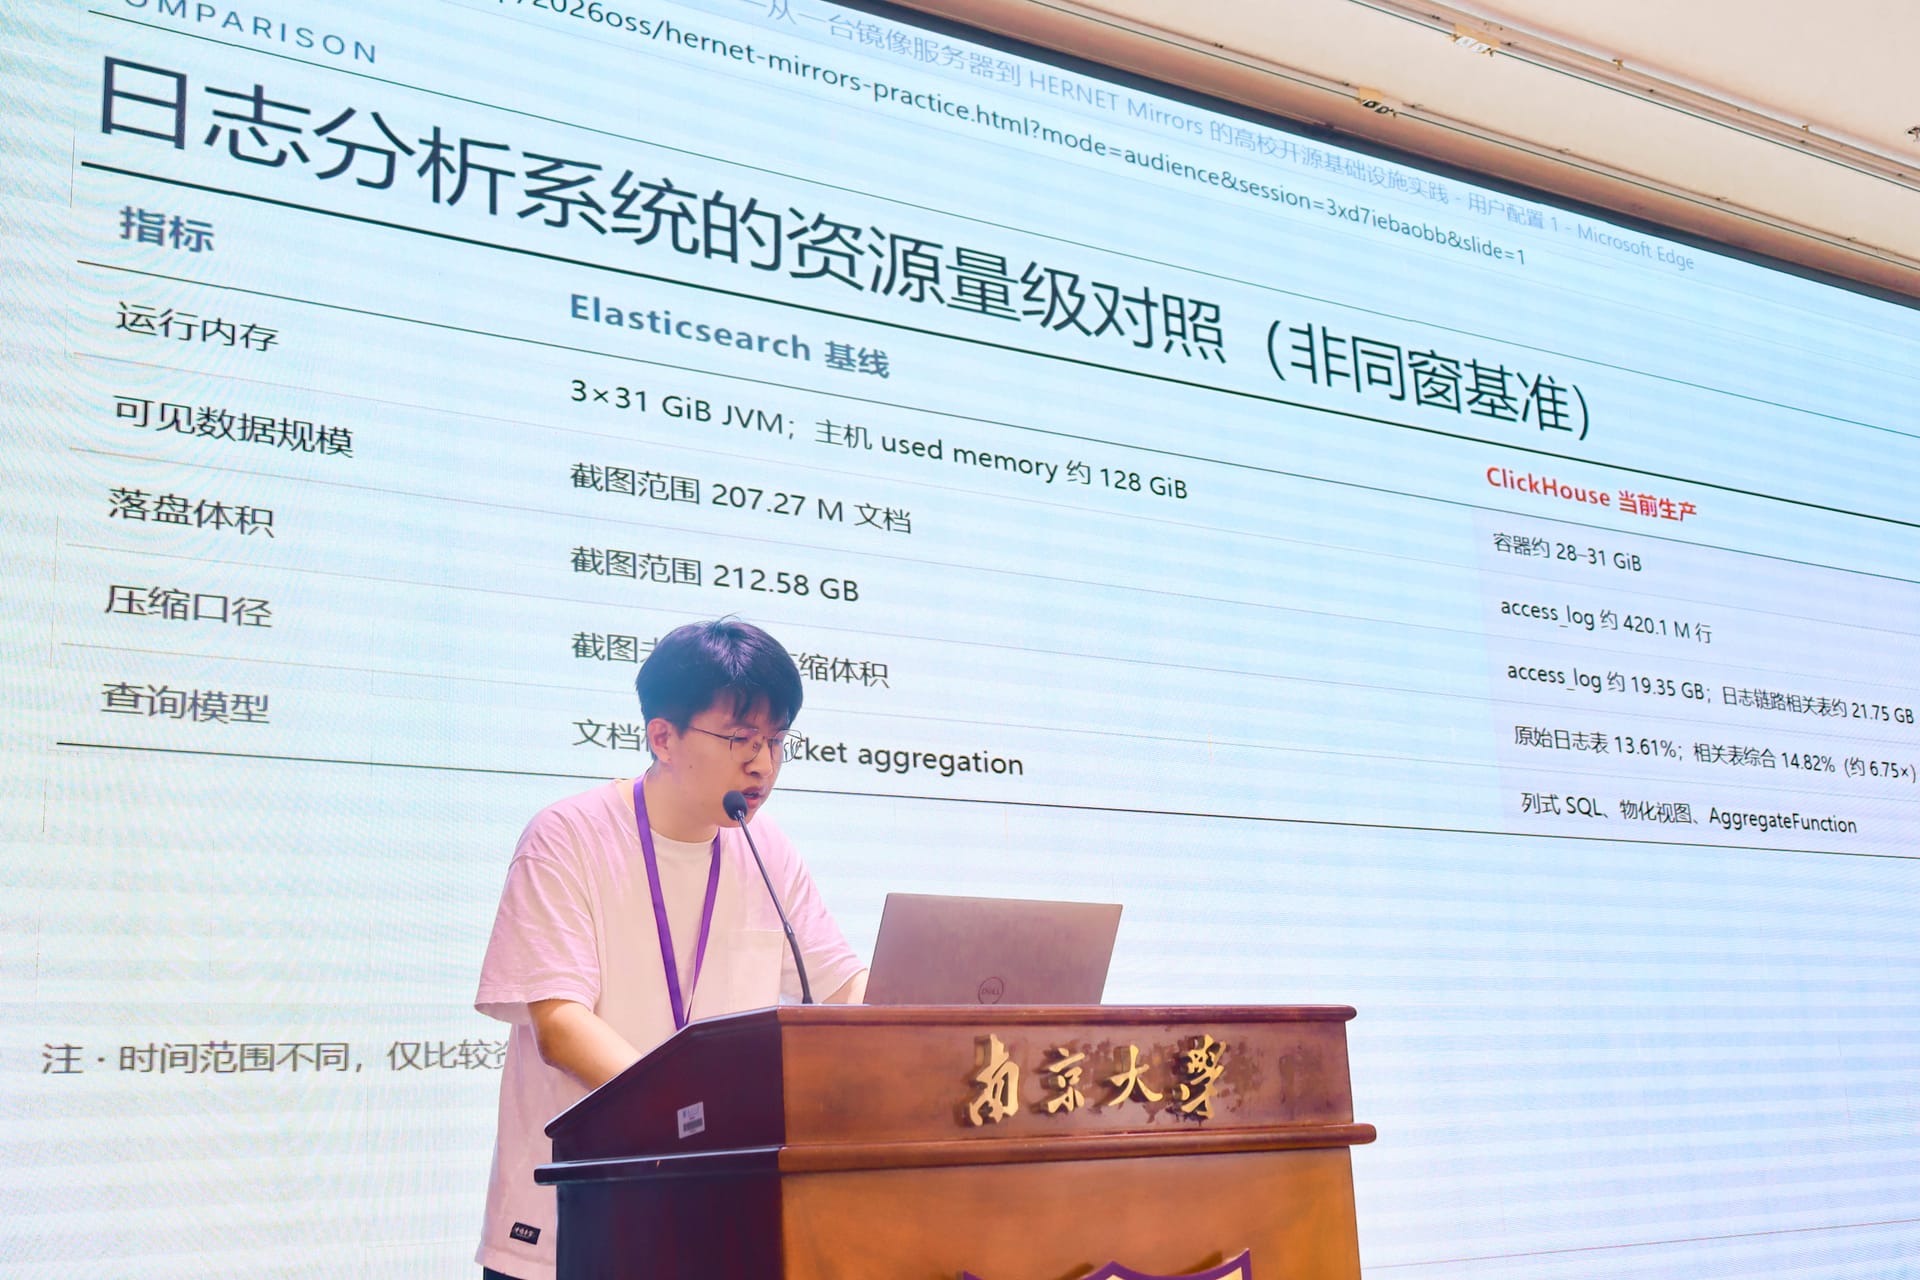
报告重点分享了日志分析系统从 ElasticSearch 迁移到 ClickHouse 的工程实践:原 ES 三节点各占用 31 GiB JVM,迁移后主机内存占用从 128 GiB 降至 40 GiB;ClickHouse 生产表 access_log 4.2 亿行仅占 19.35 GB。配合 30 秒预聚合的物化视图,24 小时查询加速 3.77 倍,PV/UV、出站流量、平均响应时间等核心指标实现实时监控——以 2026 年 8 月 20 日的生产截面为例,24 小时 PV 达 1490 万、出站流量 16.80 TB。
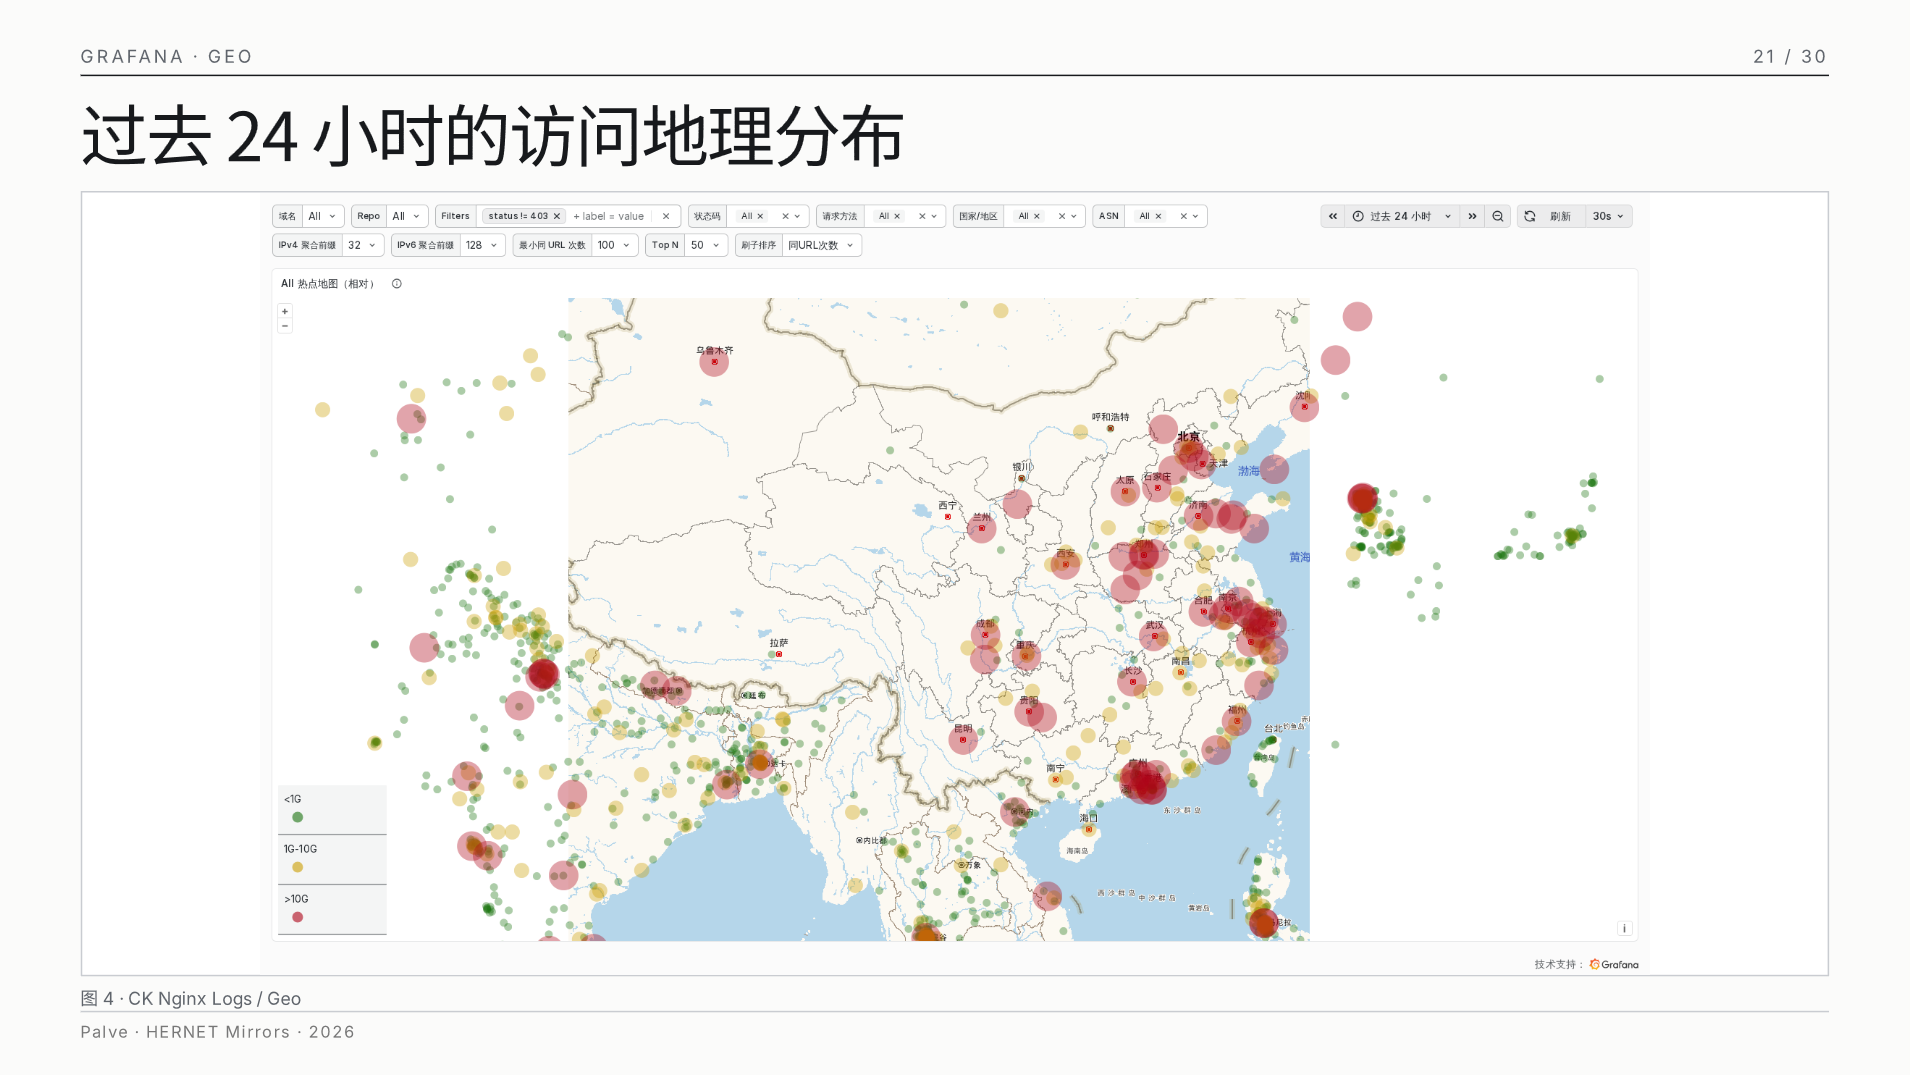
此外,报告还介绍了基于 Nginx ACL/Lua 的分层安全防护(POW 一次性票据、三档滑动窗口限流、四级流量窗口)与自研同步调度工具 Synora (github.com/Palvef/synora),实现访问、资源、同步的全链路可观测。正如报告所言:“这不仅是更换日志数据库,更是把网络、存储、安全、访问和同步转化为可核验的运行记录与处置依据。”
镜像站云原生FS与可观测性实践
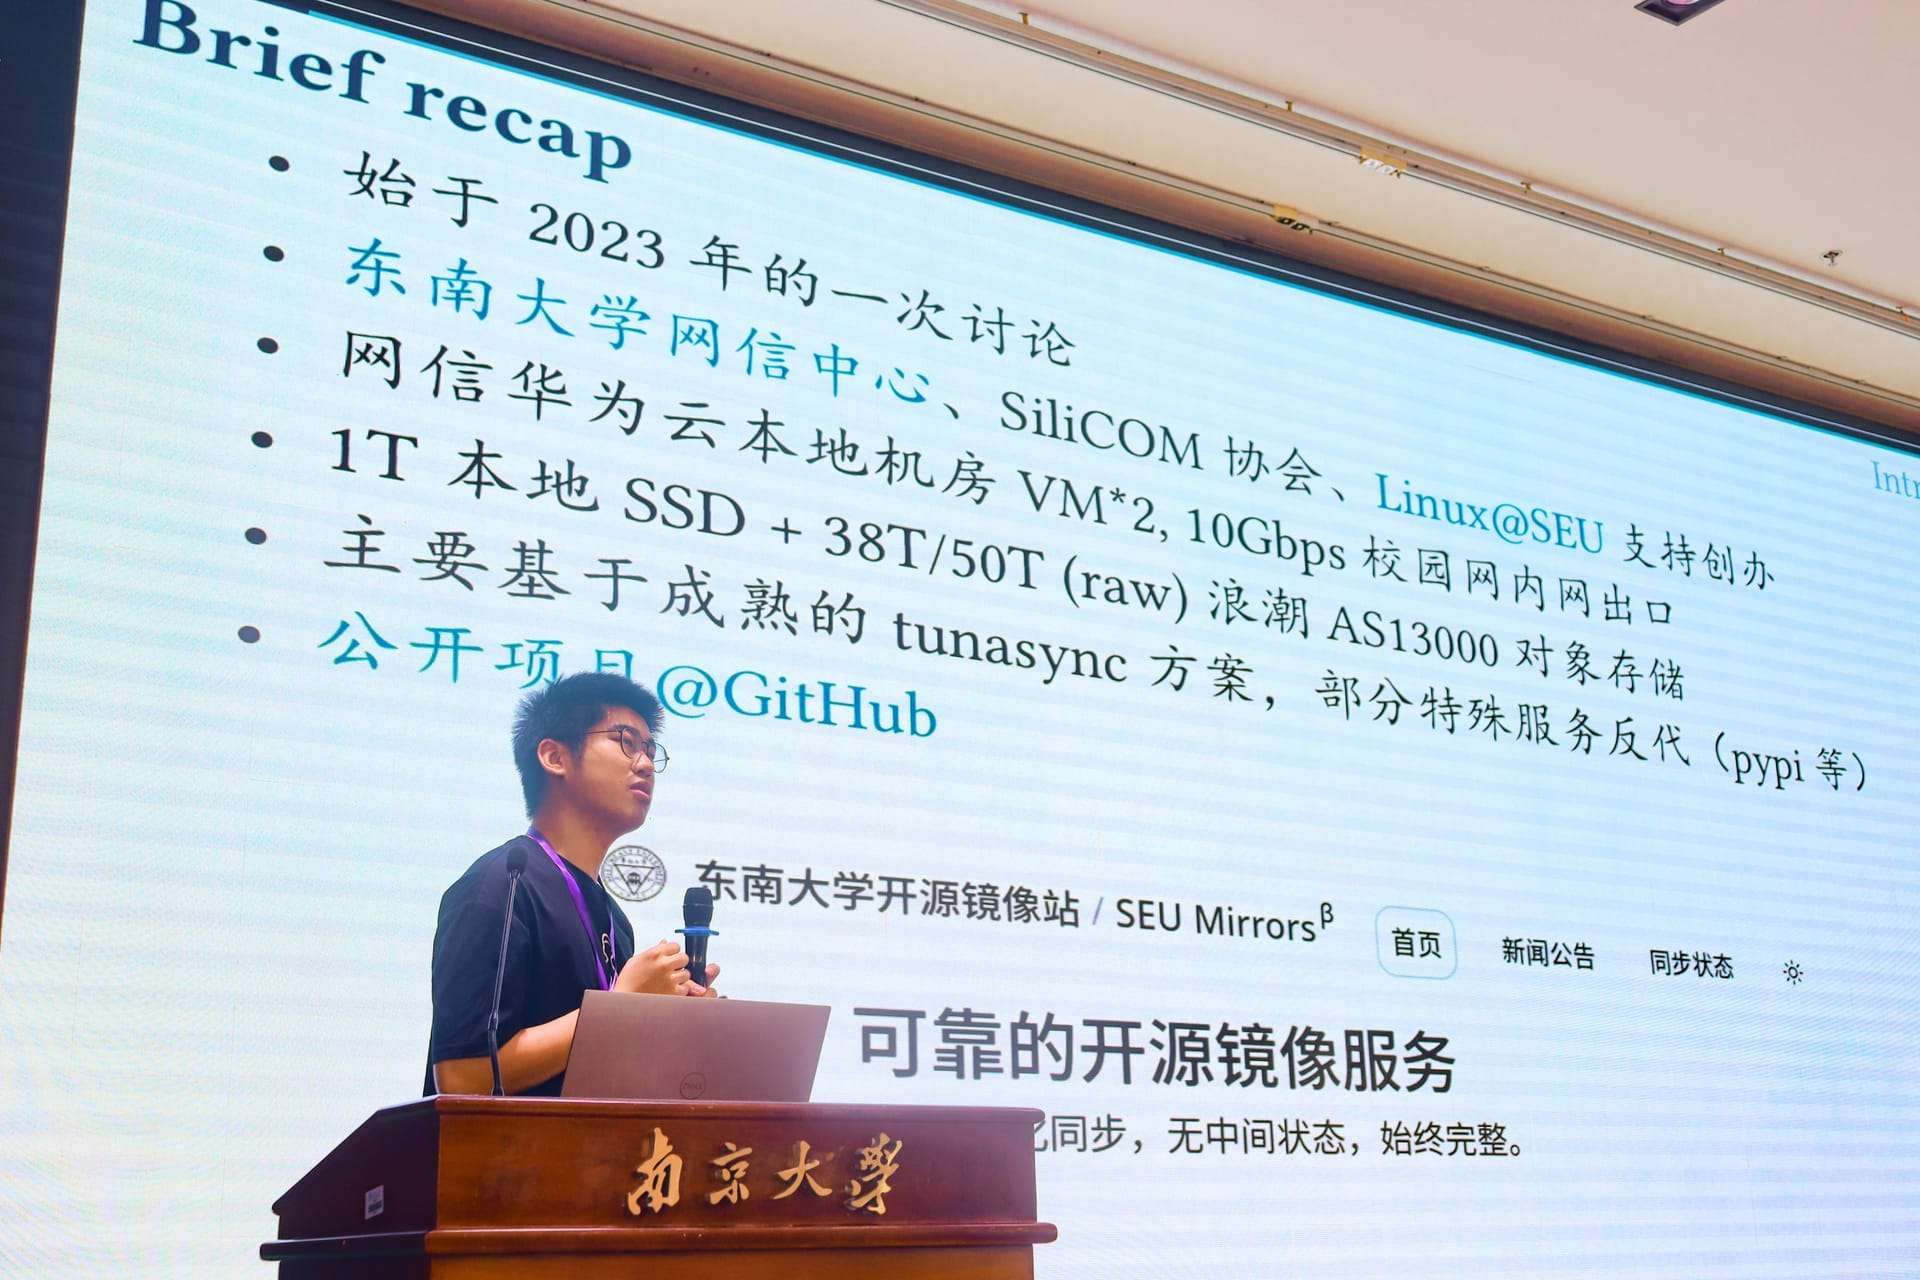
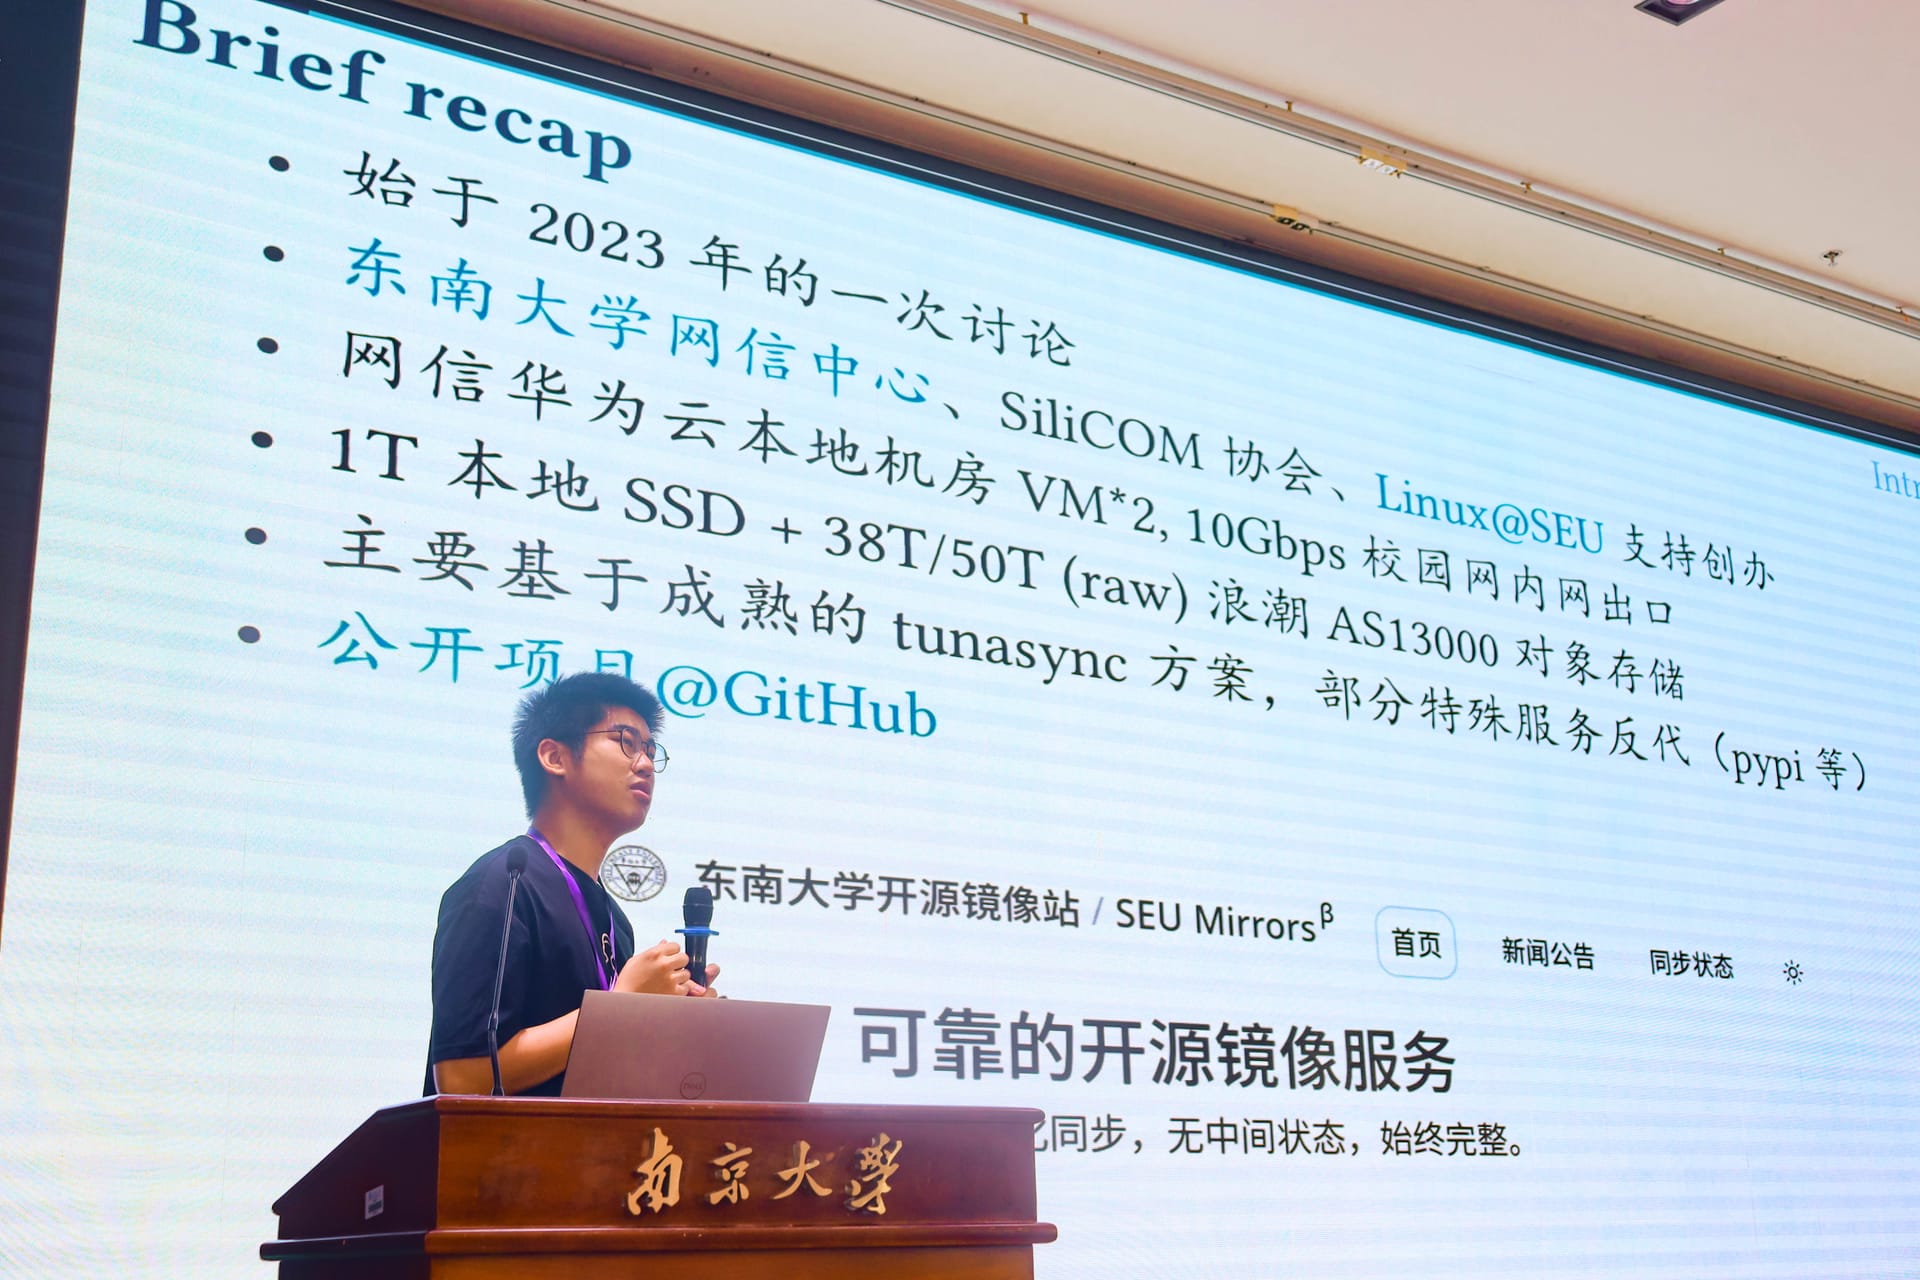
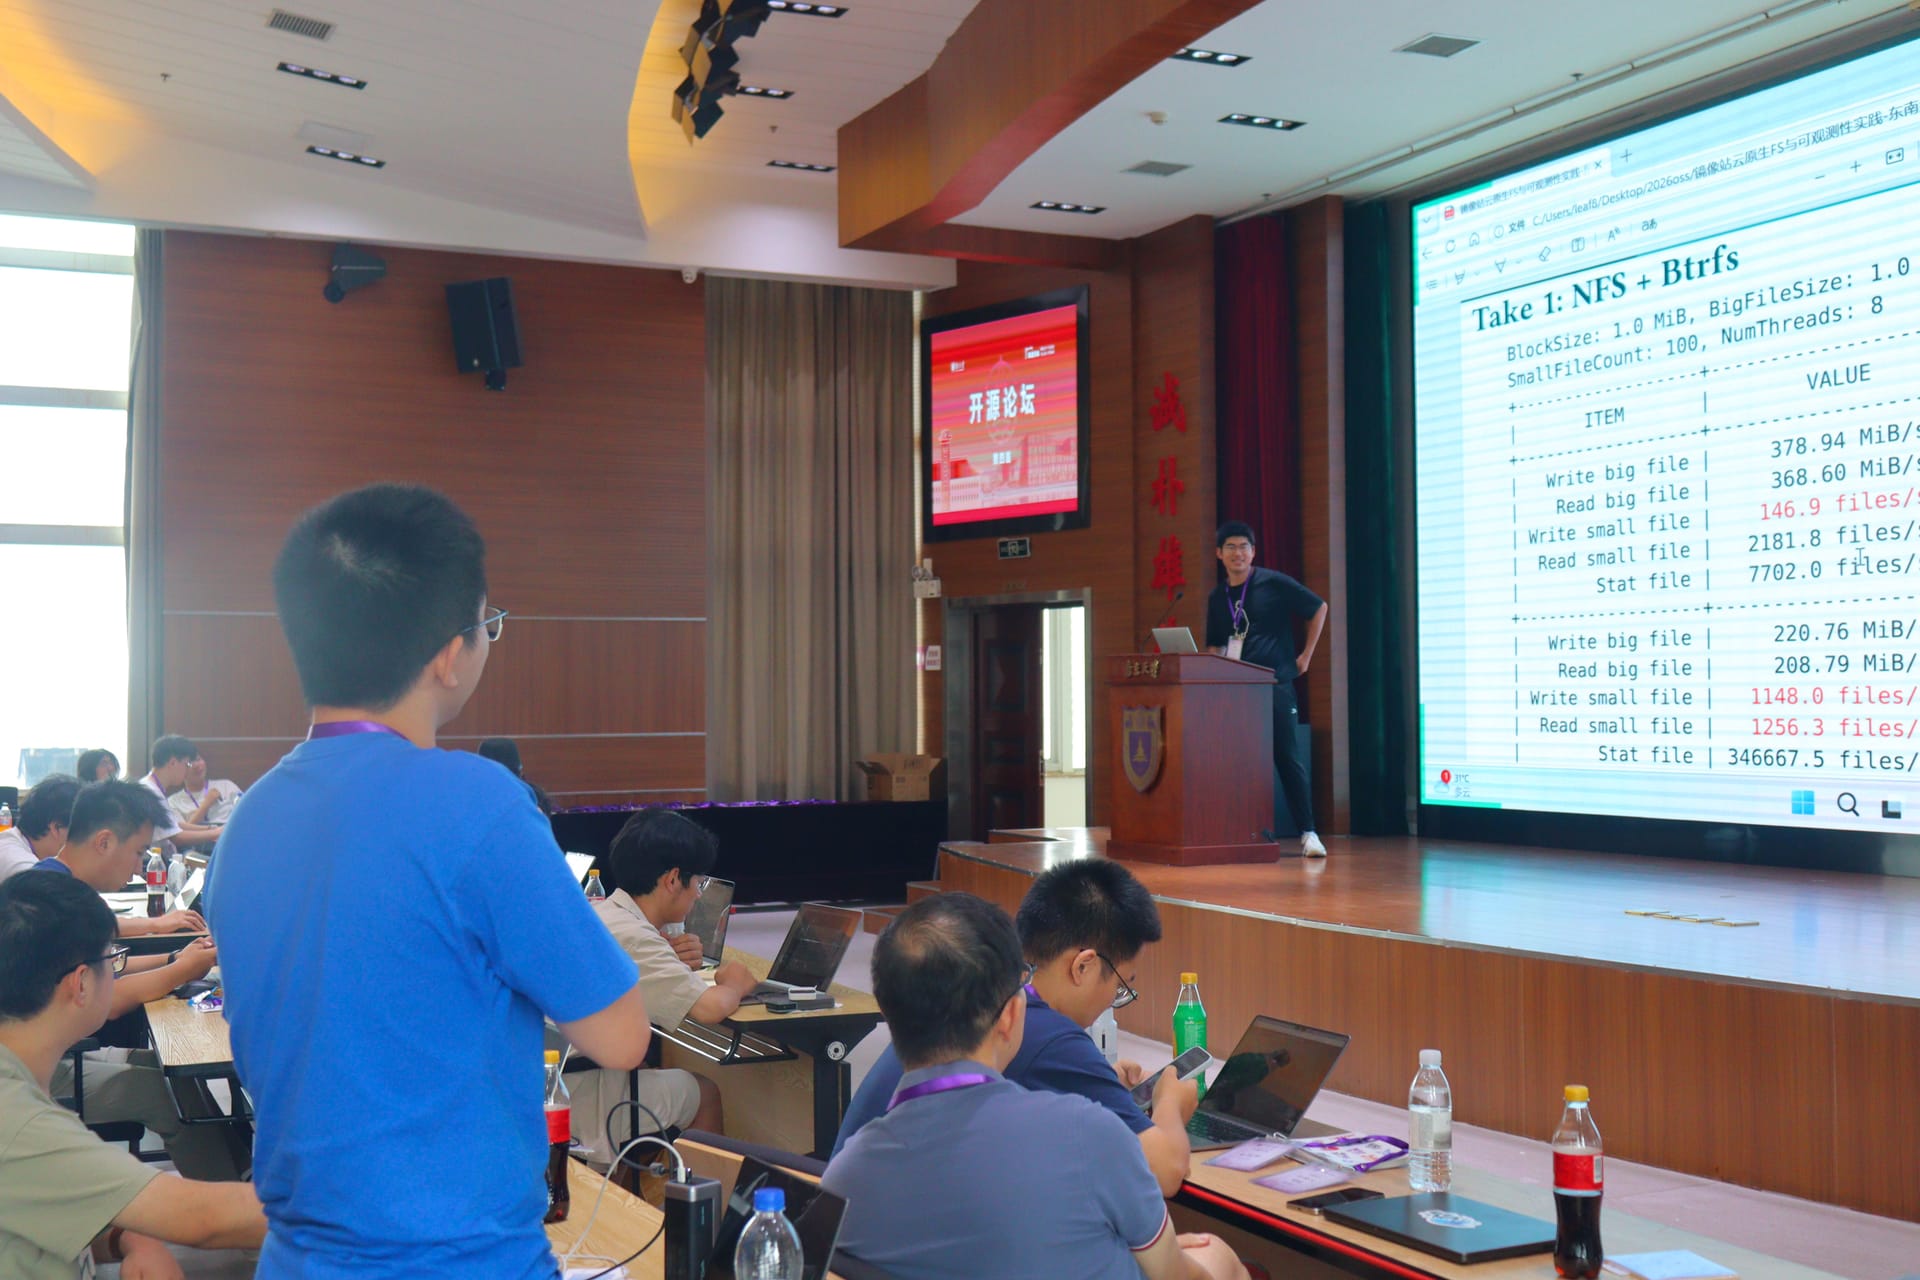
东南大学 SEU Mirrors 的尚子焜则带来了一份“踩坑与复盘”含量极高的报告。在无裸块存储、仅有 CIFS/NFS/S3的约束下,东南大学镜像站经历了 NFS+Btrfs 到 dm-cache 缓存再到 JuiceFS 的文件系统选型三部曲:NFS 上套娃 Btrfs 因小文件写延迟高达50毫秒被弃用,最终转而采用新方案 JuiceFS ,将元数据与数据分离并原生支持缓存,小文件读性能达到了 5964.7 files/s(裸 NFS 仅 2181.8)。
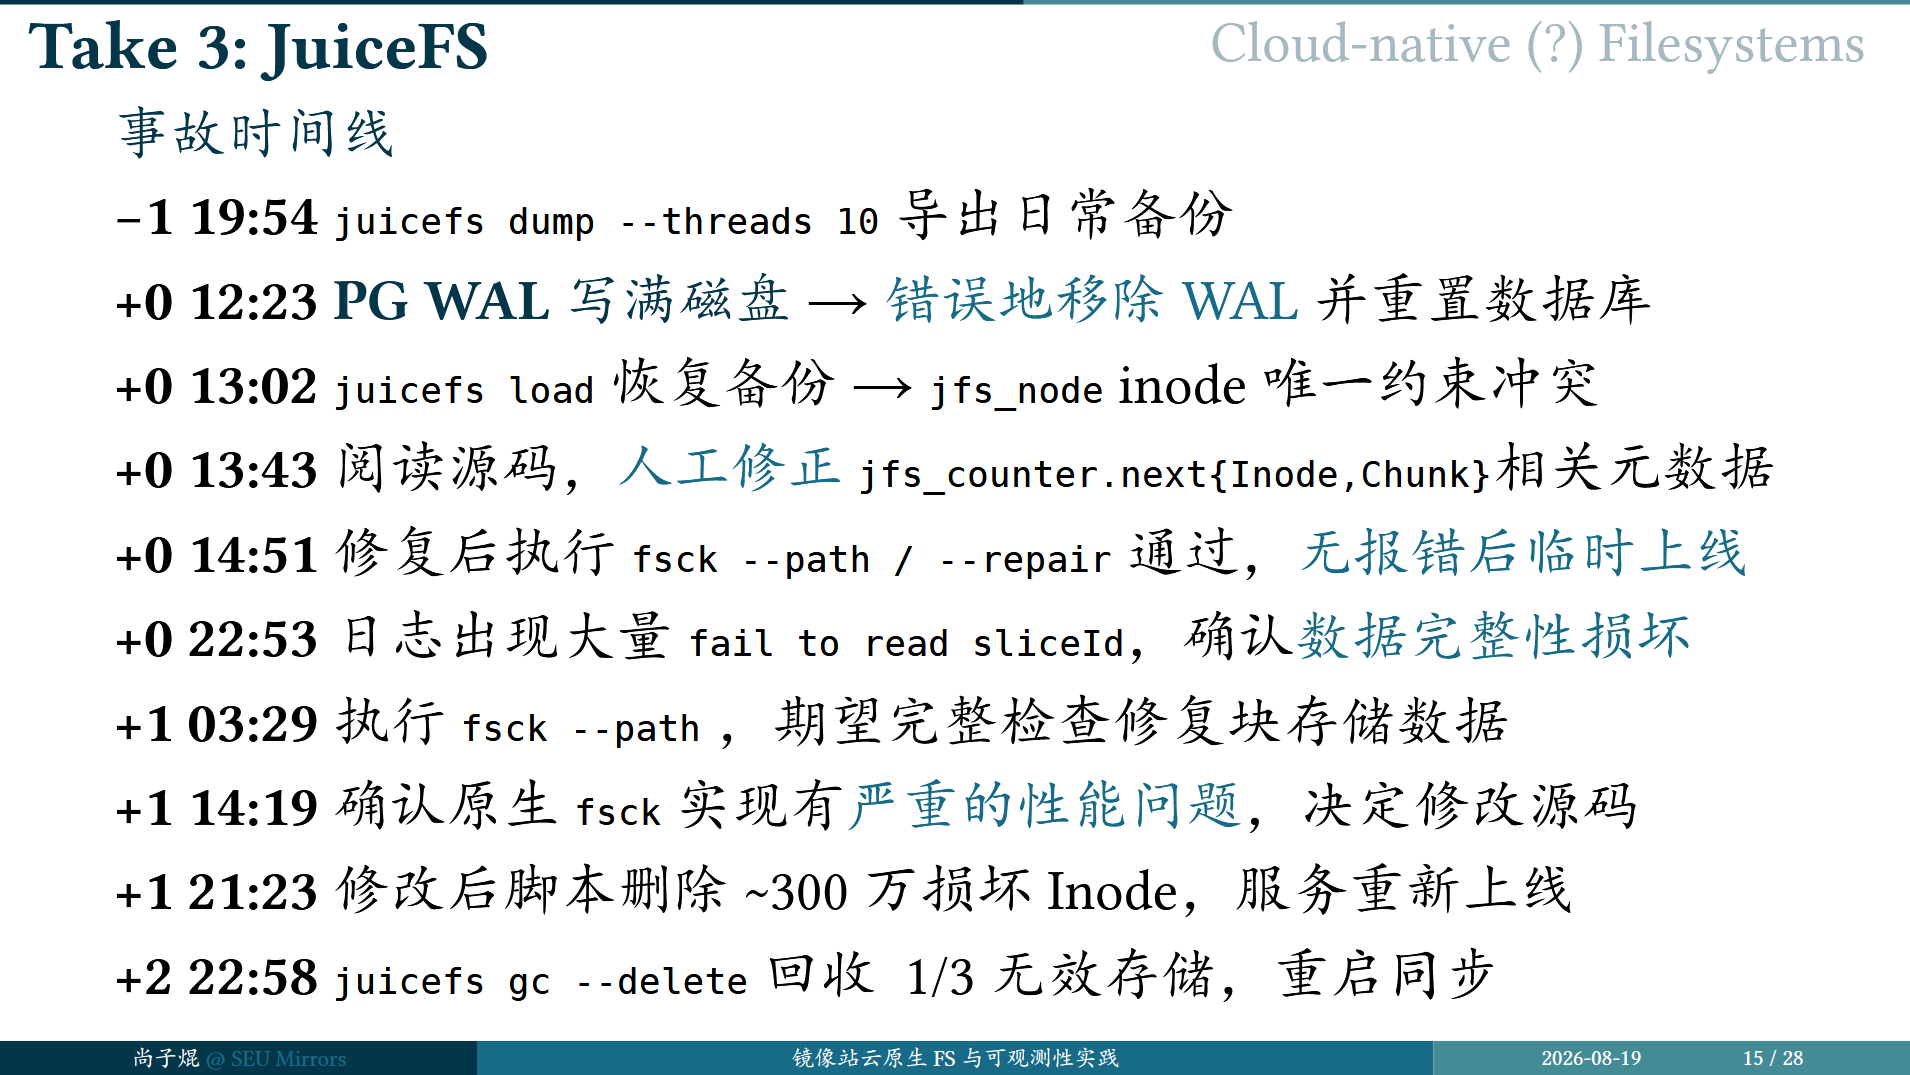
报告最引人入胜的部分是一次生产事故的完整复盘:迁移 JuiceFS 过程中,因轻信其原生元数据备份功能,数据库故障时才发现多线程备份存在一致性问题——约 20 TB 数据、1100 万 Inode 中损坏约 300 万,服务中断 1.5 天,最终靠修改源码、fsck 与 gc 回收无效存储才得以恢复。尚子焜总结了事故的教训:永远不要依赖上层应用作为主要灾备手段,优先保证底层引擎(DB)高可用;阅读代码,而不是依赖常识和假设;同时,他还指出,可观测性建设能更早/好地发现问题。
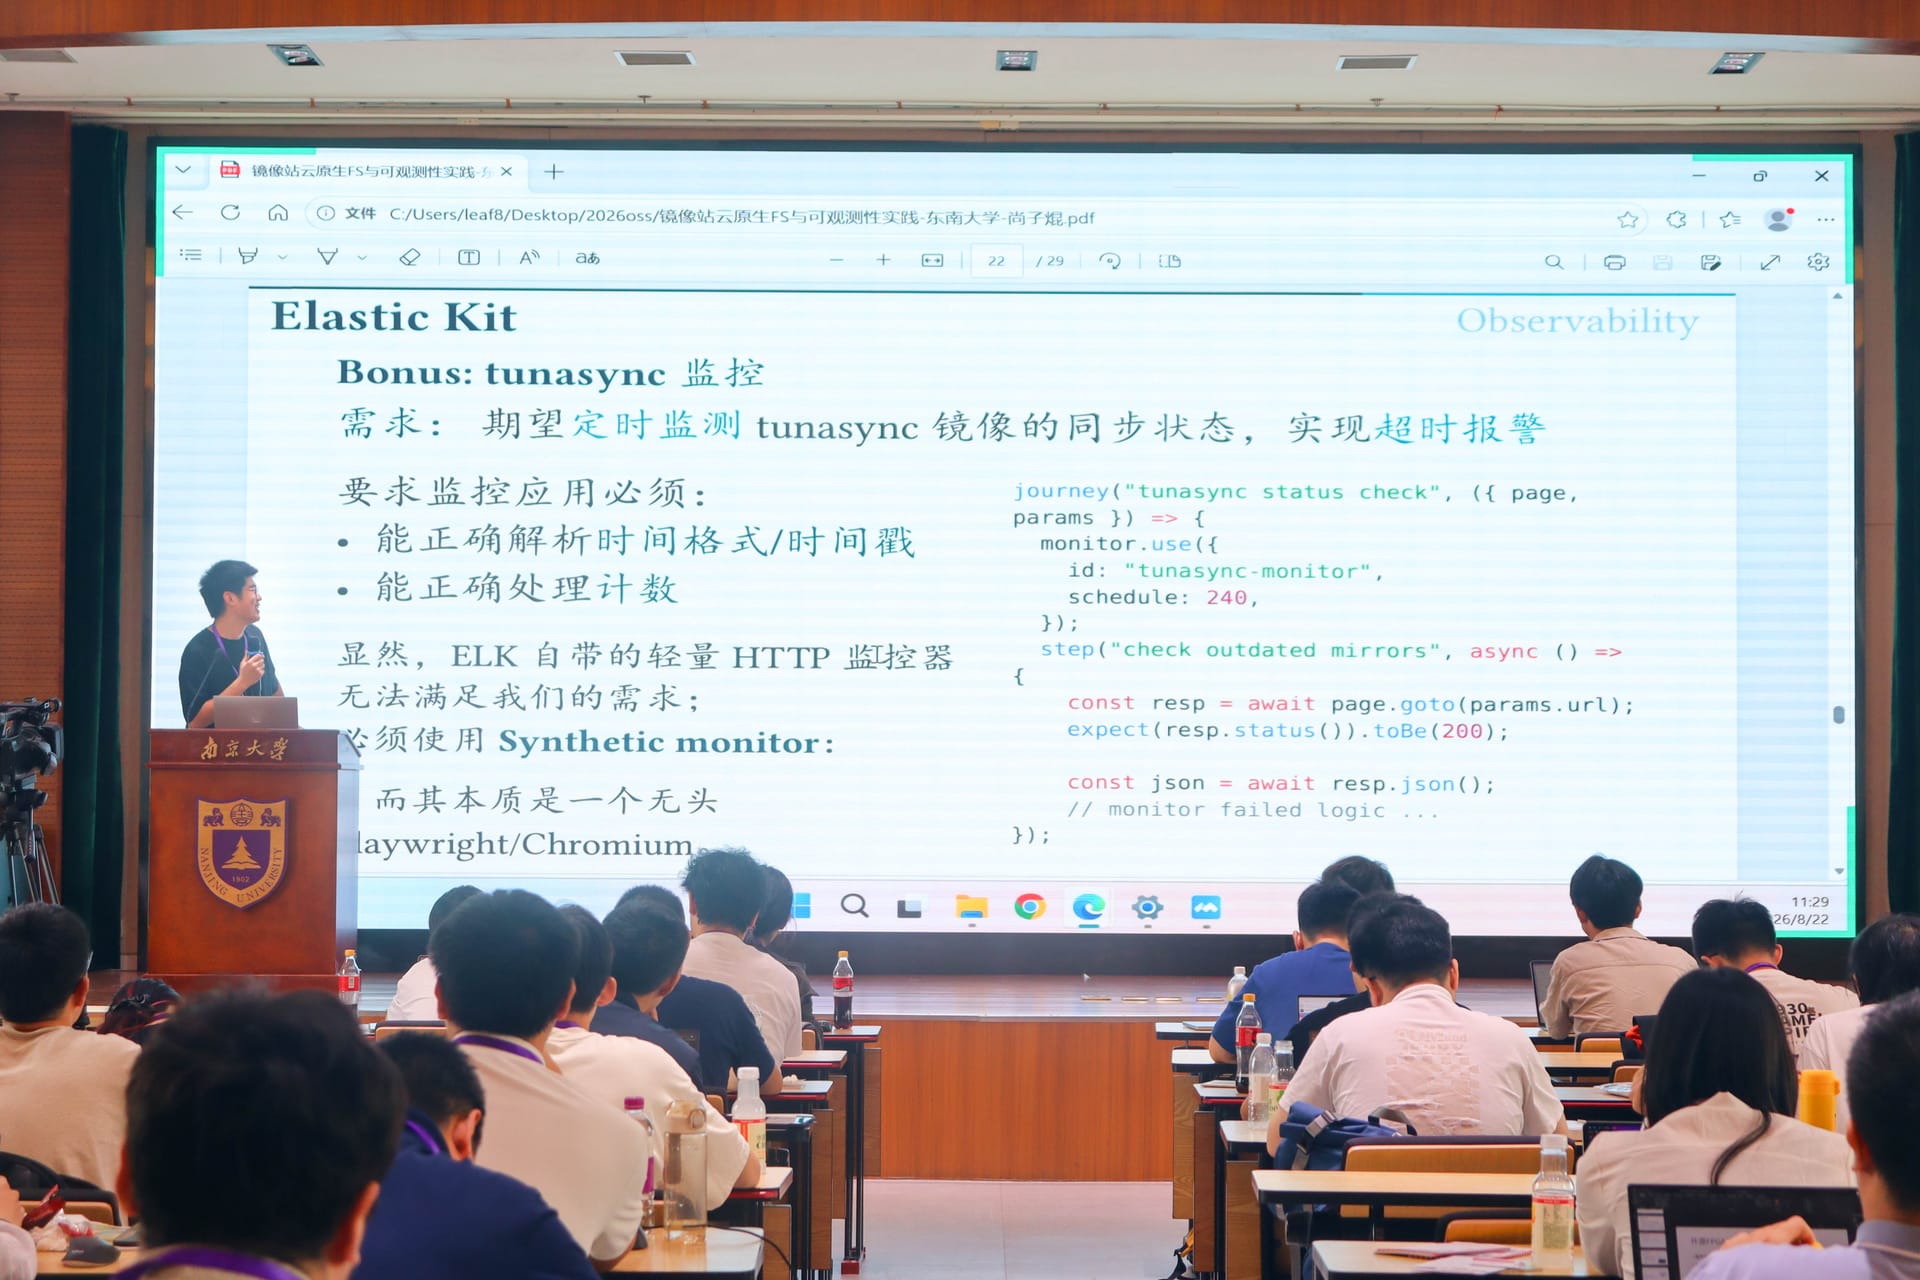
接续这一洞察,报告最后还分享了 ELK 与 Prometheus+Grafana 双栈可观测性建设经验,并展望了 TimesFM 异常检测与只读 Agent 等 AI 时代站点可靠性工程的新课题。
面向全球用户的网络优化实践
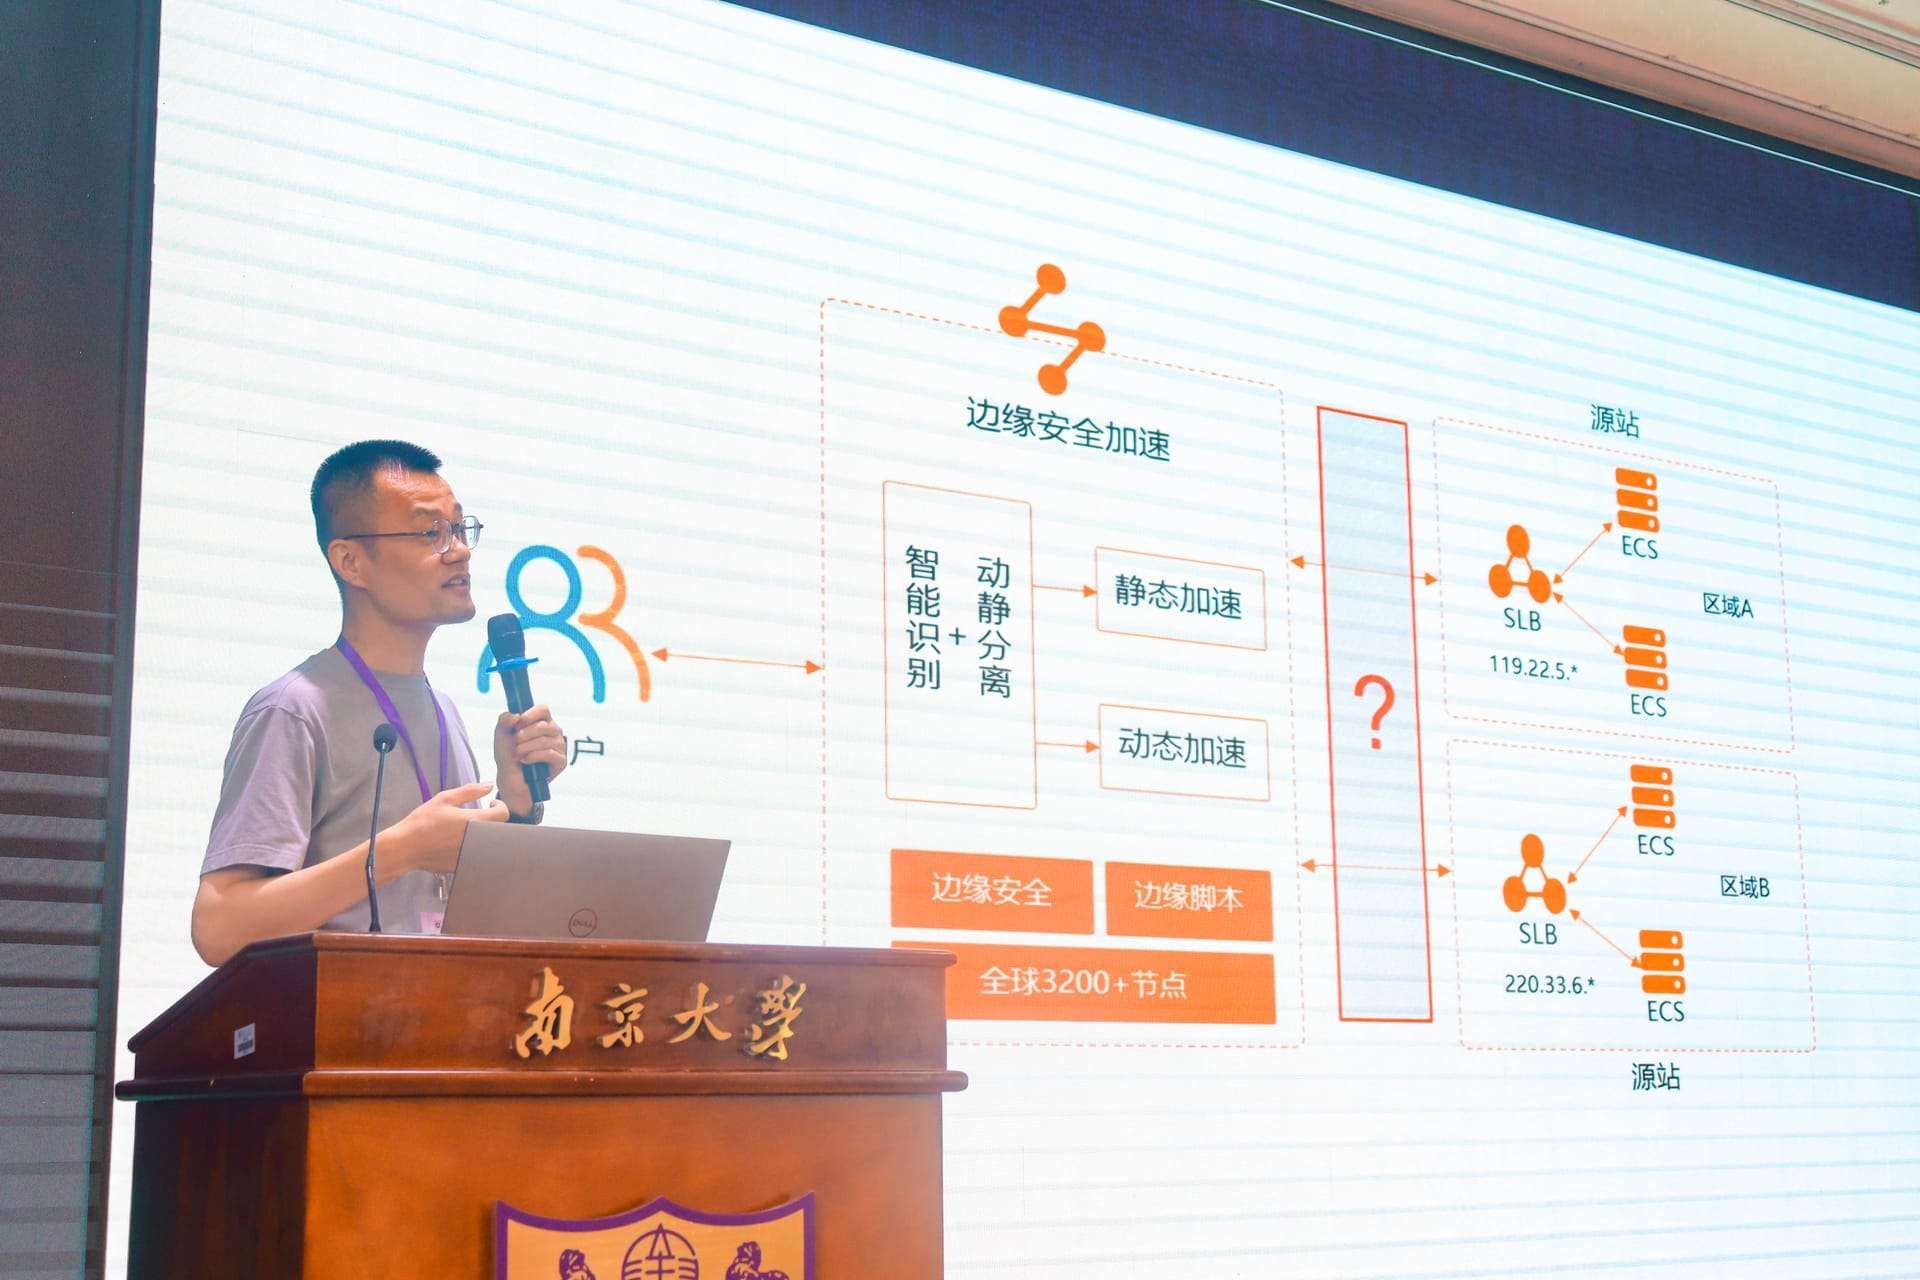
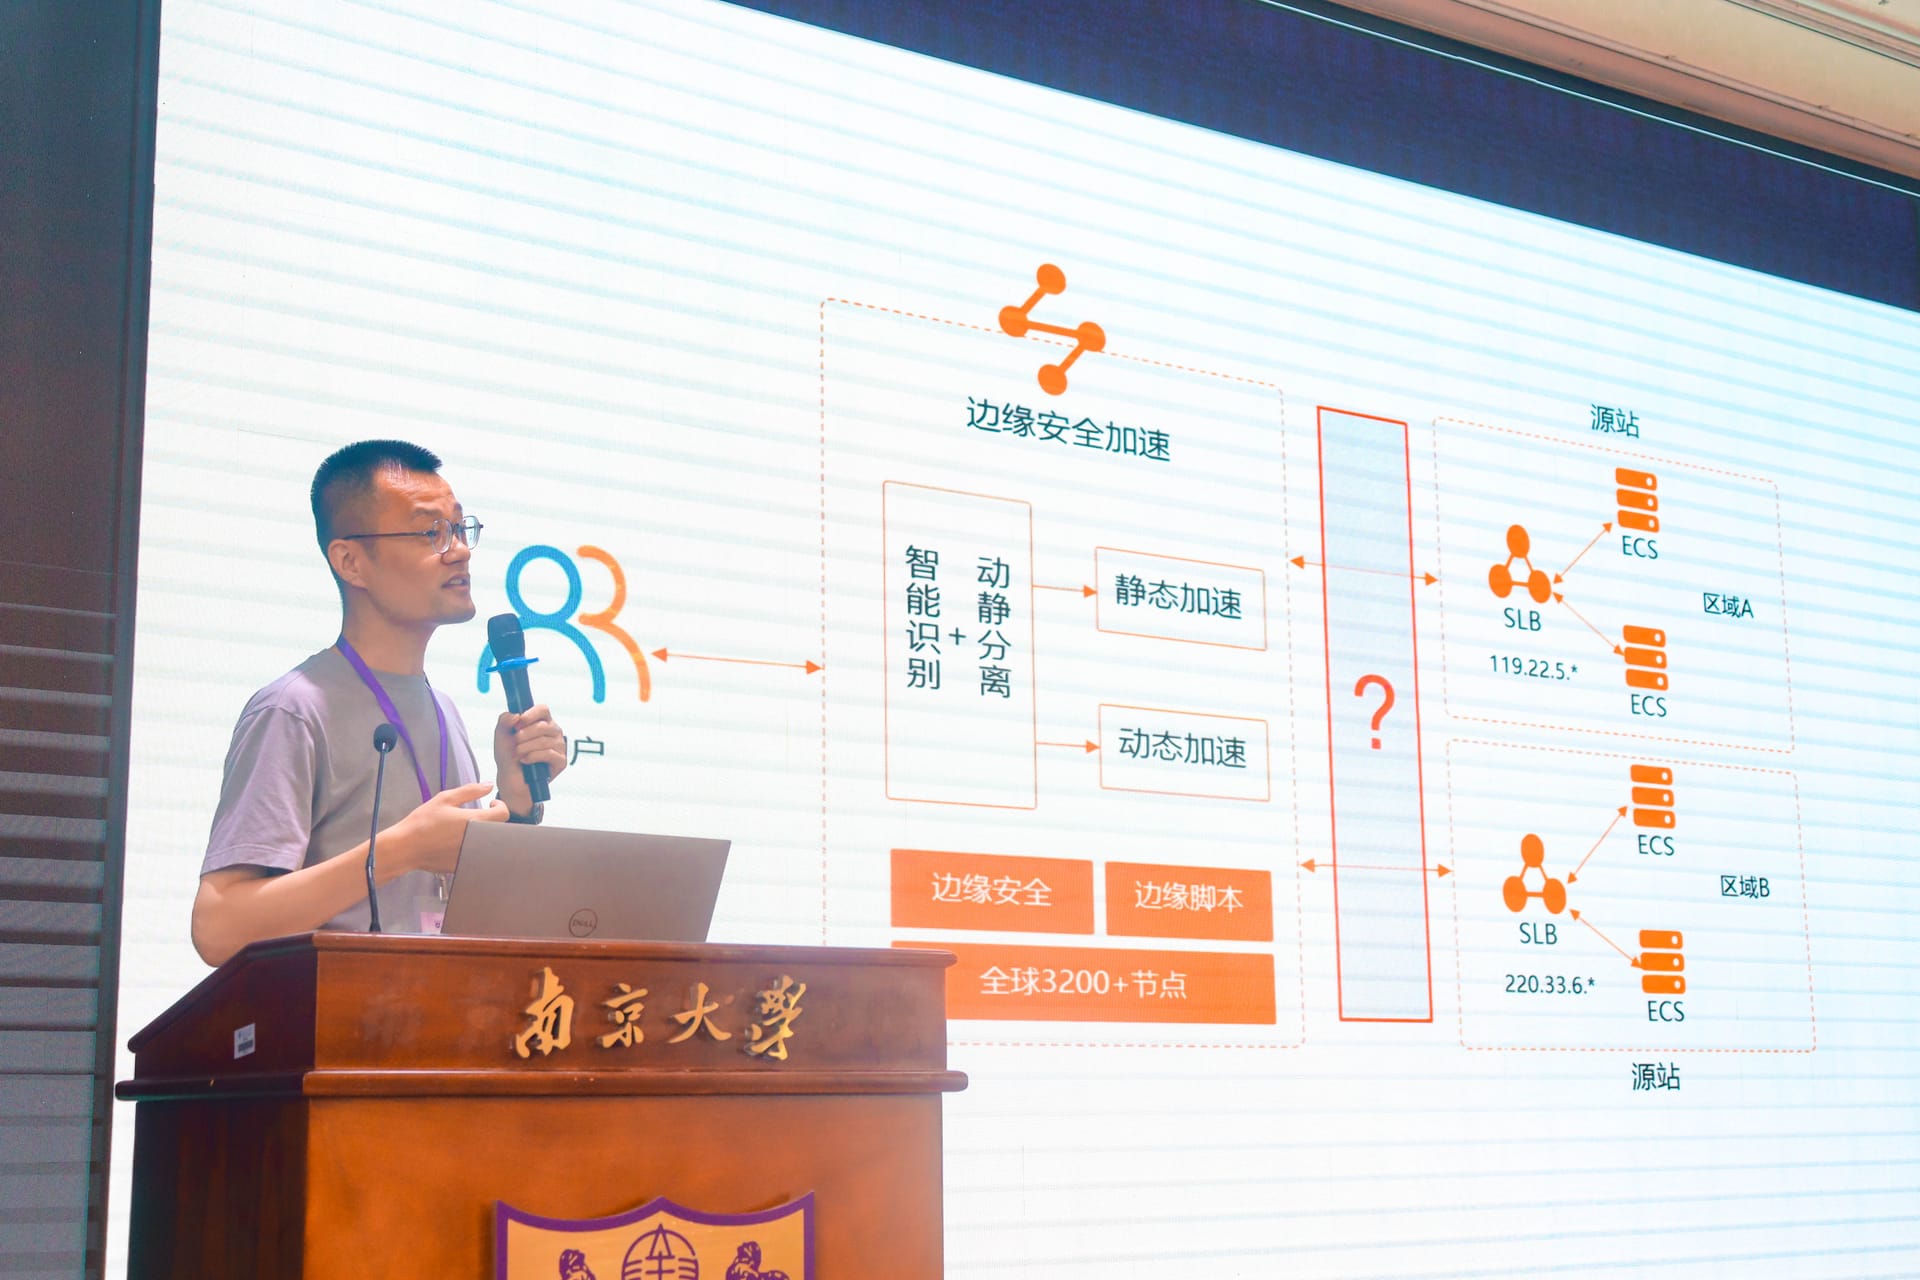
TeXPage 创始人穆佃舜的报告从海底光缆与跨境网络的特殊性出发,指出全球网络优化不是简单的就近部署或接入 CDN,而是要建立可观测、可调度、可容灾、可控制成本的全球访问体系。
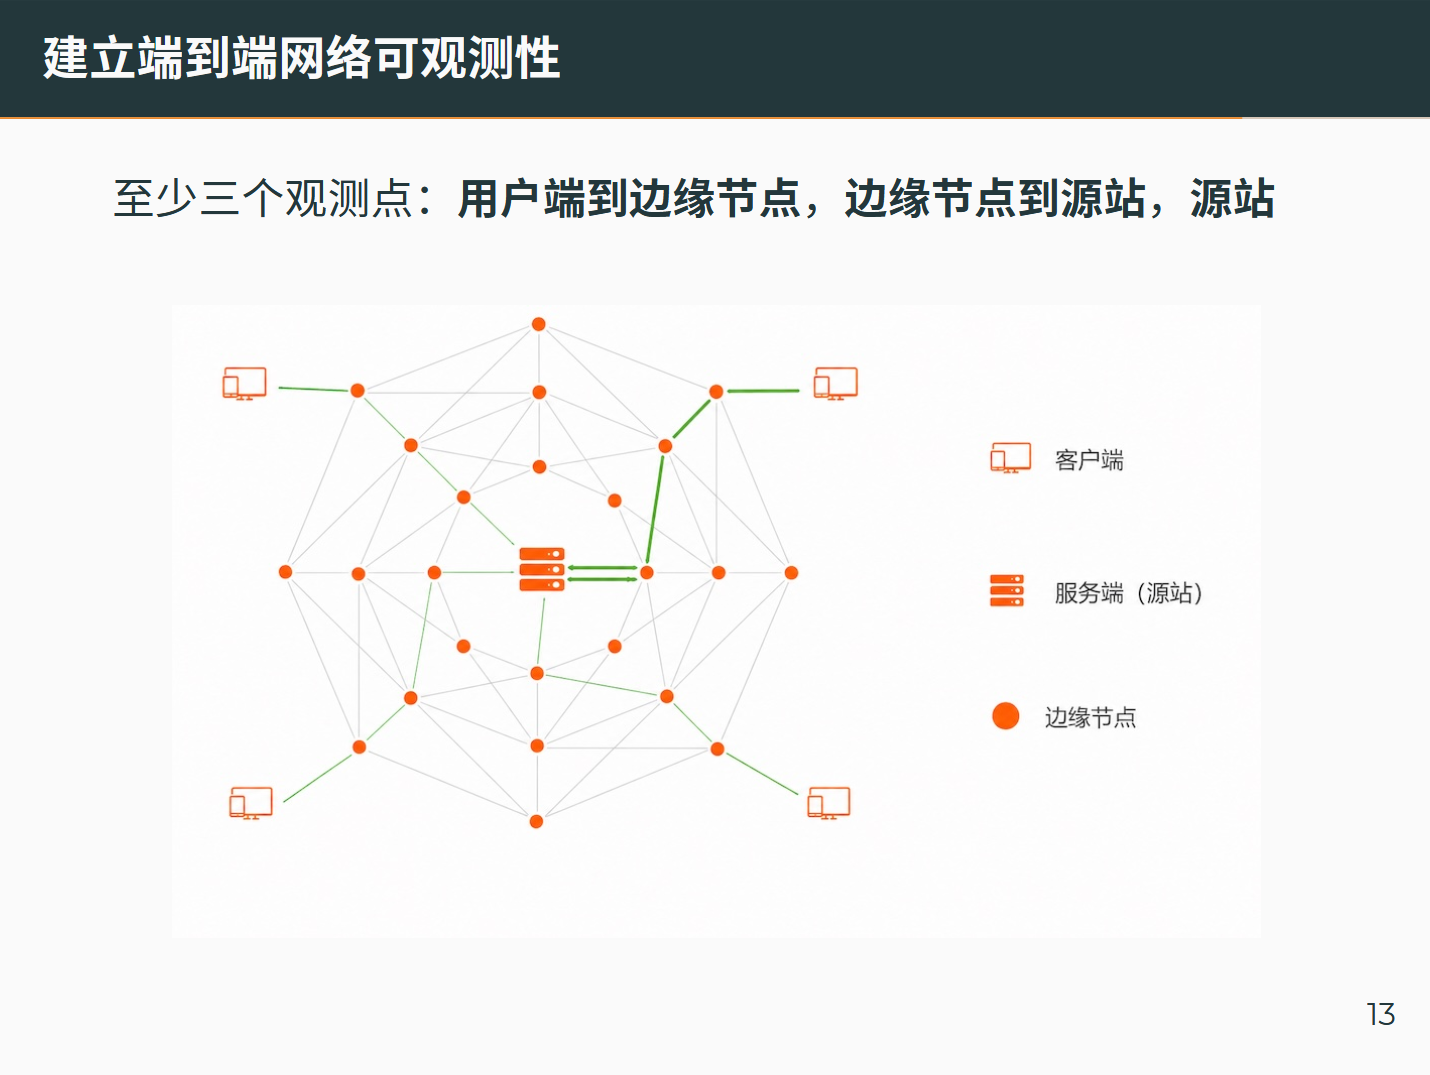
针对跨境网络“问题往往不是延迟高,而是经常出现抖动”的特点,穆佃舜分享了 TeXPage 的系统性方案:静态请求走 CDN 预热缓存,动态请求靠智能路由与 Global Accelerator 回源;基于跨境流量价格差异巨大的现状,建立不同质量等级的网络池,让高价值实时请求走高质量网络、大流量可缓存请求走低成本网络。在可观测性上,他特别强调至少部署用户端到边缘、边缘到源站、源站三个观测点,且故障上报必须走独立的监控域名与服务商。边缘侧前置 DDoS/WAF/RateLimit/Bot 防护,源站则以 IP 白名单加身份验证保护,为在线 TeX 服务的全球用户保驾护航。
CanoKey开发实践与进展
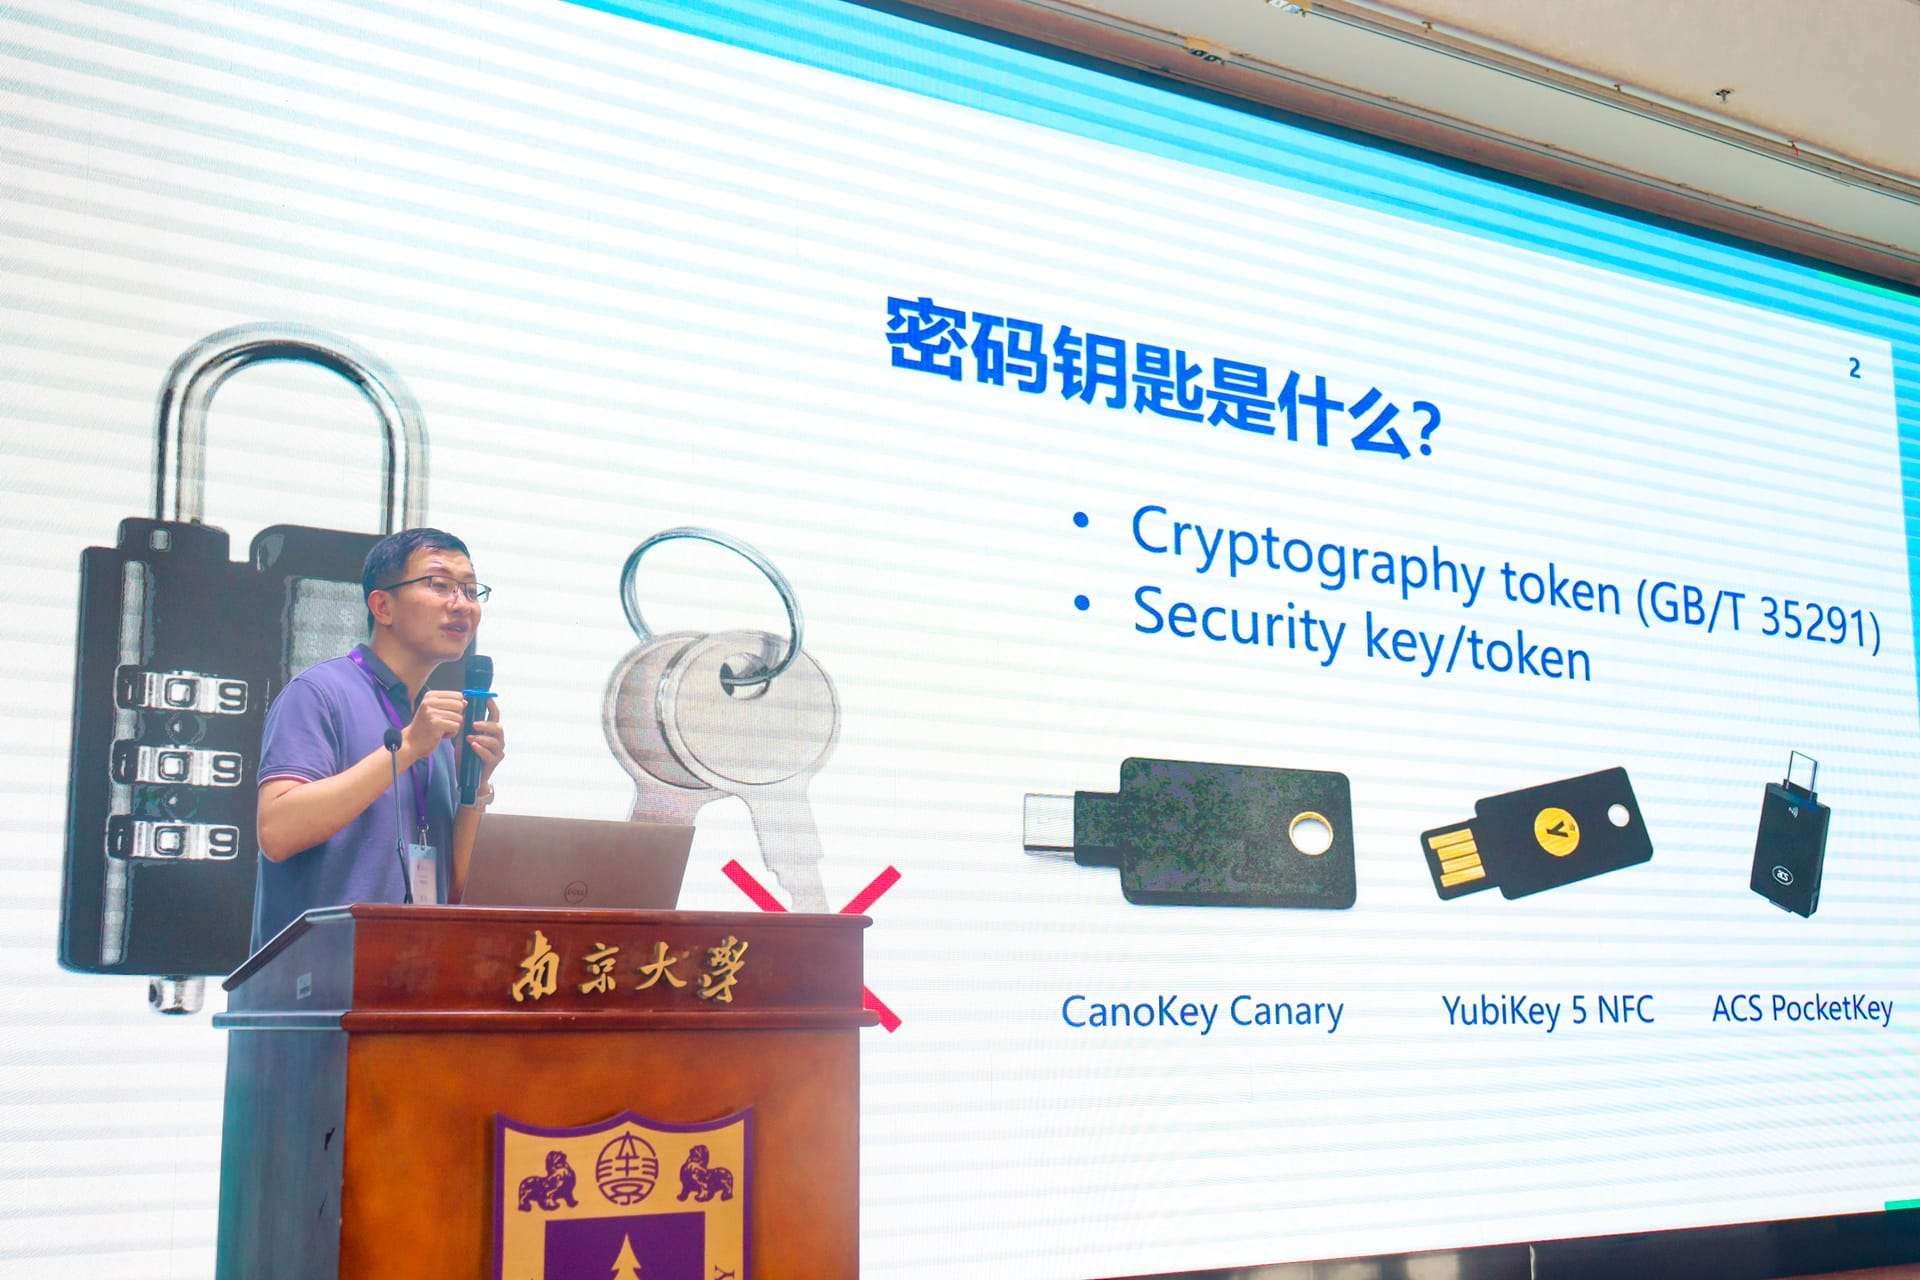
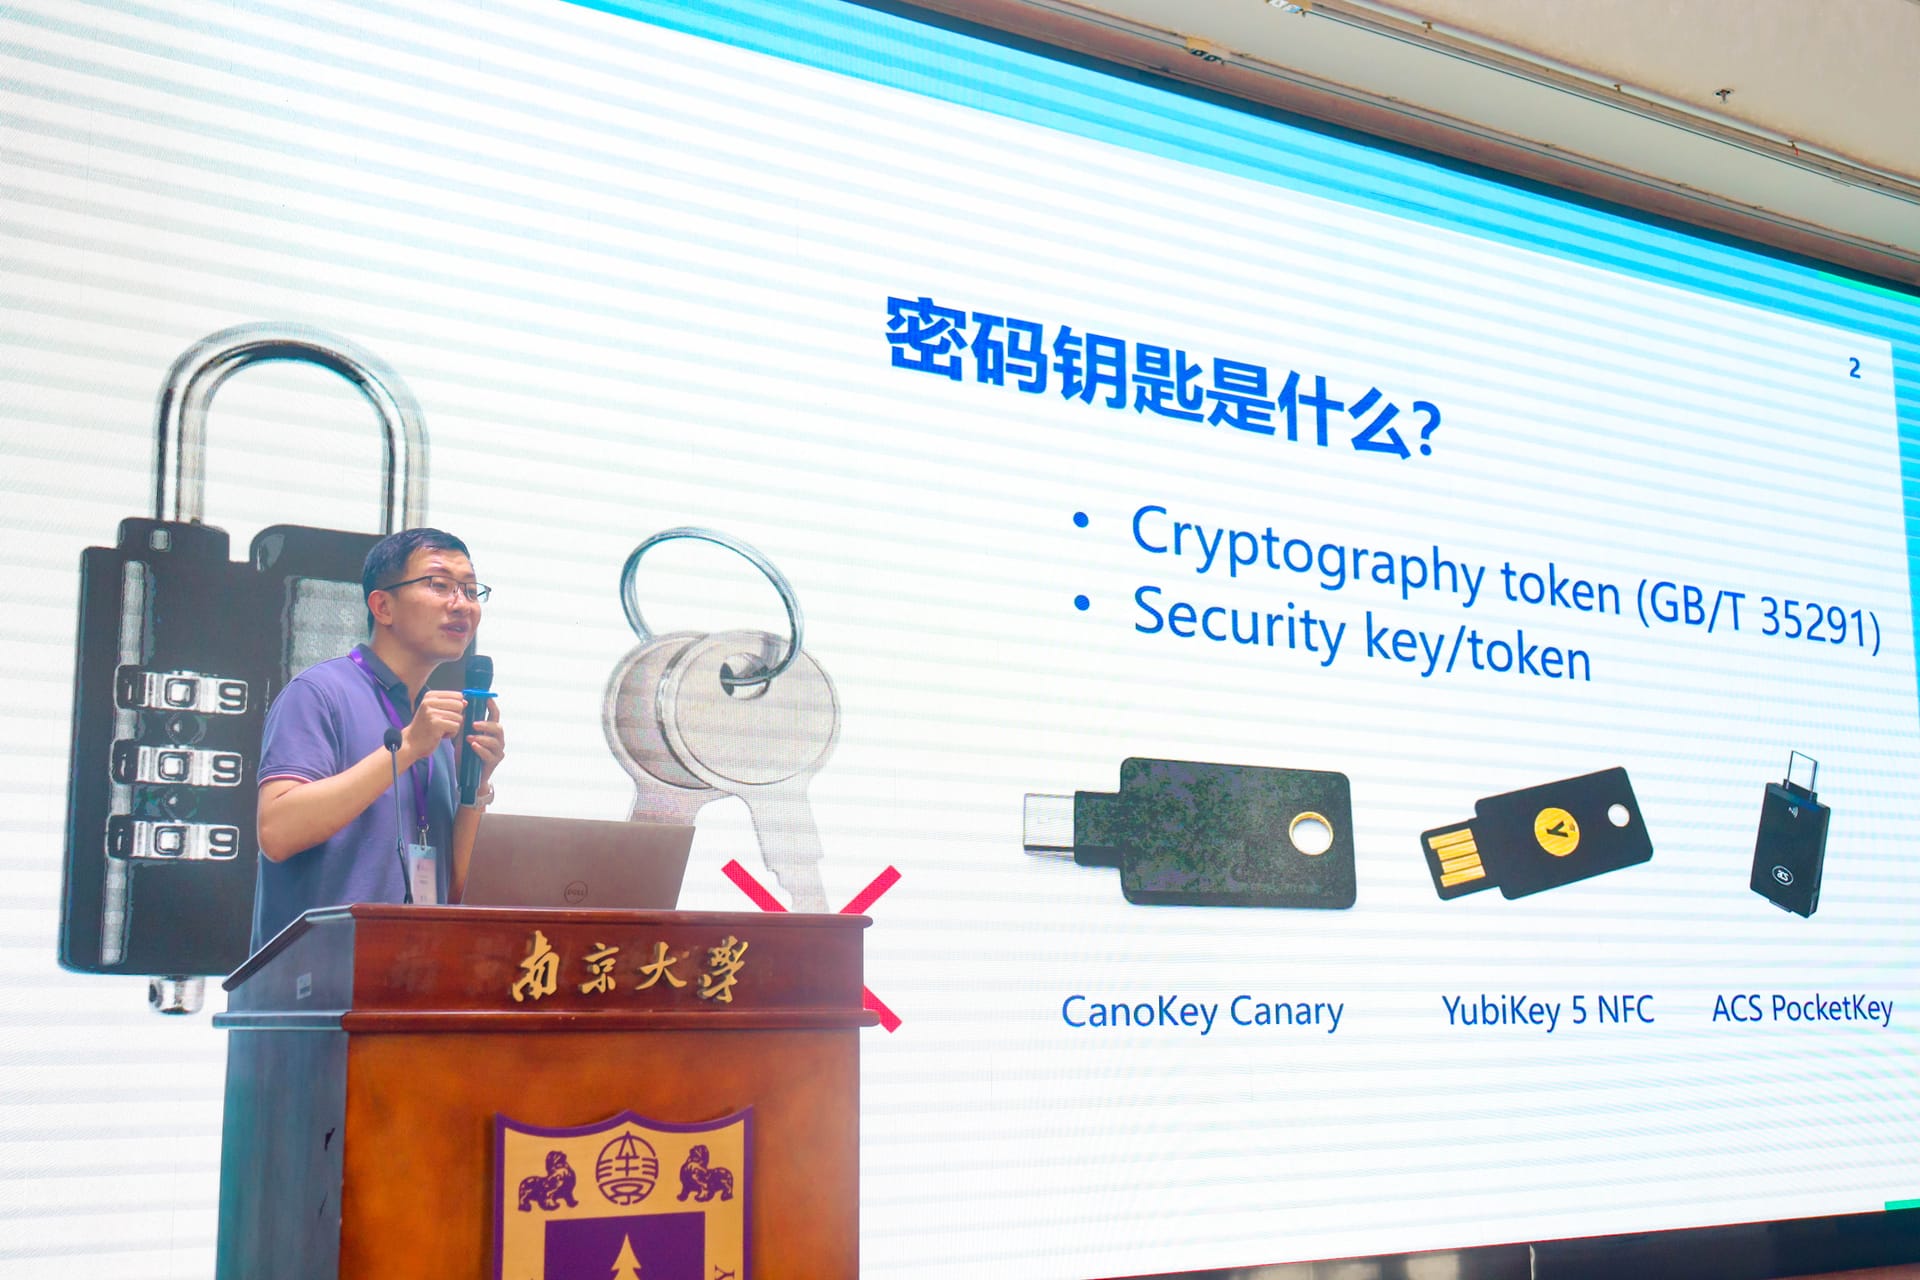
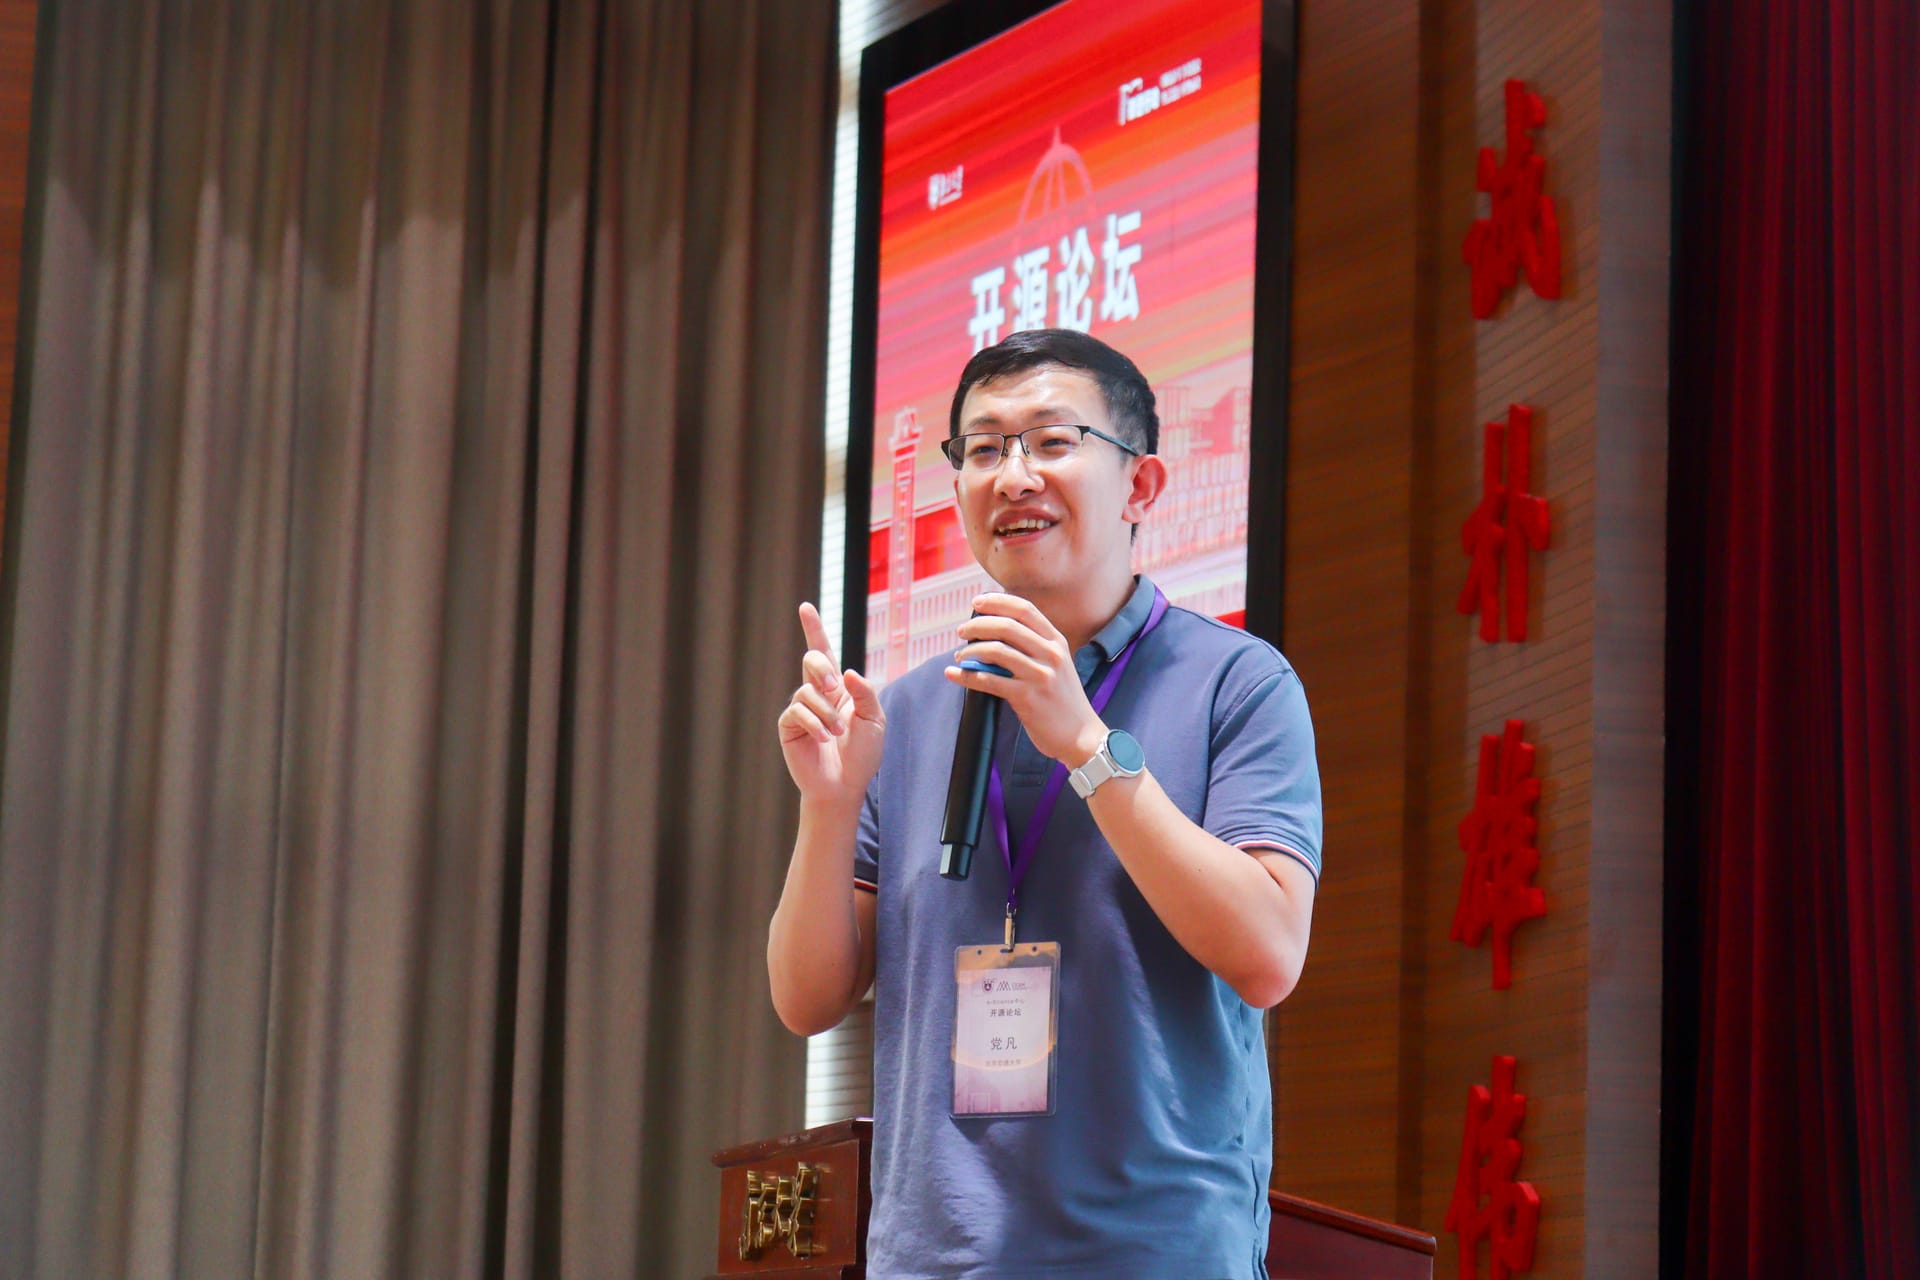
下午议程开始,北京交通大学副教授、TUNA 成员党凡带来了开源安全密钥 CanoKey 的开发实践。CanoKey 覆盖 Passkey/FIDO2、TOTP/HOTP、PIV、OpenPGP 四类应用,其开发历程堪称一部“在资源受限 MCU 上挑战密码学极限”的历史:从对着文档“手搓” CTAP 2.0,到 2020 年用 2048 位模乘器实现 RSA 4096;2022 年用 BPSW 算法在芯片内生成 2048 位素数;2026 年又借助大模型辅助,使素数生成时间平均减半。
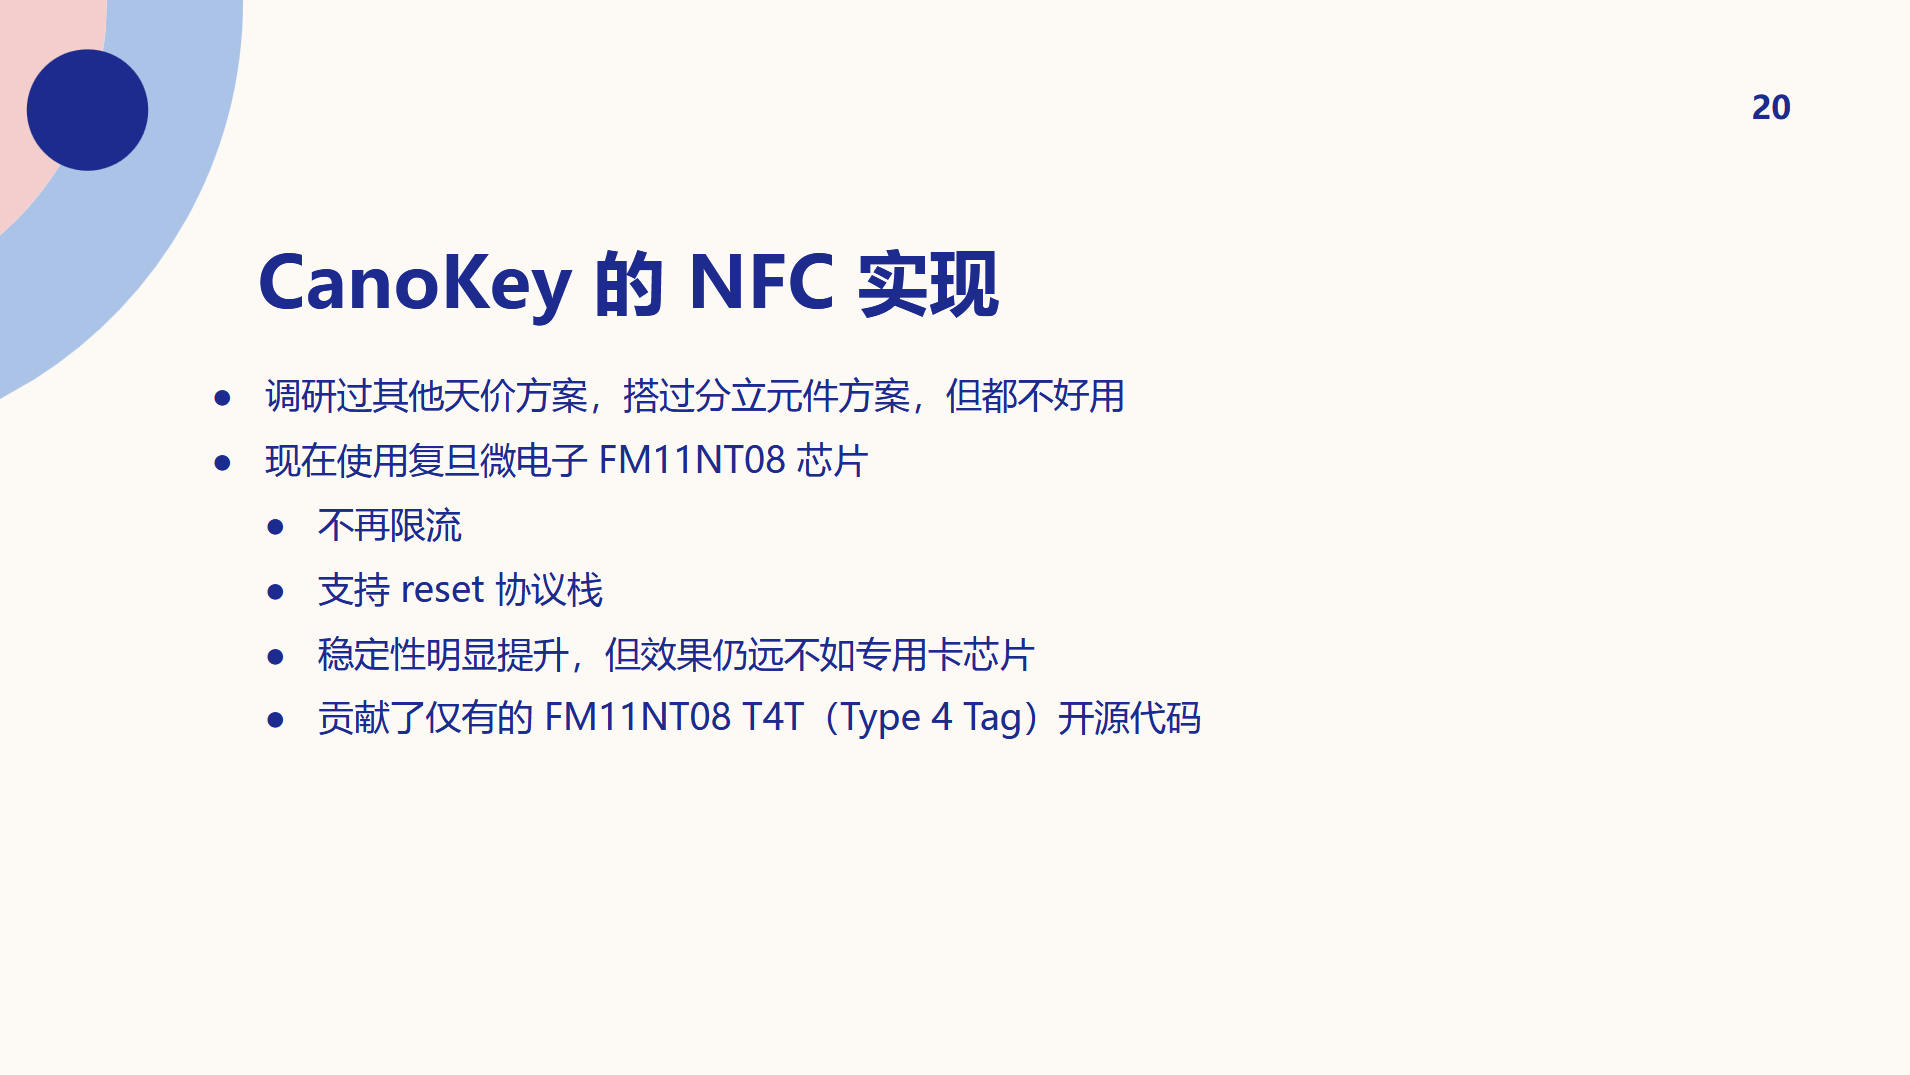
后量子密码时代,CanoKey团队在大模型辅助下实现了 ML-DSA/ML-KEM 的流式计算;不过因 OpenPGP 社区分裂,PQC 暂时只支持 WebAuthn 与 PIV。报告还分享了 NFC 芯片选型的踩坑经验,并贡献了的 FM11NC08/FM11NT08 T4T 开源代码。CanoKey Console、CanoKey QEMU 等周边工具,以及过程中产生的 flutter_nfc_kit、ccid 等开源项目,共同构成了完整的开源生态。
清华大学学生超算团队概况与未来规划
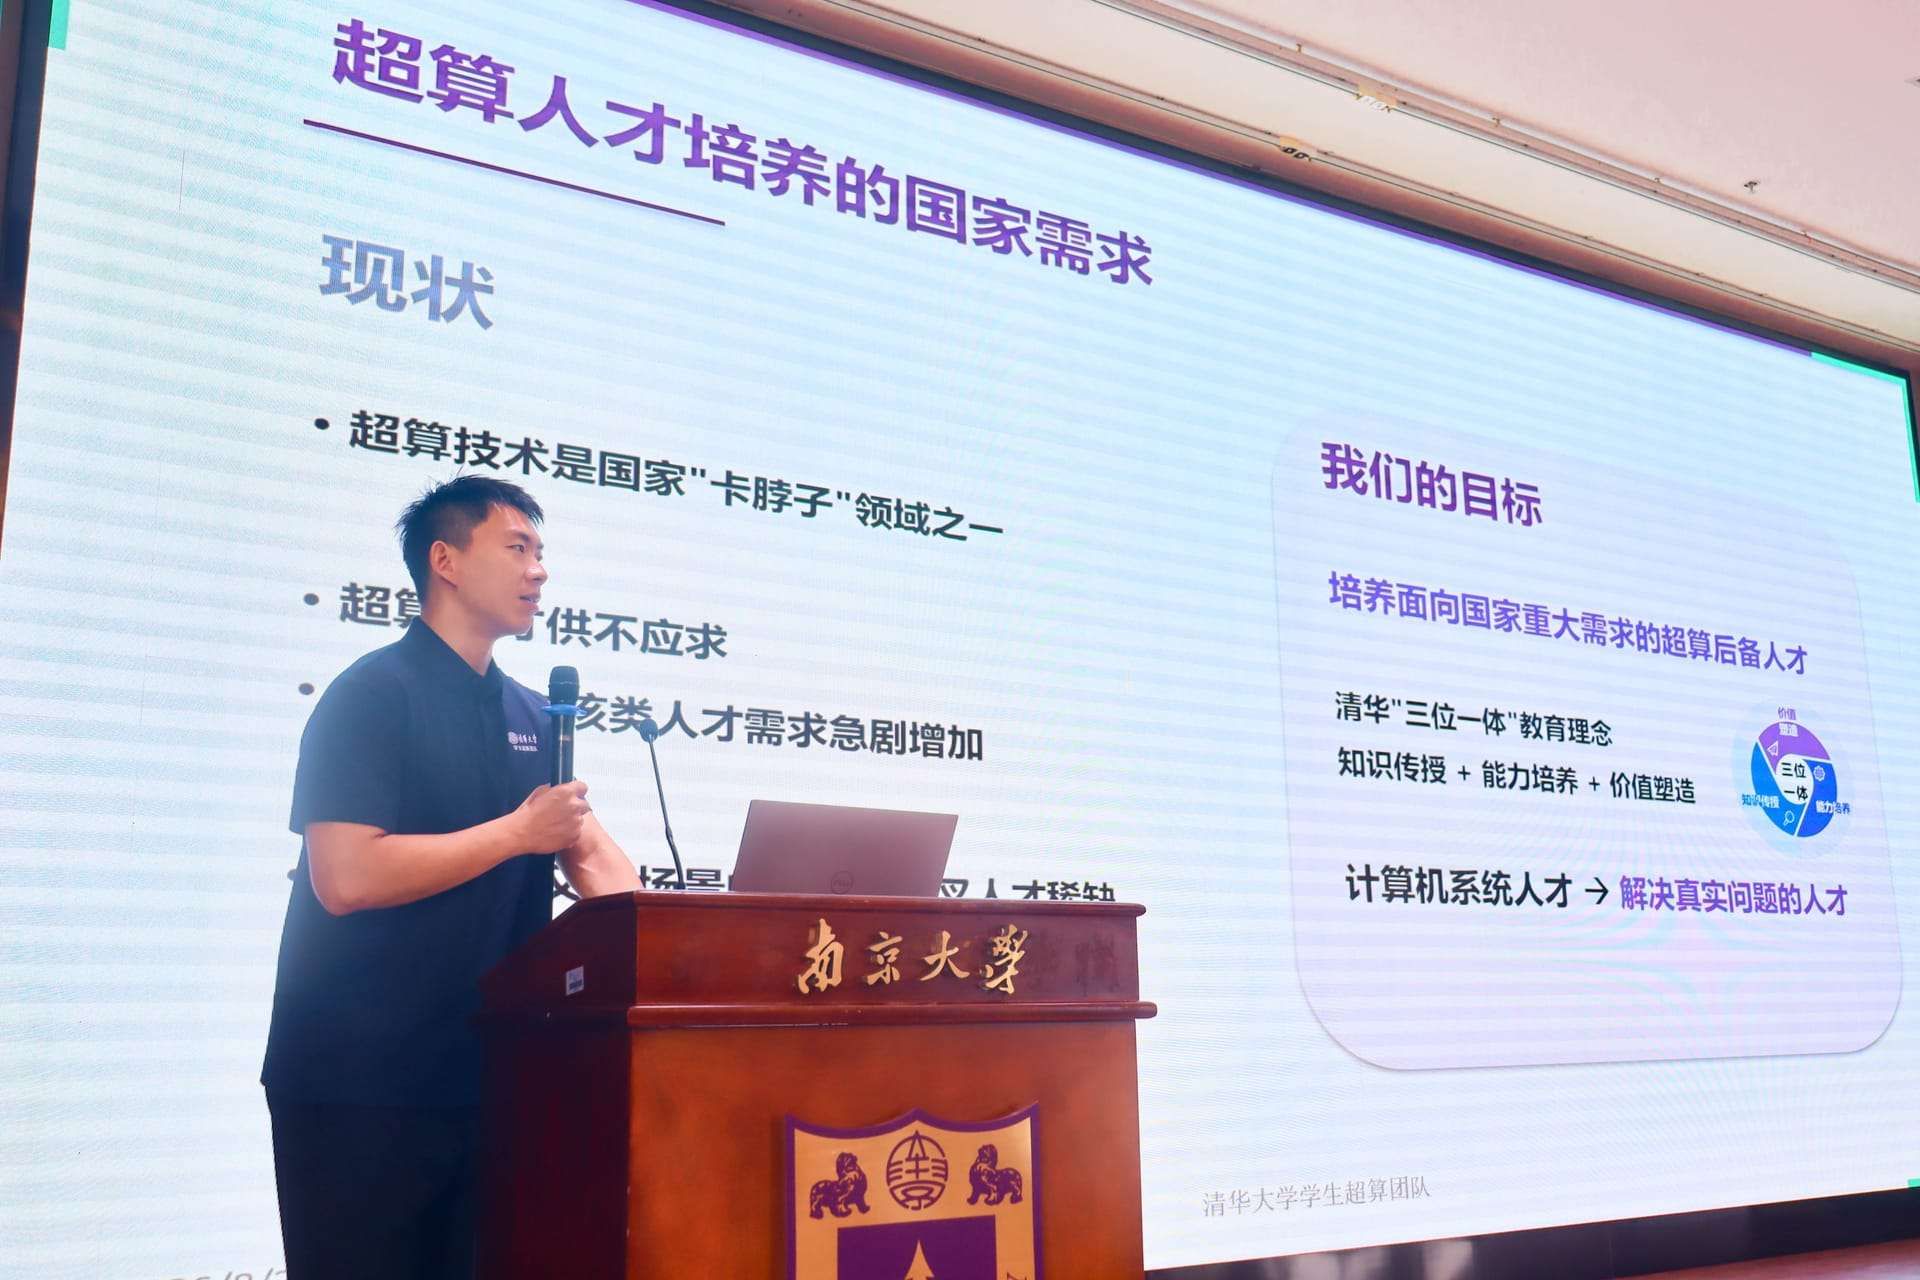
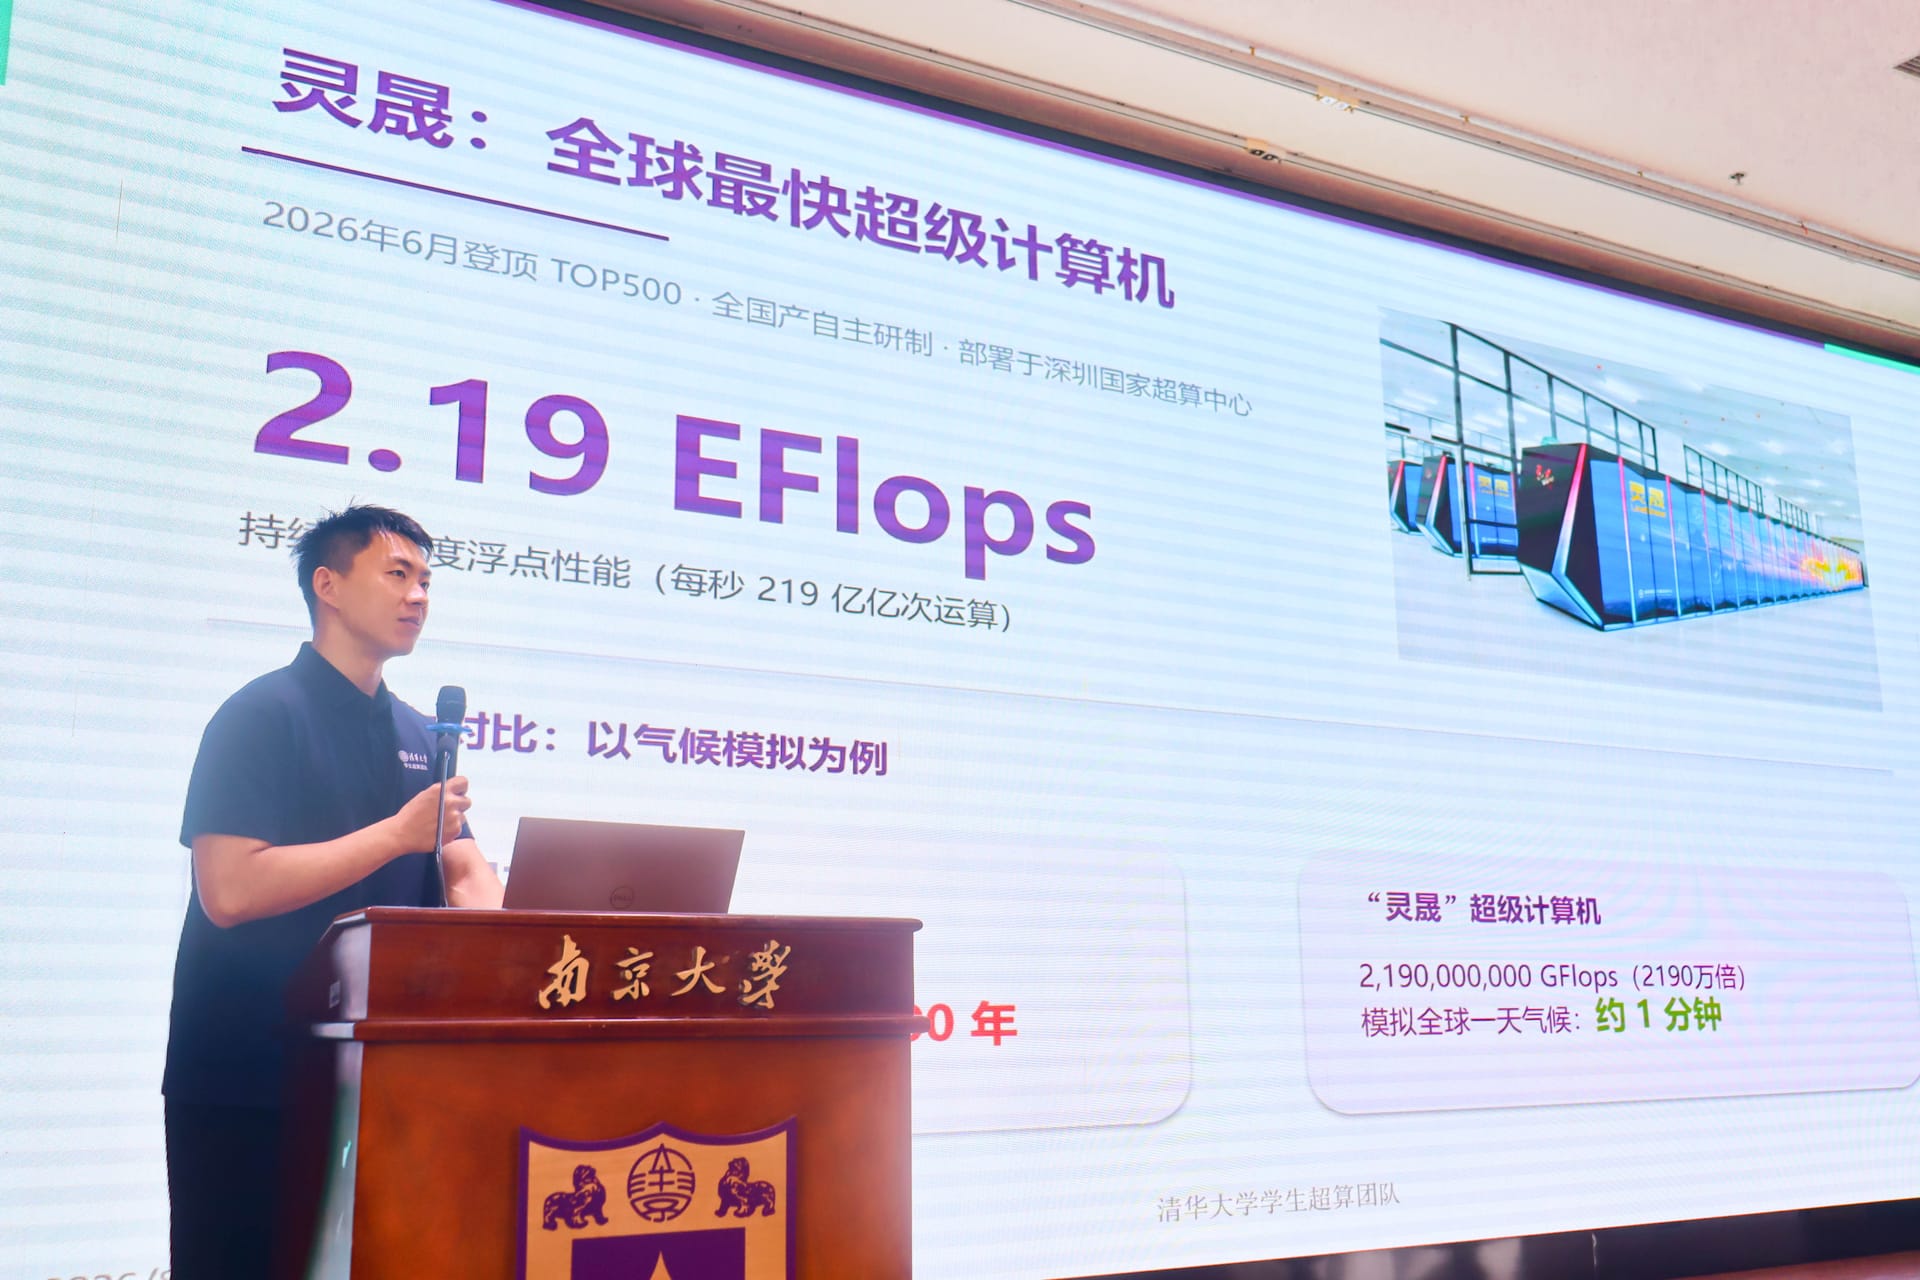
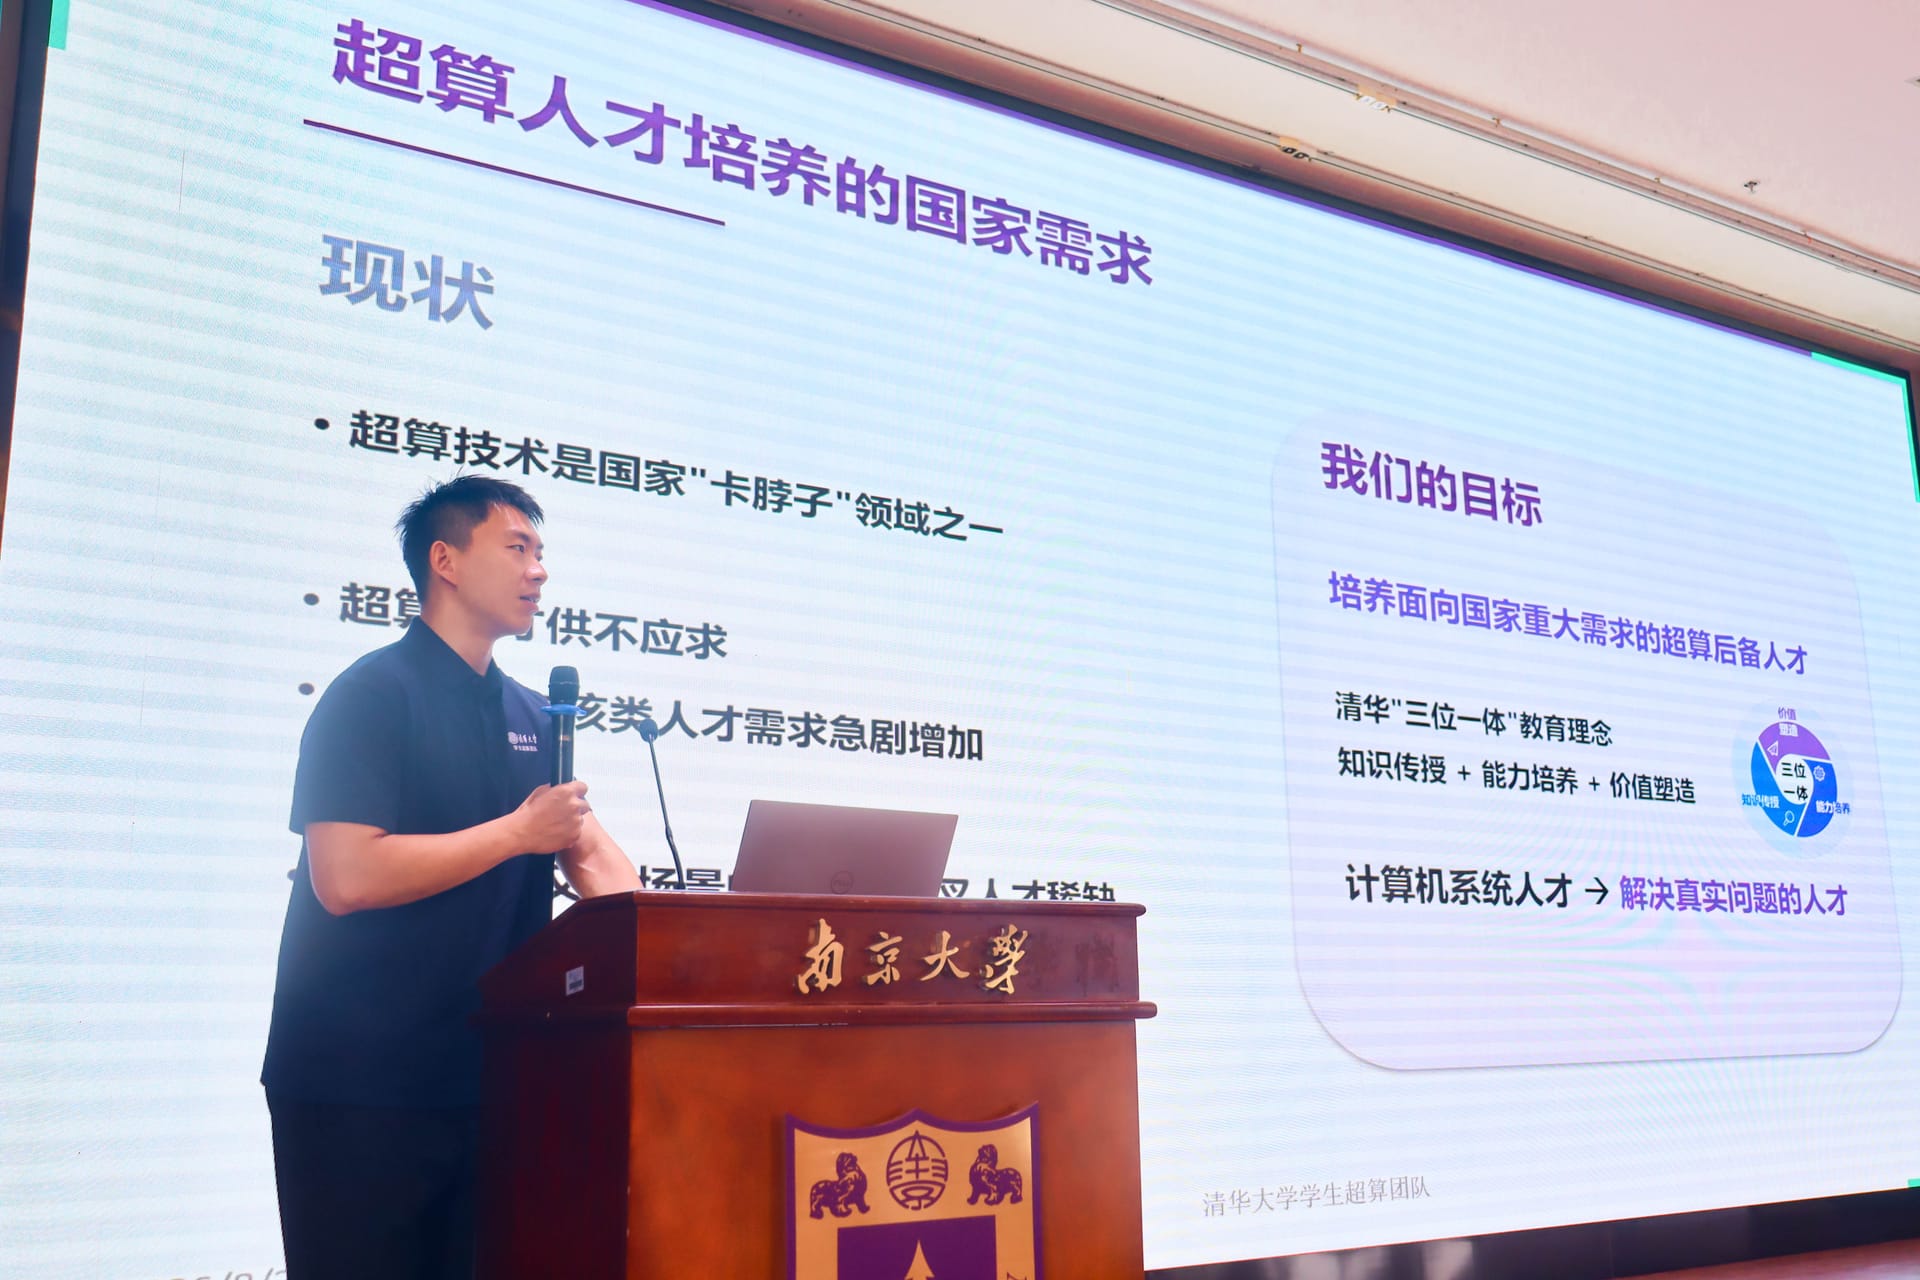
清华大学计算机系助理研究员金煜阳介绍了清华学生超算团队的辉煌战绩与人才培养体系:团队成立于 2012 年,历届队员 70 余人,34 次参赛、19 次冠军,2015 与 2018 年两度同年包揽 ASC/ISC/SC 三大赛事“大满贯”,2025 年再获 ISC 冠军;走出过商汤联合创始人徐持衡、Jittor 创始人梁盾、DeepSeek 基础架构负责人赵成钢等知名校友。
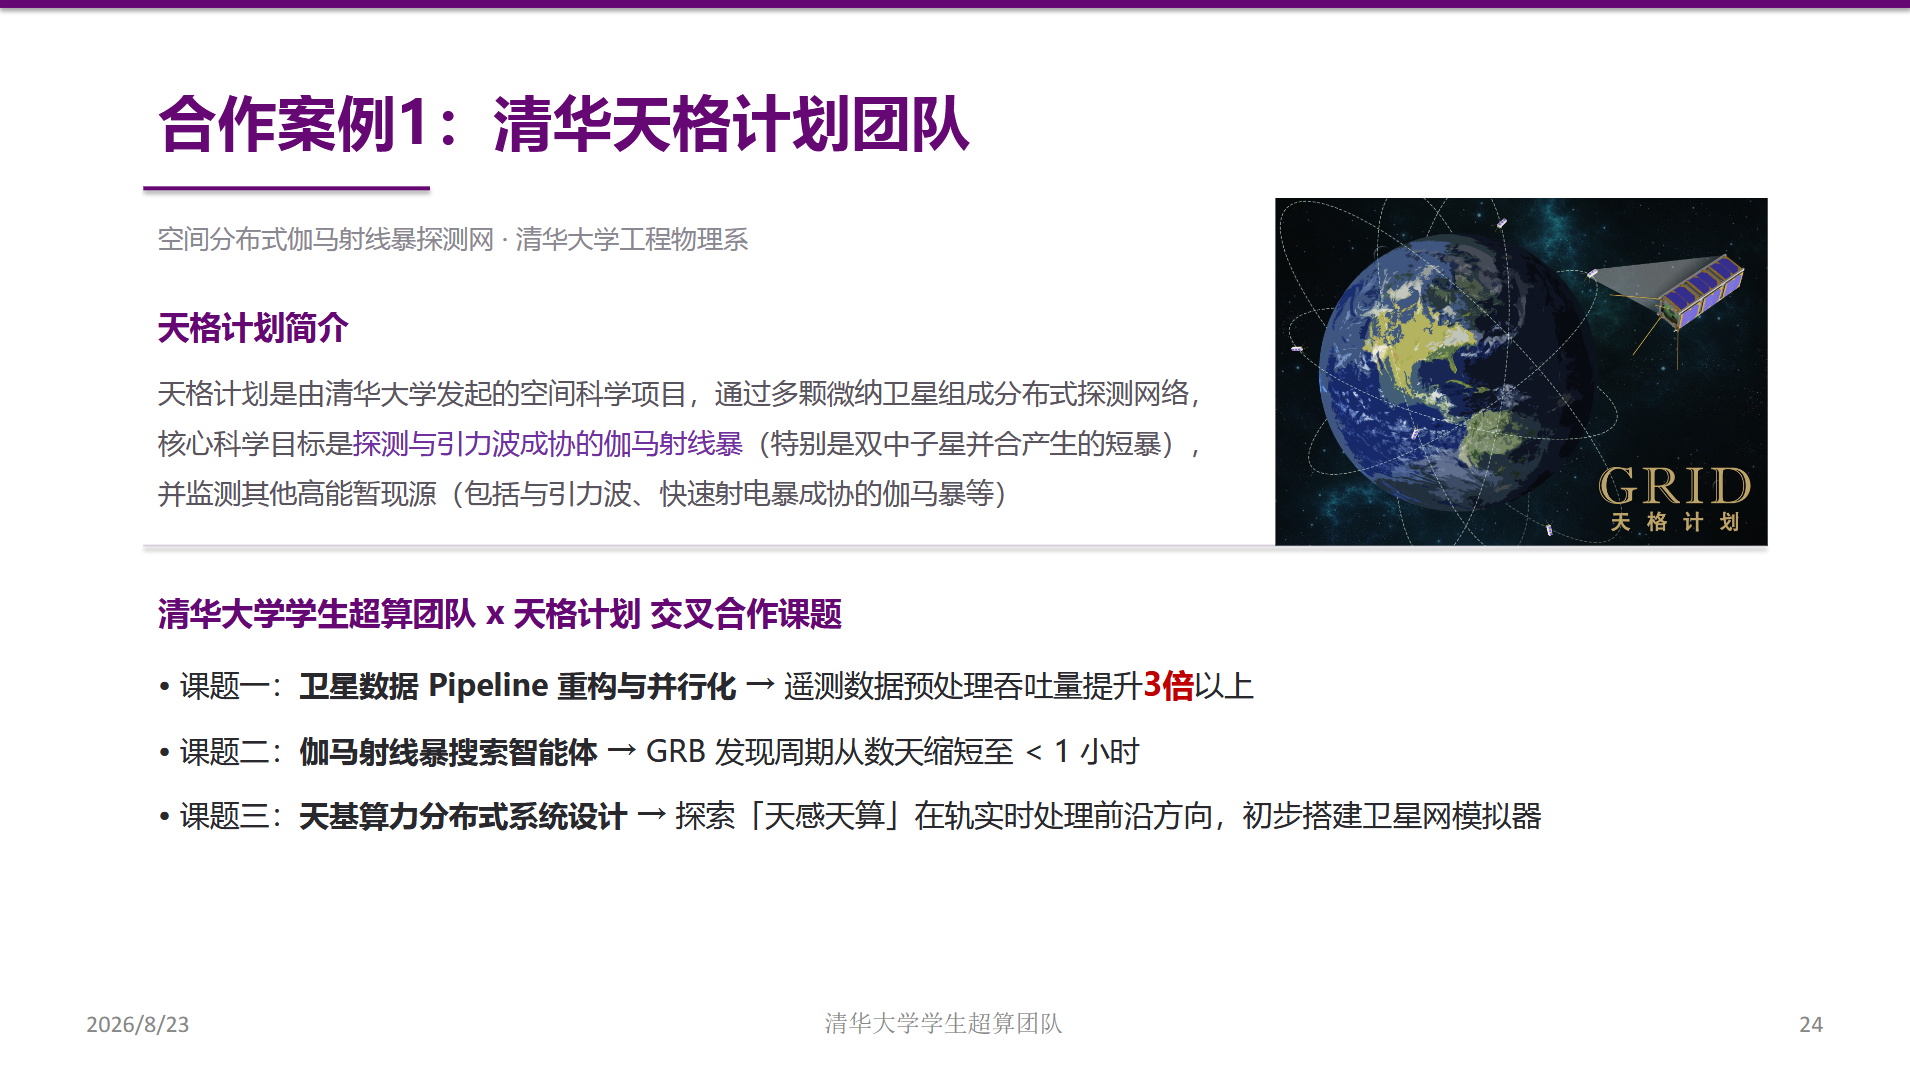
更引人注目的是团队“以超算技术服务真实科研”的规划:团队与天格计划合作,遥测数据 Pipeline 并行化吞吐提升 3 倍以上,伽马暴搜索智能体将 GRB 发现周期从数天缩短至 1 小时以内——2026 年 6 月 16 日,系统在十分钟内检出 GRB260616B,与 NASA Fermi GBM 结果吻合;与化工系合作完成 20 万次蛋白质结构预测(单块 A100 需 31 年),通过 AlphaFold3 算子优化与缓存复用实现约 100 倍加速。
对于当下高校超算的发展趋势,金煜阳认为:AI 带来了促进学科交叉的新机会,降低了跨学科沟通成本,促进交叉合作的软件工程,而超算团队就是落地合作的平台和载体。 他展望未来,超算团队需要从参加超算竞赛向服务真实科学场景发展,用超算支撑领域科学场景的真实计算需求。
Puro-2B全流程开源语言模型训练
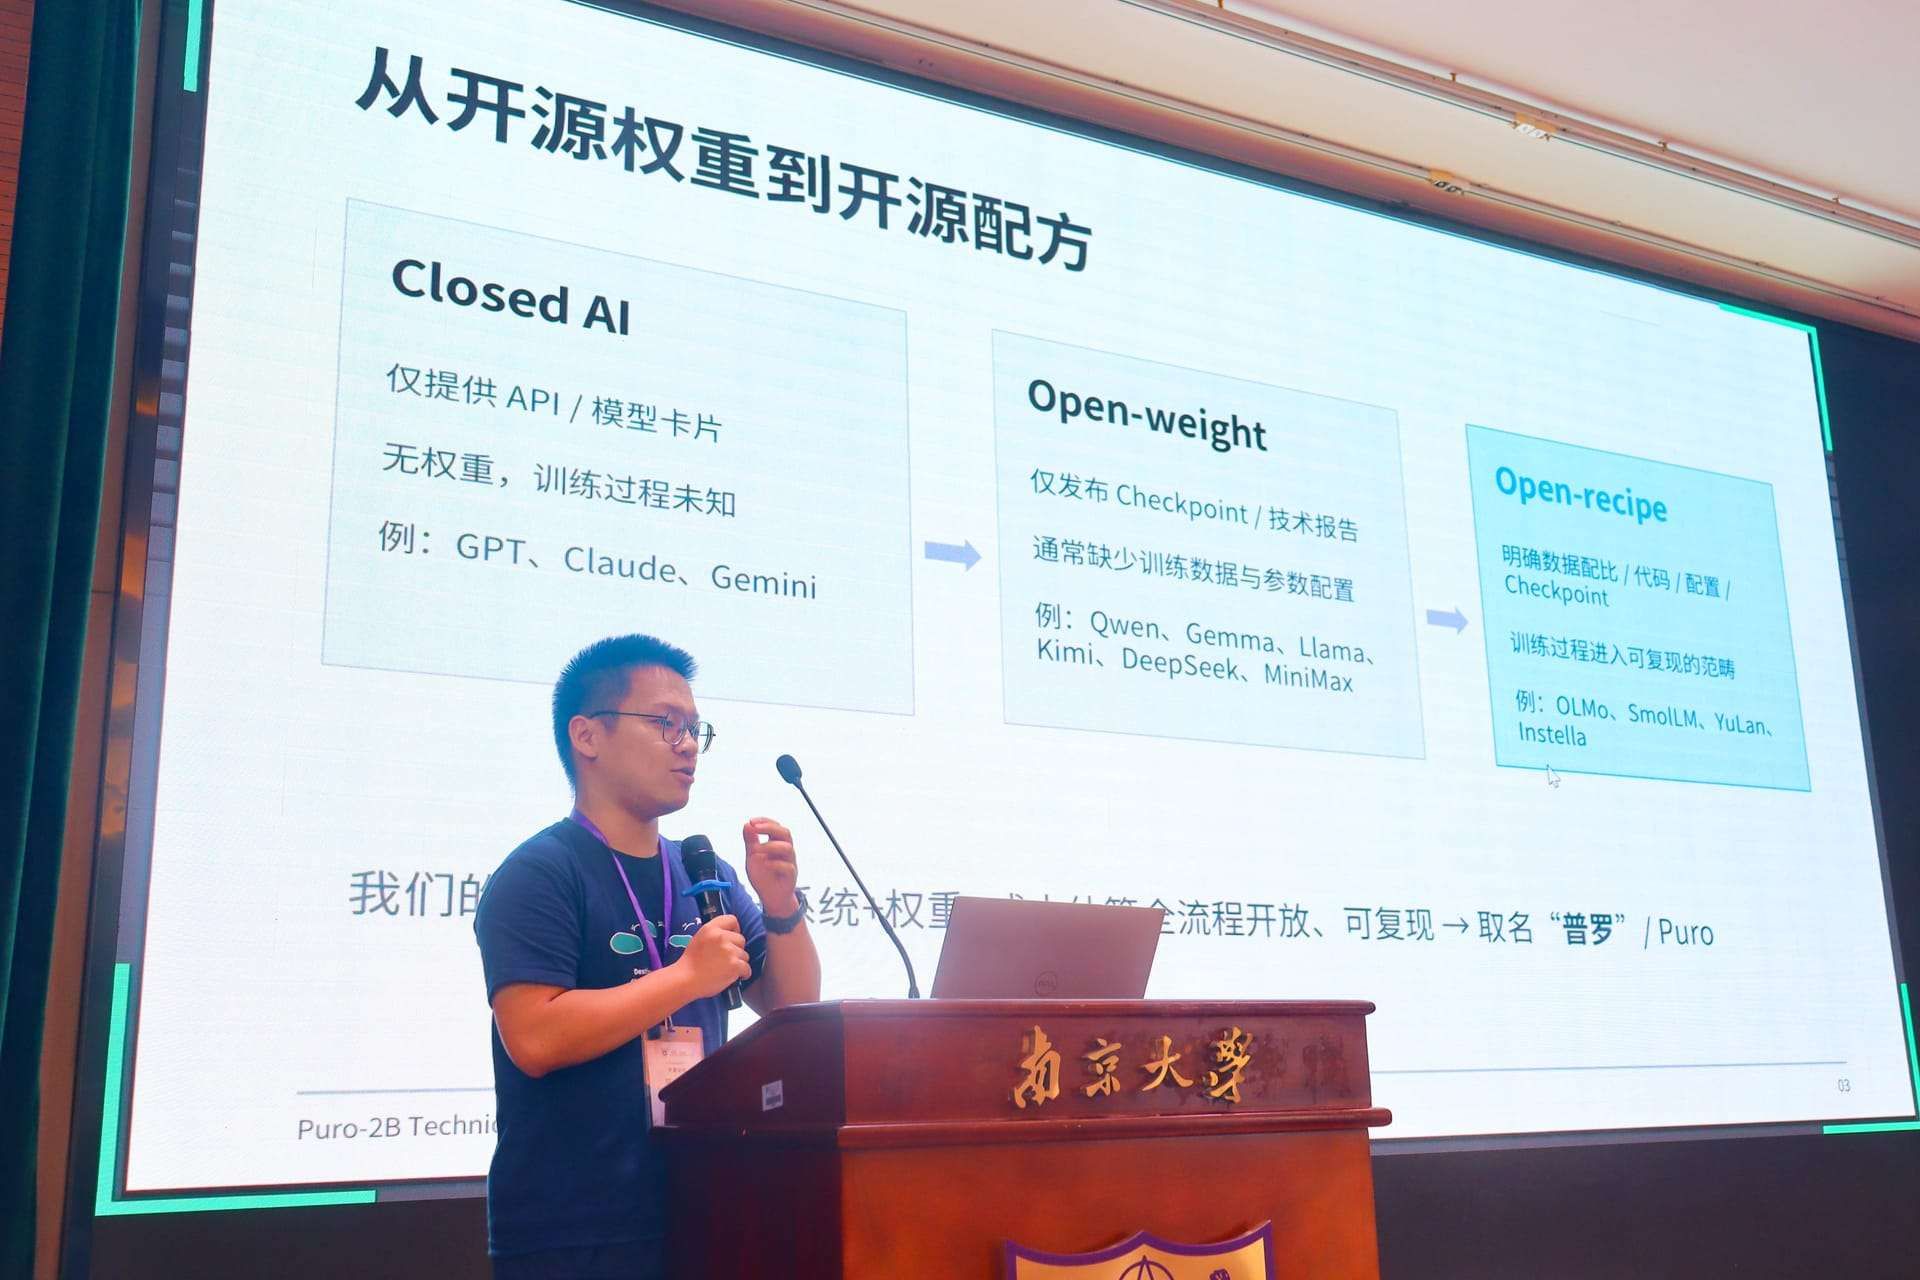
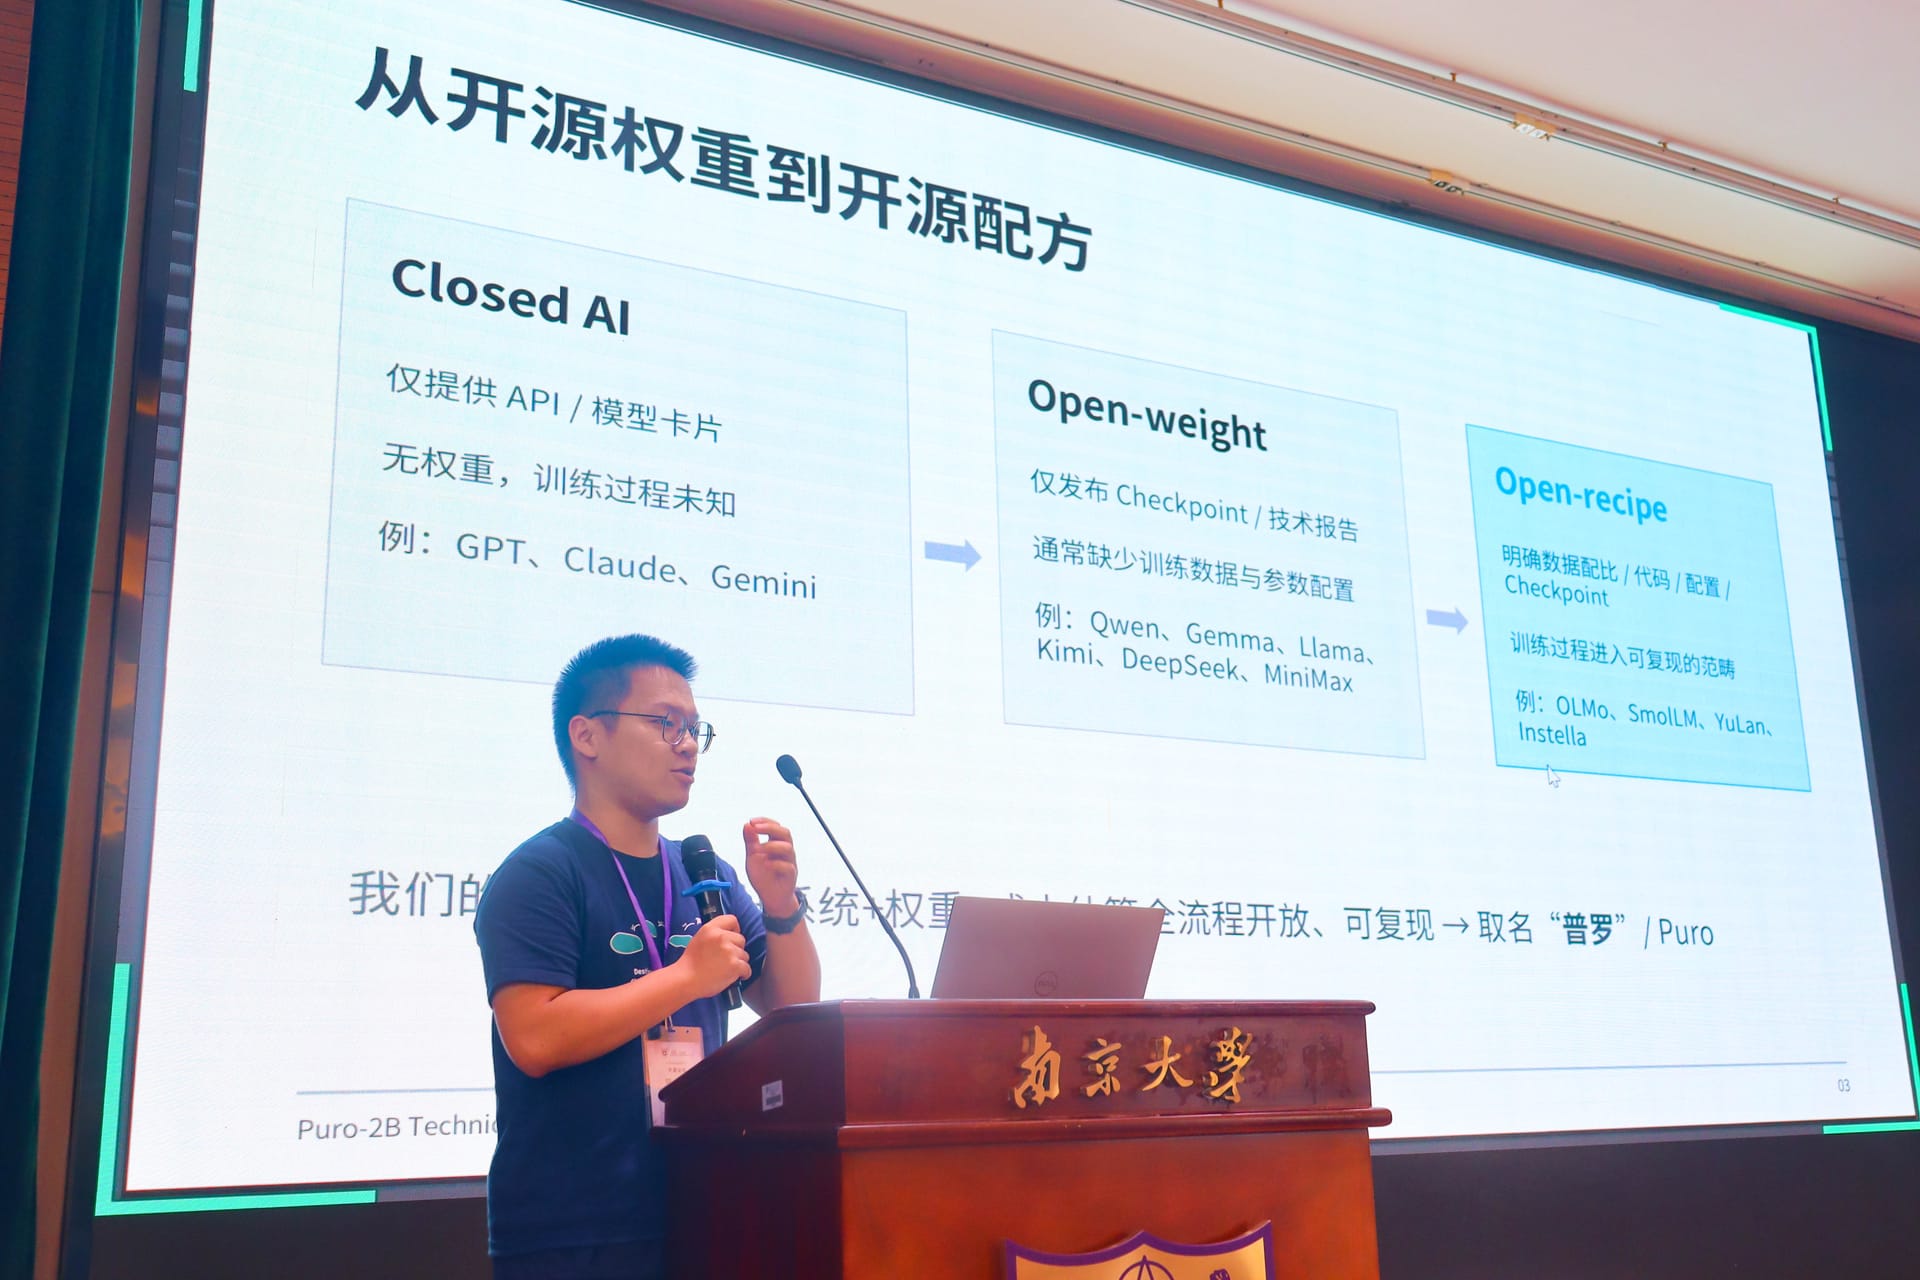
清华大学 PACMAN 团队的陈晟祺发布了该团队与鹏城实验室合作的全流程开源的2B参数量语言模型 Puro-2B,并开源了数据、代码、以及中间过程权重,直击“开源≠可复现”“权重能下载≠训练能复现”的行业痛点。
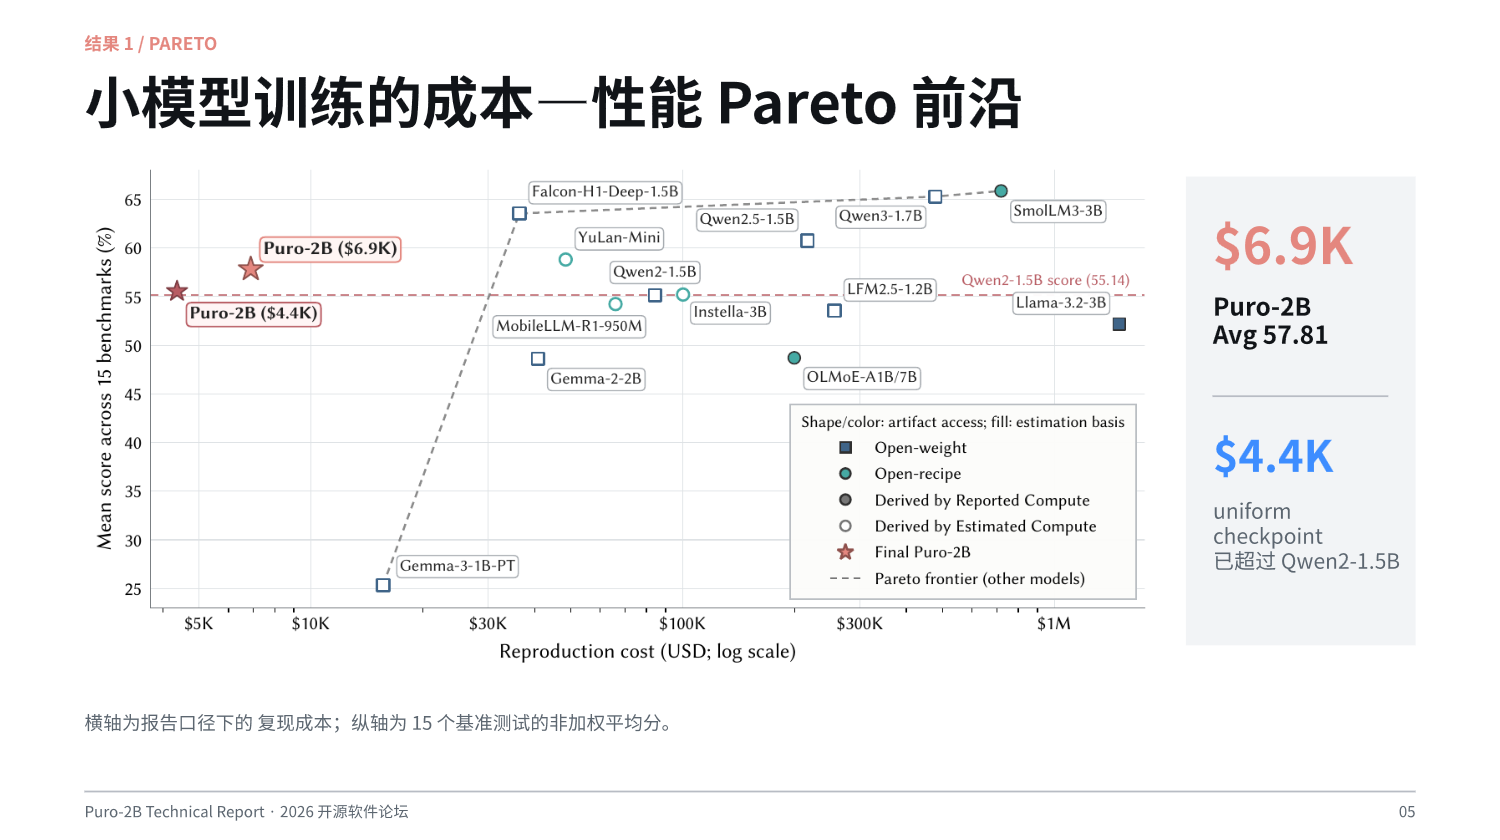
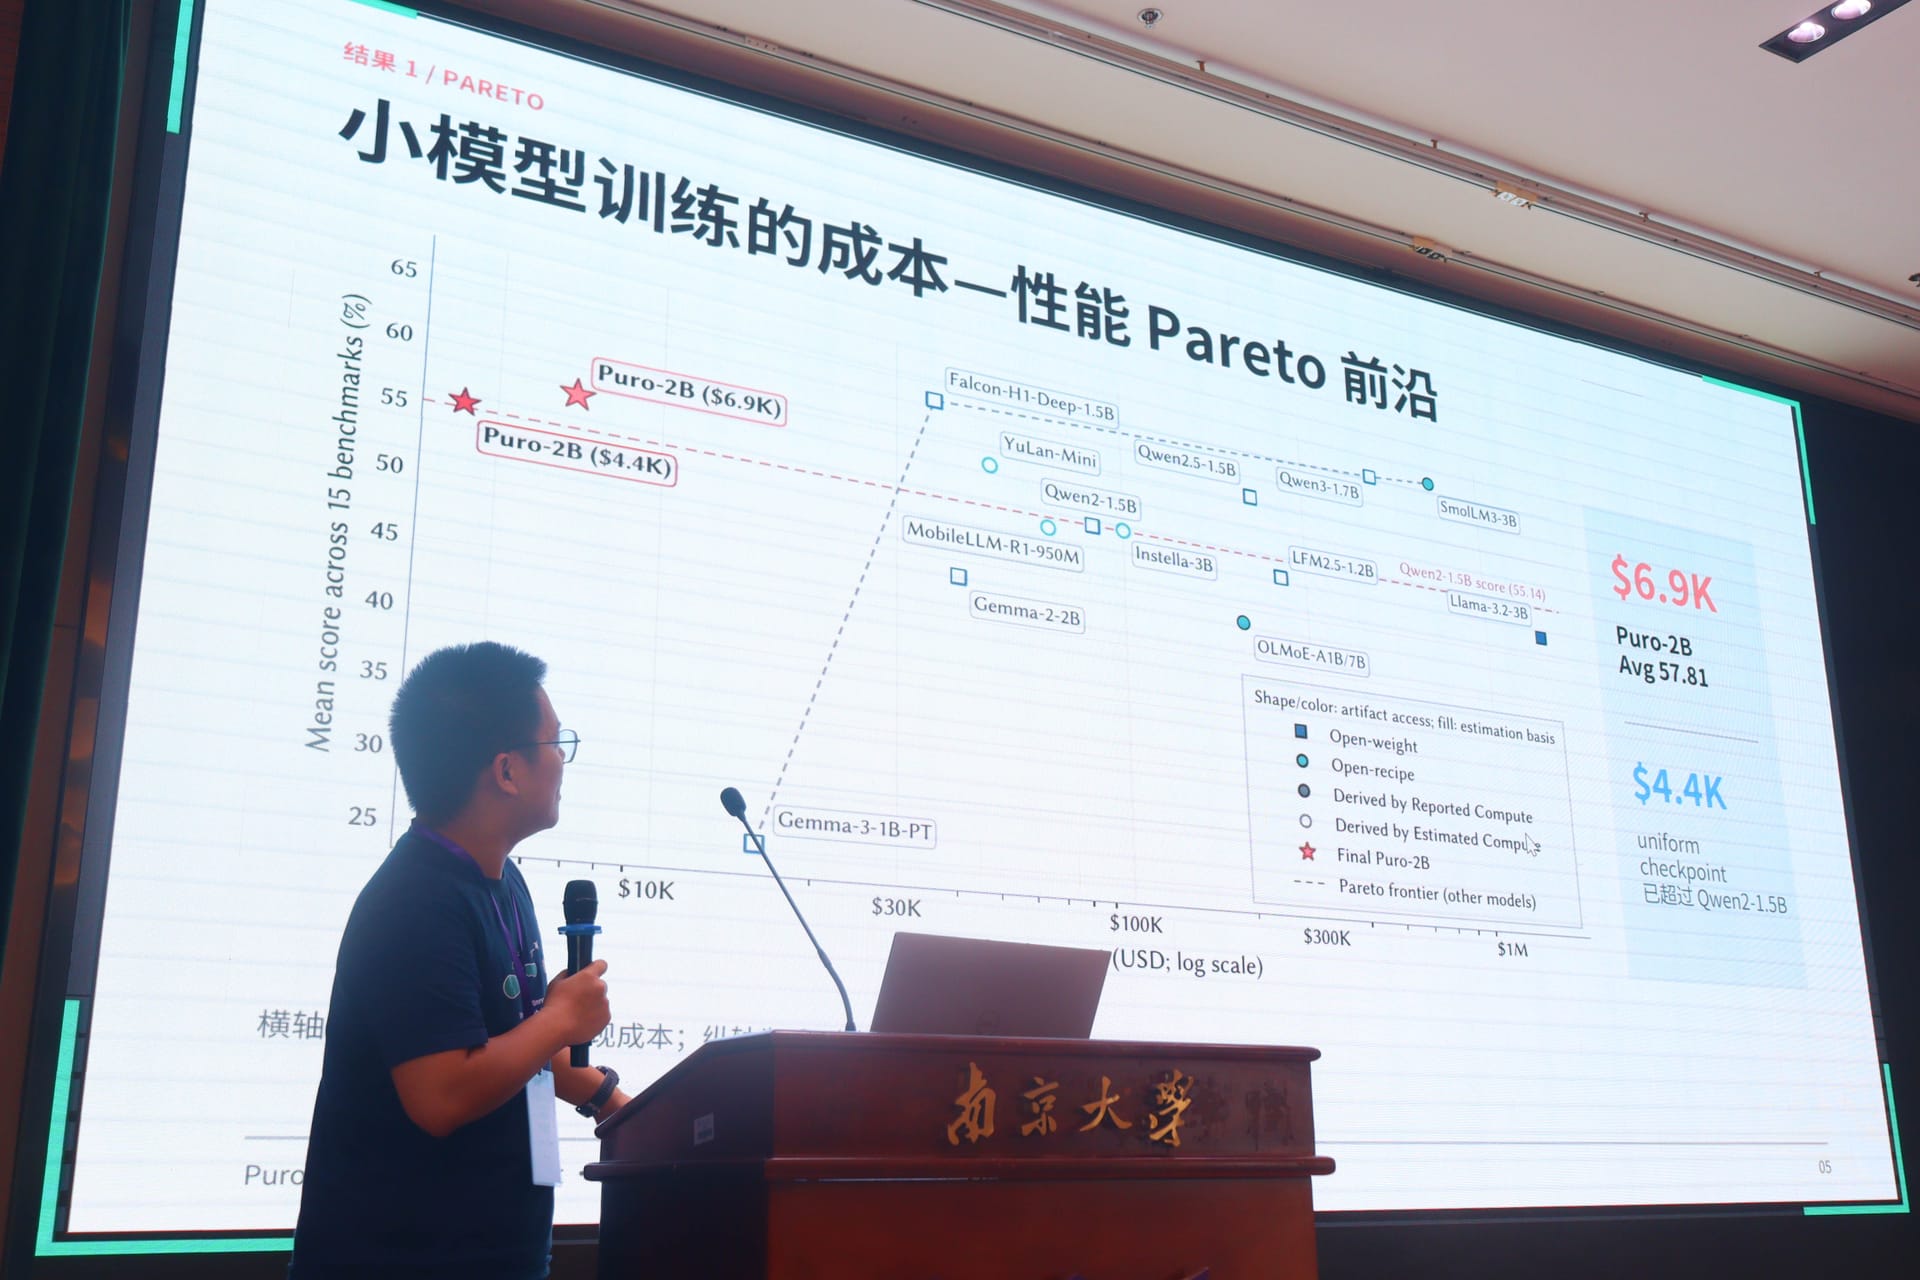
报告展示了一连串令人惊叹的成本控制手段:魔改开源 NVIDIA 驱动打开 PCIe P2P,单向带宽从 31.5 GB/s 提升至 56 GB/s,通信延迟从 14.3 μs 降至 0.4 μs;仅修改 libcuda.so 的一个字节即开启 GPU DirectRDMA,24 卡 AllReduce 带宽翻倍有余;采用类 DeepSeek-V3 的 FP8 训练配方,训练净加速达到 1.34 倍。最终,Puro-2B 在 RTX 5090 消费级集群上的实测训练成本仅 6900 美元,在 15 个基准测试上平均分达到 57.81,性能接近 Qwen2.5-1.5B;而仅需 4400 美元,即可达到 Qwen2-1.5B 的能力。与此对比, Llama-3.2-3B 需要约 150 万美元训练成本!Puro-2B 的技术报告详见https://arxiv.org/pdf/2608.27370v2,模型与代码已在 Hugging Face 与 GitHub 开源。
Kimi K3 in vLLM
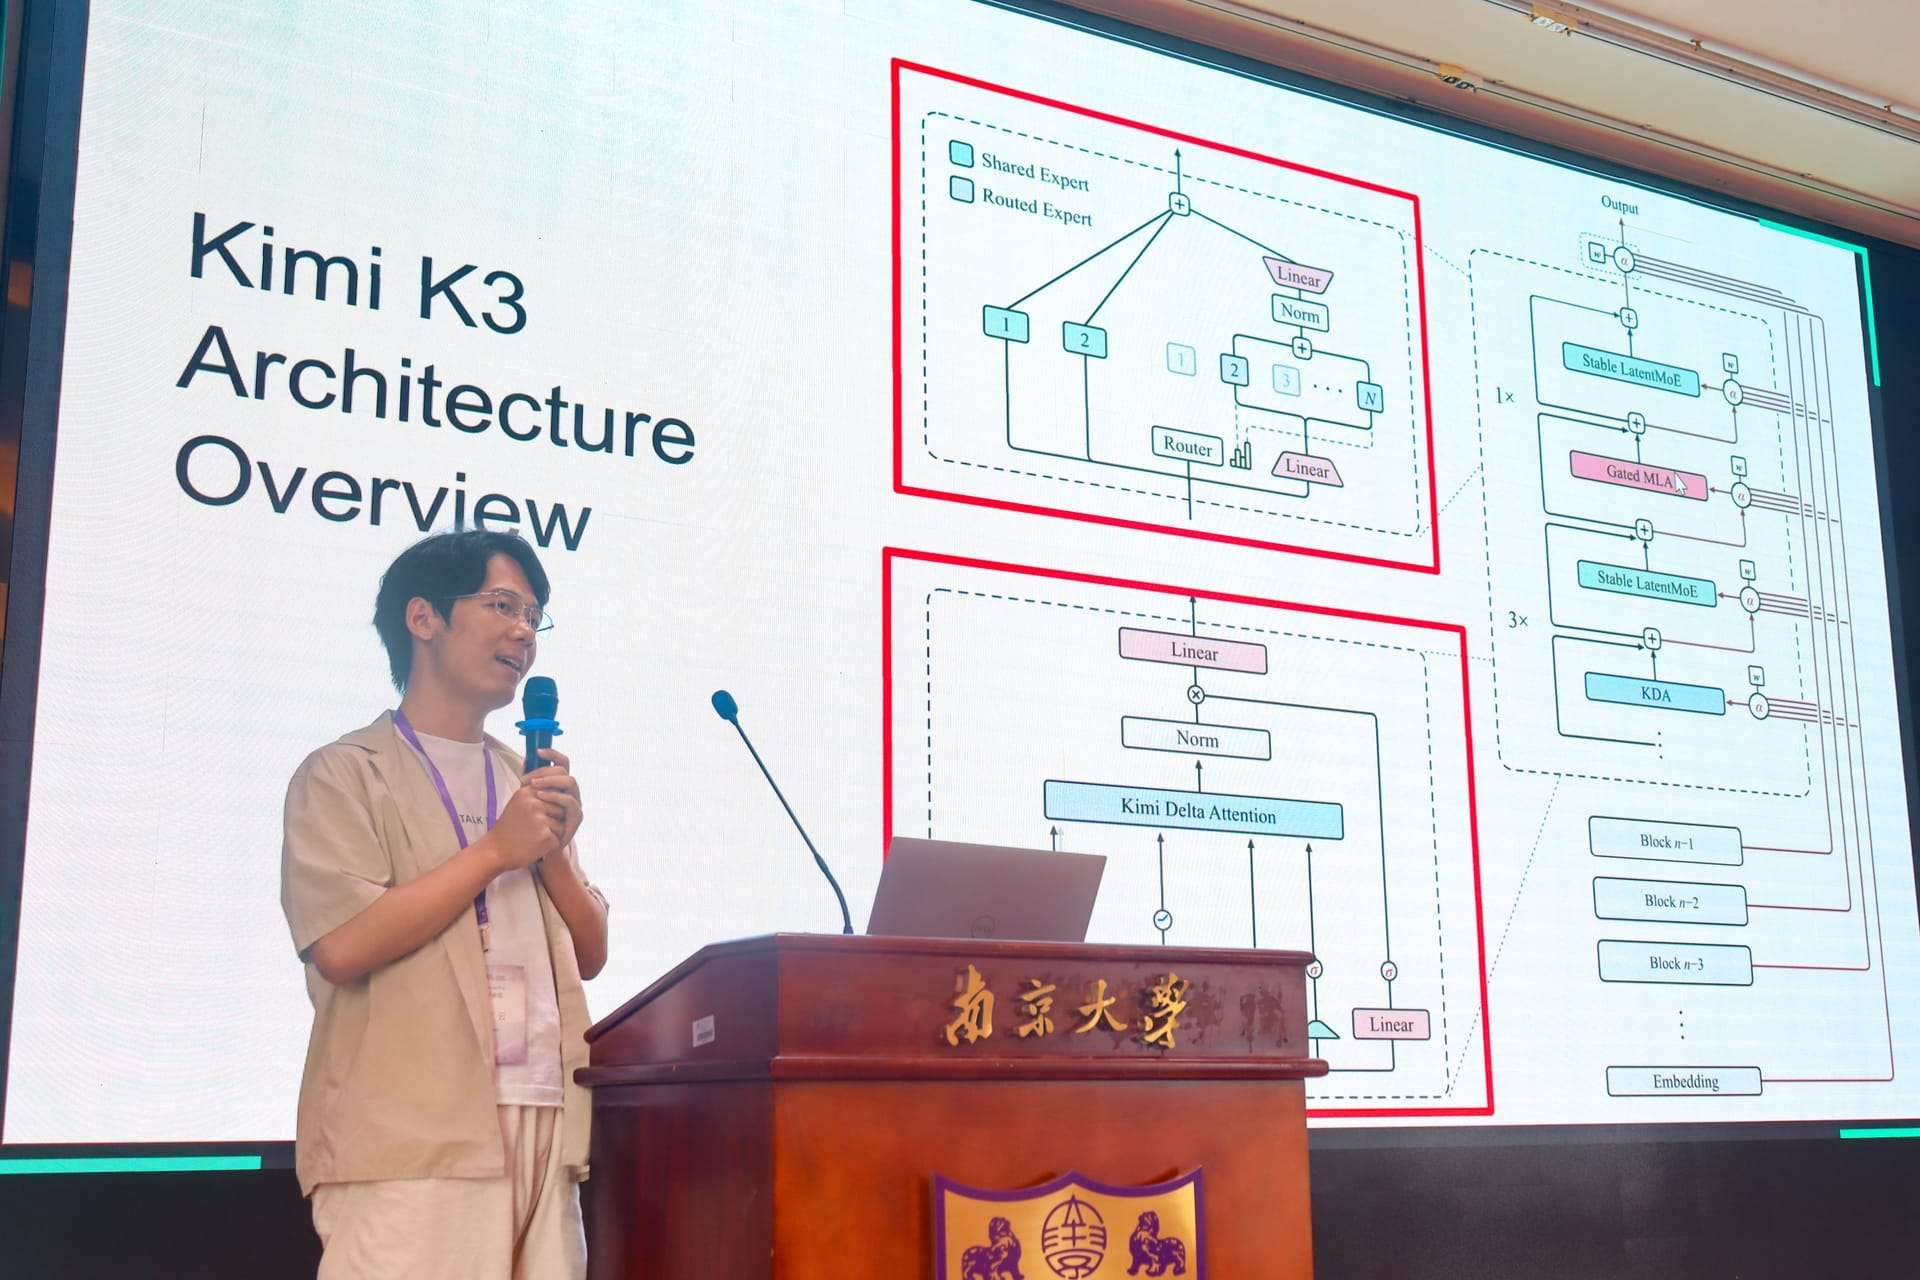
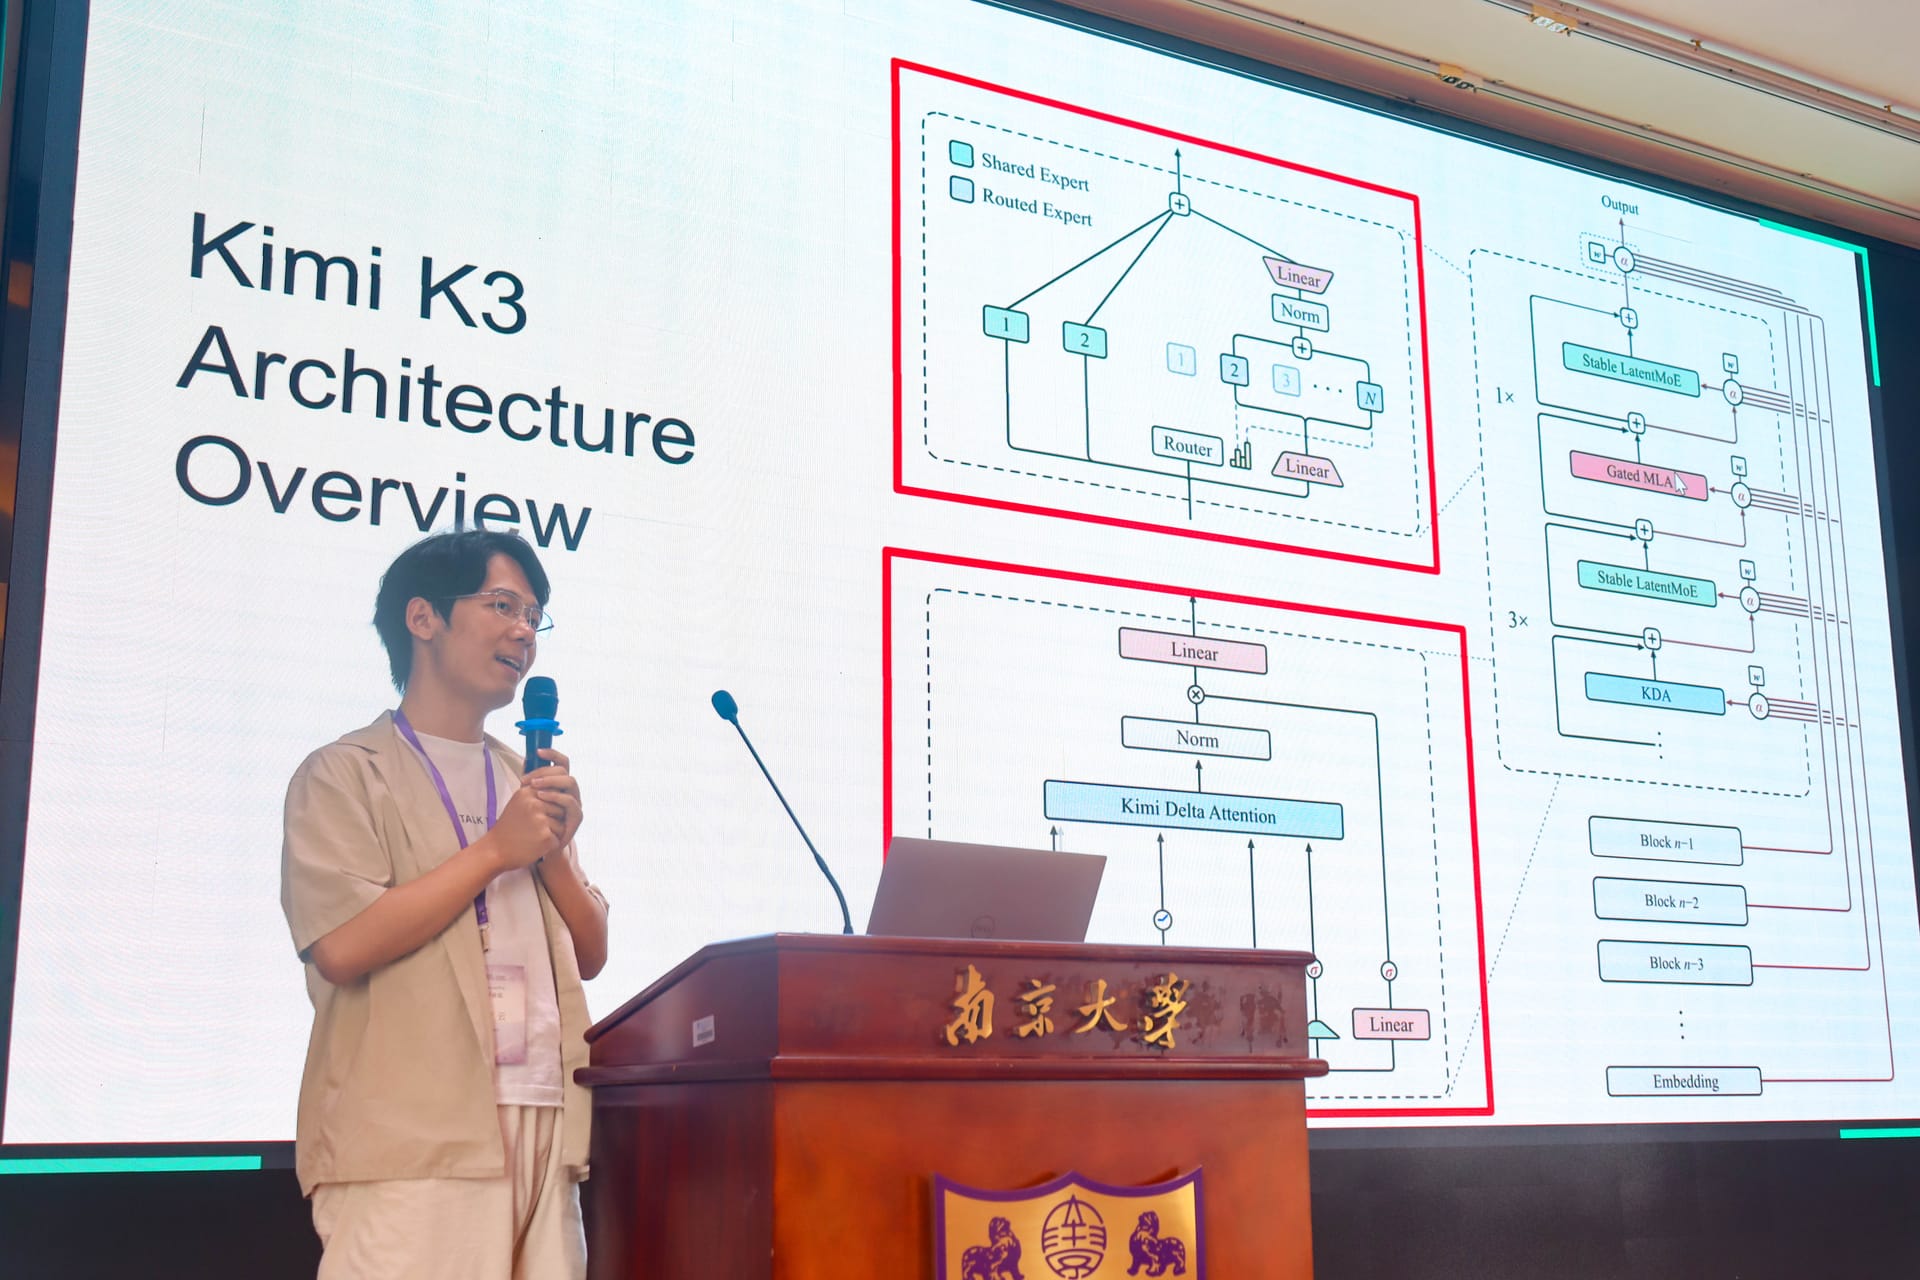
来自 Inferact 的工程师朱江云分享了在 vLLM 推理引擎中支持 Kimi K3 模型的工程实践。作为最被广泛使用的开源推理引擎,vLLM 是模型、硬件、引擎三条快速演进轴线的“开放交点”,而 K3 的混合架构(KDA 线性注意力)给 KV Cache 管理带来了全新挑战——KDA 状态不可回滚,打破了 vLLM 中 KV cache 只能追加的基本假设。
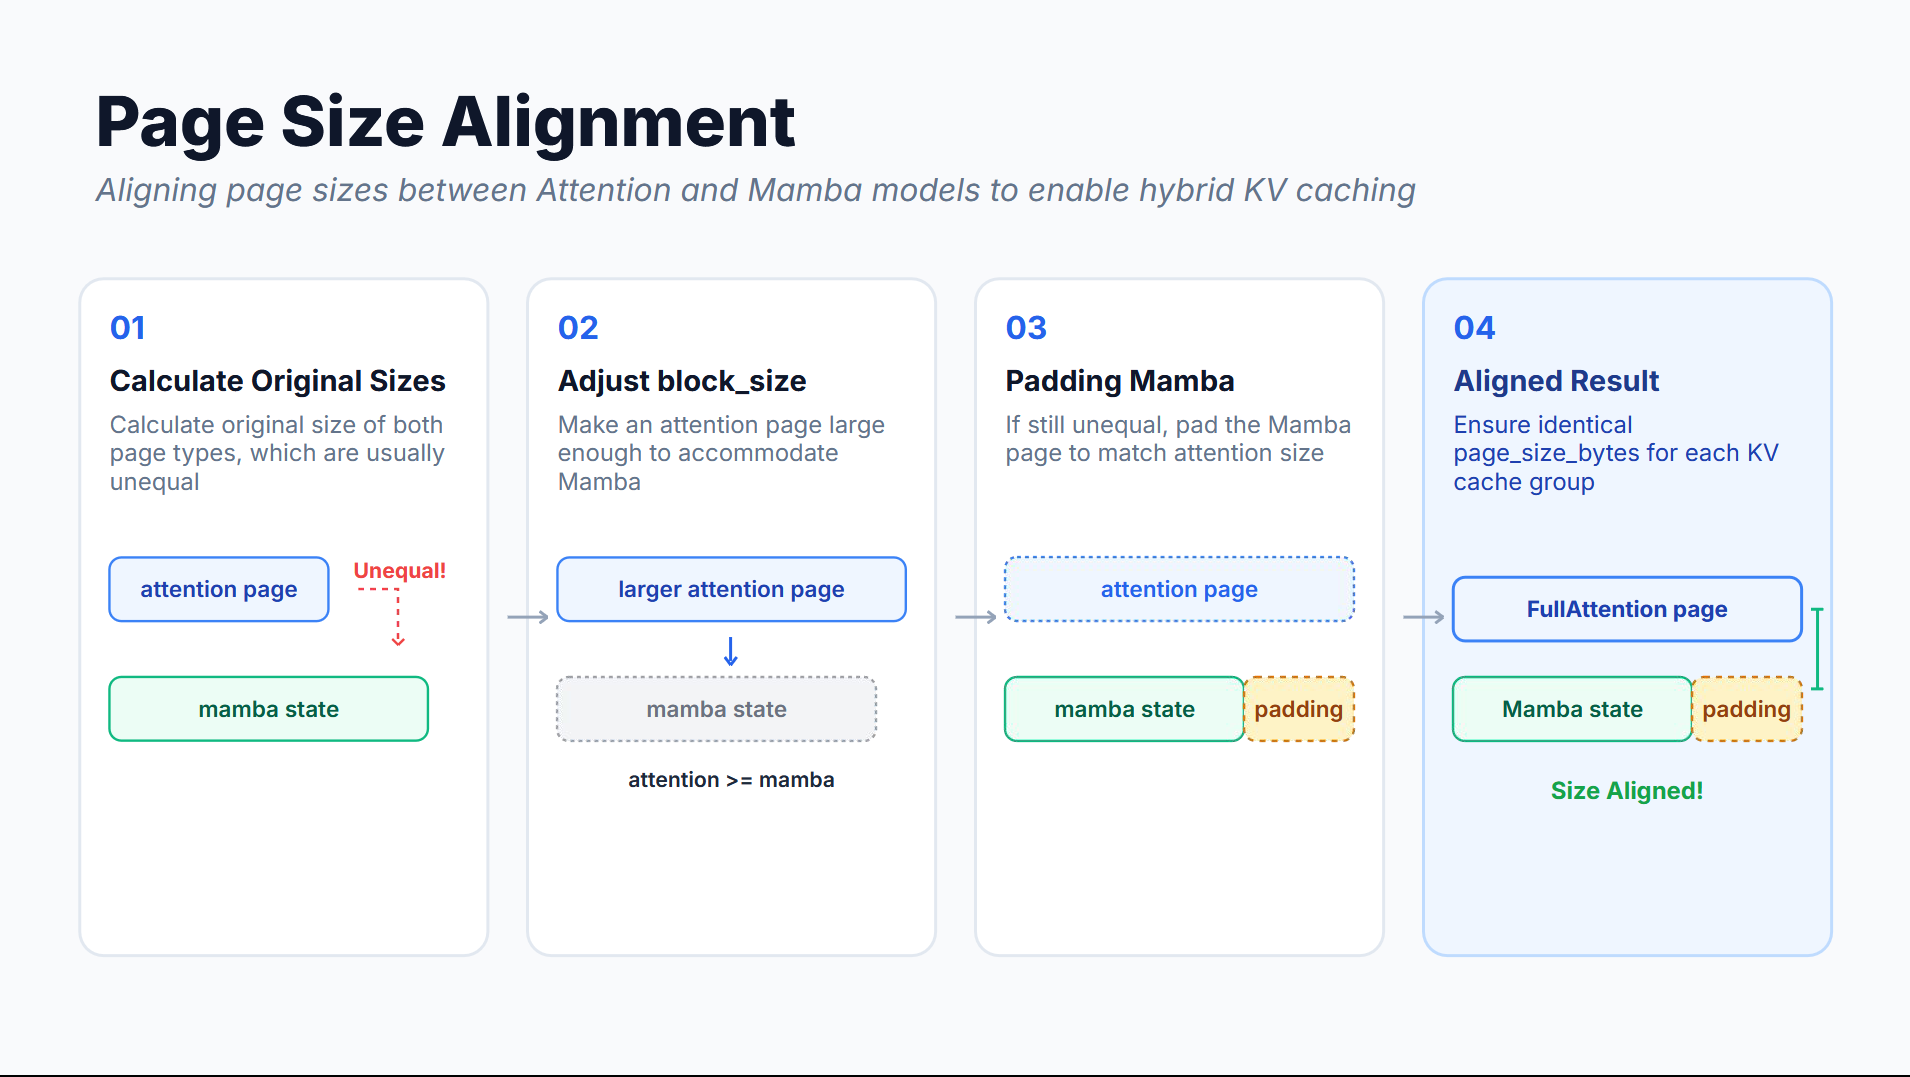
为此,团队设计了 Hybrid Memory Allocator,页大小取各类缓存分配大小的最小公倍数,实现无碎片混合分配;通过 Block-aligned Scheduling 将 prefill chunk 对齐到 block 边界,让线性注意力模型也能享受 prefix caching,且模型层零改动。针对 KDA 状态比 MLA cache 大约 600 倍、长共享前缀难以命中缓存的痛点,又提出 Partial Cache Hit,引入 hash_block_size 解耦命中粒度 (vLLM RFC #45702)。
此外,报告还介绍了 PDL(Programmatic Dependent Launch)相邻 kernel 重叠执行、Tail MoE 优化与 DSpark 等低延迟技术。日新月异的大模型技术发展为相关的领域都带来了快速更迭的压力,而开源协作正是让模型、硬件、引擎三方同处一室的引力。
本条由 Kimi K3 模型亲自解读。
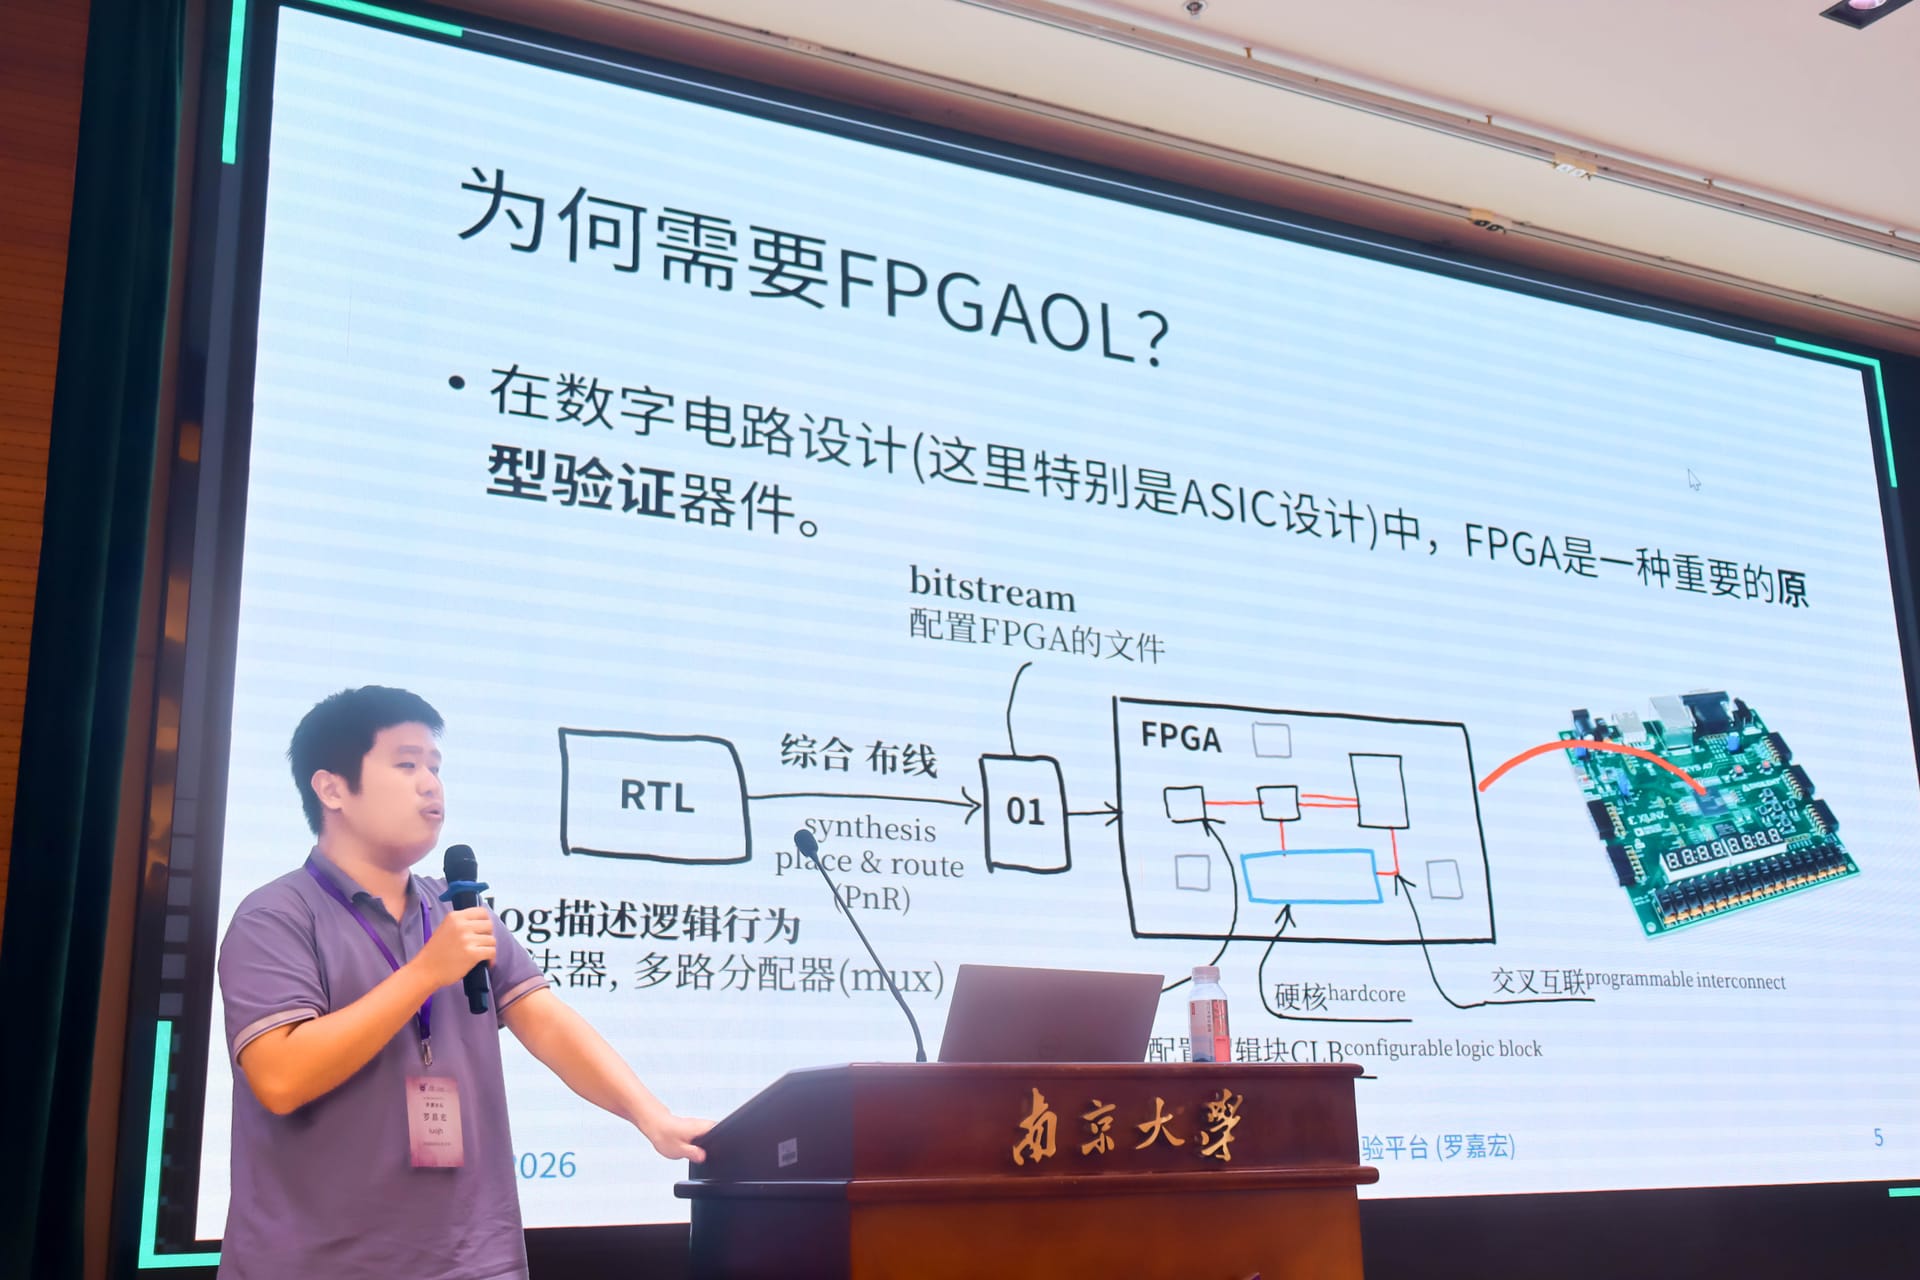
FPGAOL Next下一代 FPGA 实验平台
中国科学技术大学化学物理系的罗嘉宏带来了 FPGA 在线实验平台的新一代设计。传统 FPGA 教学板卡价格昂贵、易损坏(实验室损坏率约 1%–2%)、开发环境不统一、助教批改困难;FPGAOL 以“FPGA as a Service”的思路,将板卡集中部署在机房,学生通过网页即可远程烧录比特流、进行 I/O 交互,在线评测系统自动检查实验结果,大幅降低教学成本。
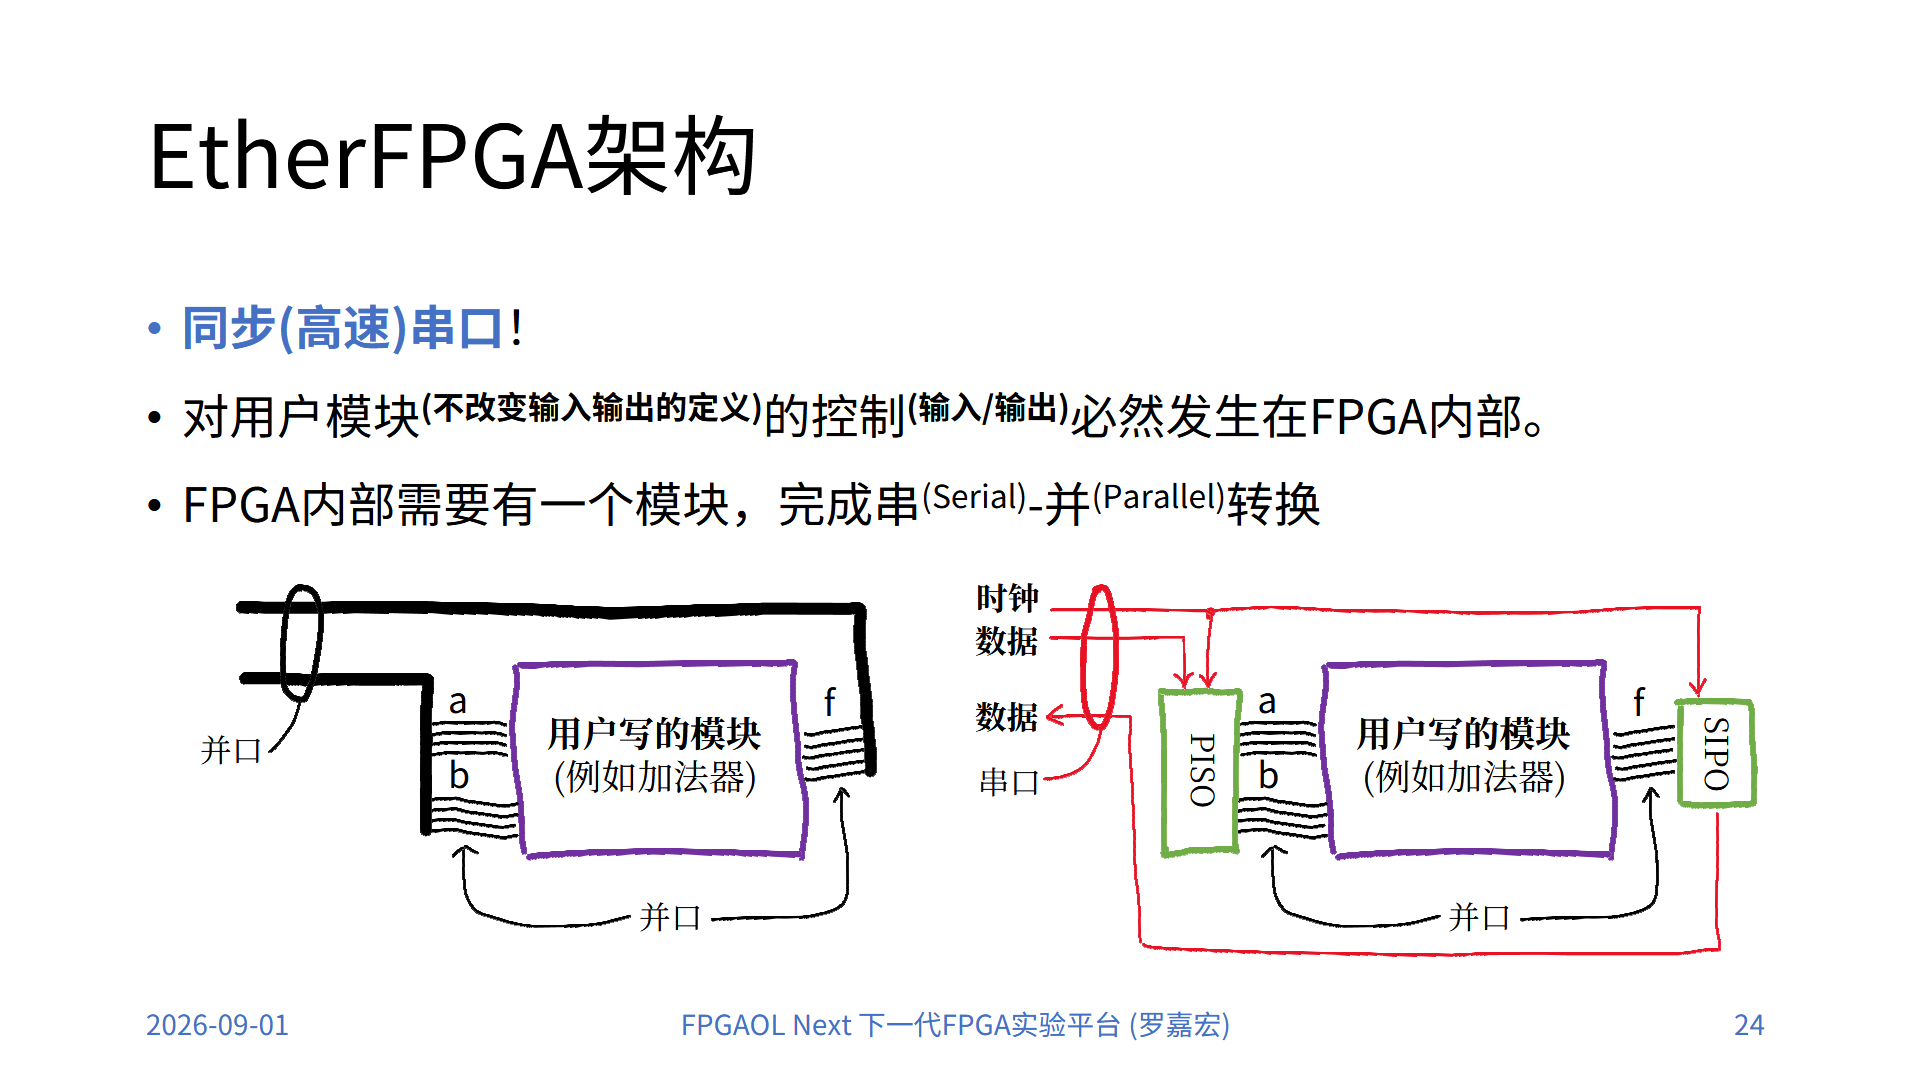
新一代 EtherFPGA 架构用 STM32 + 同步高速串口取代旧版并口,通过串并转换(PISO/SIPO)解除 IO 线数限制;PXE 式网络启动、SRAM 内执行、Flash A/B 双分区加 failsafe 位防刷砖,工程细节拉满。应用这一架构的新系统 FPGAOL Next 即将上线。
在报告的最后,罗嘉宏还呼吁全面转向 yosys + nextpnr + chipdb + openFPGALoader 的开源工具链,并针对当下FPGA工具链的封闭现状发出灵魂拷问:“我们究竟是在‘购买’FPGA,还是在‘租用’FPGA 的开发权?”
大模型公共服务平台建设
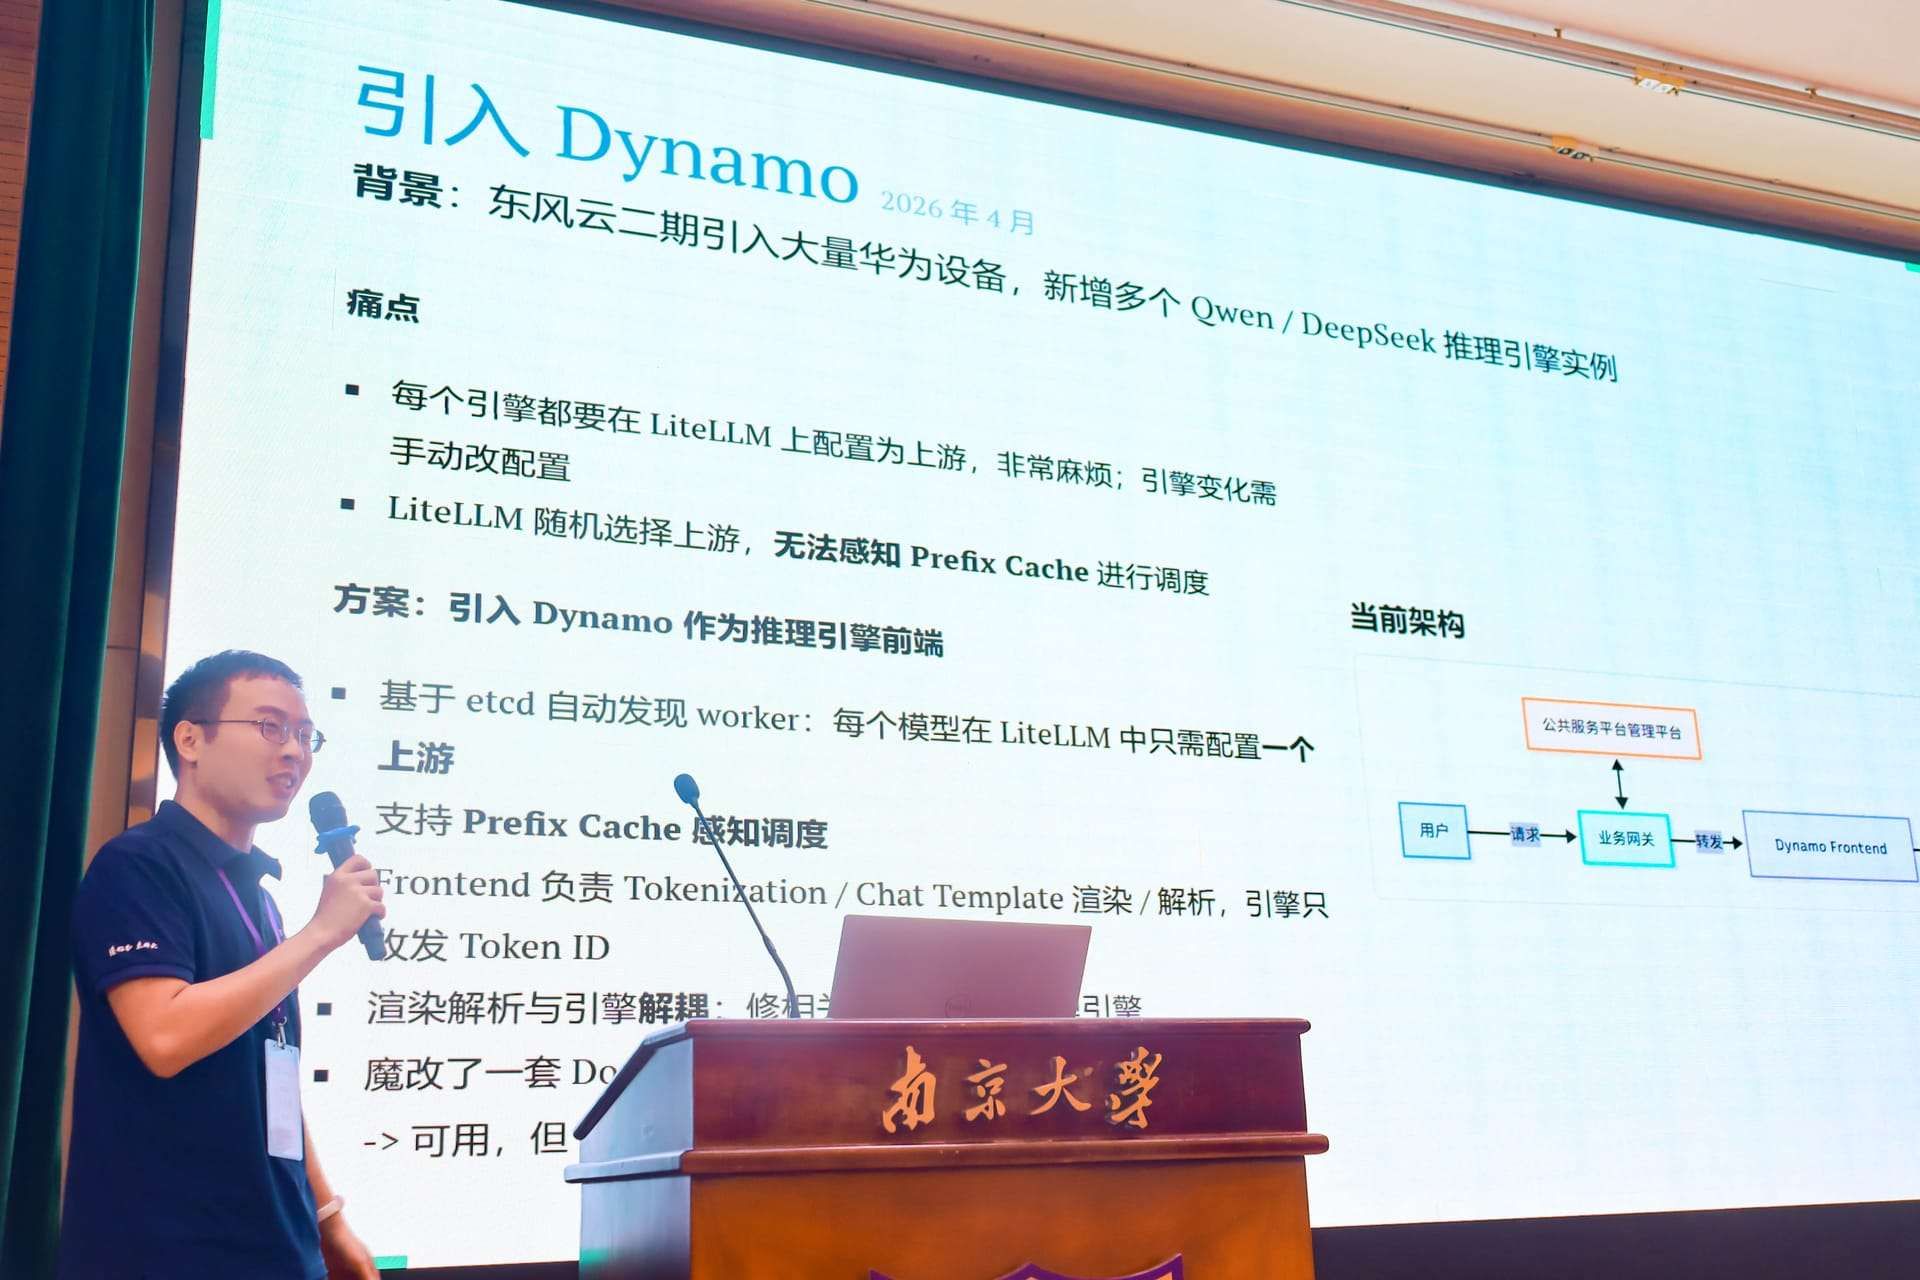
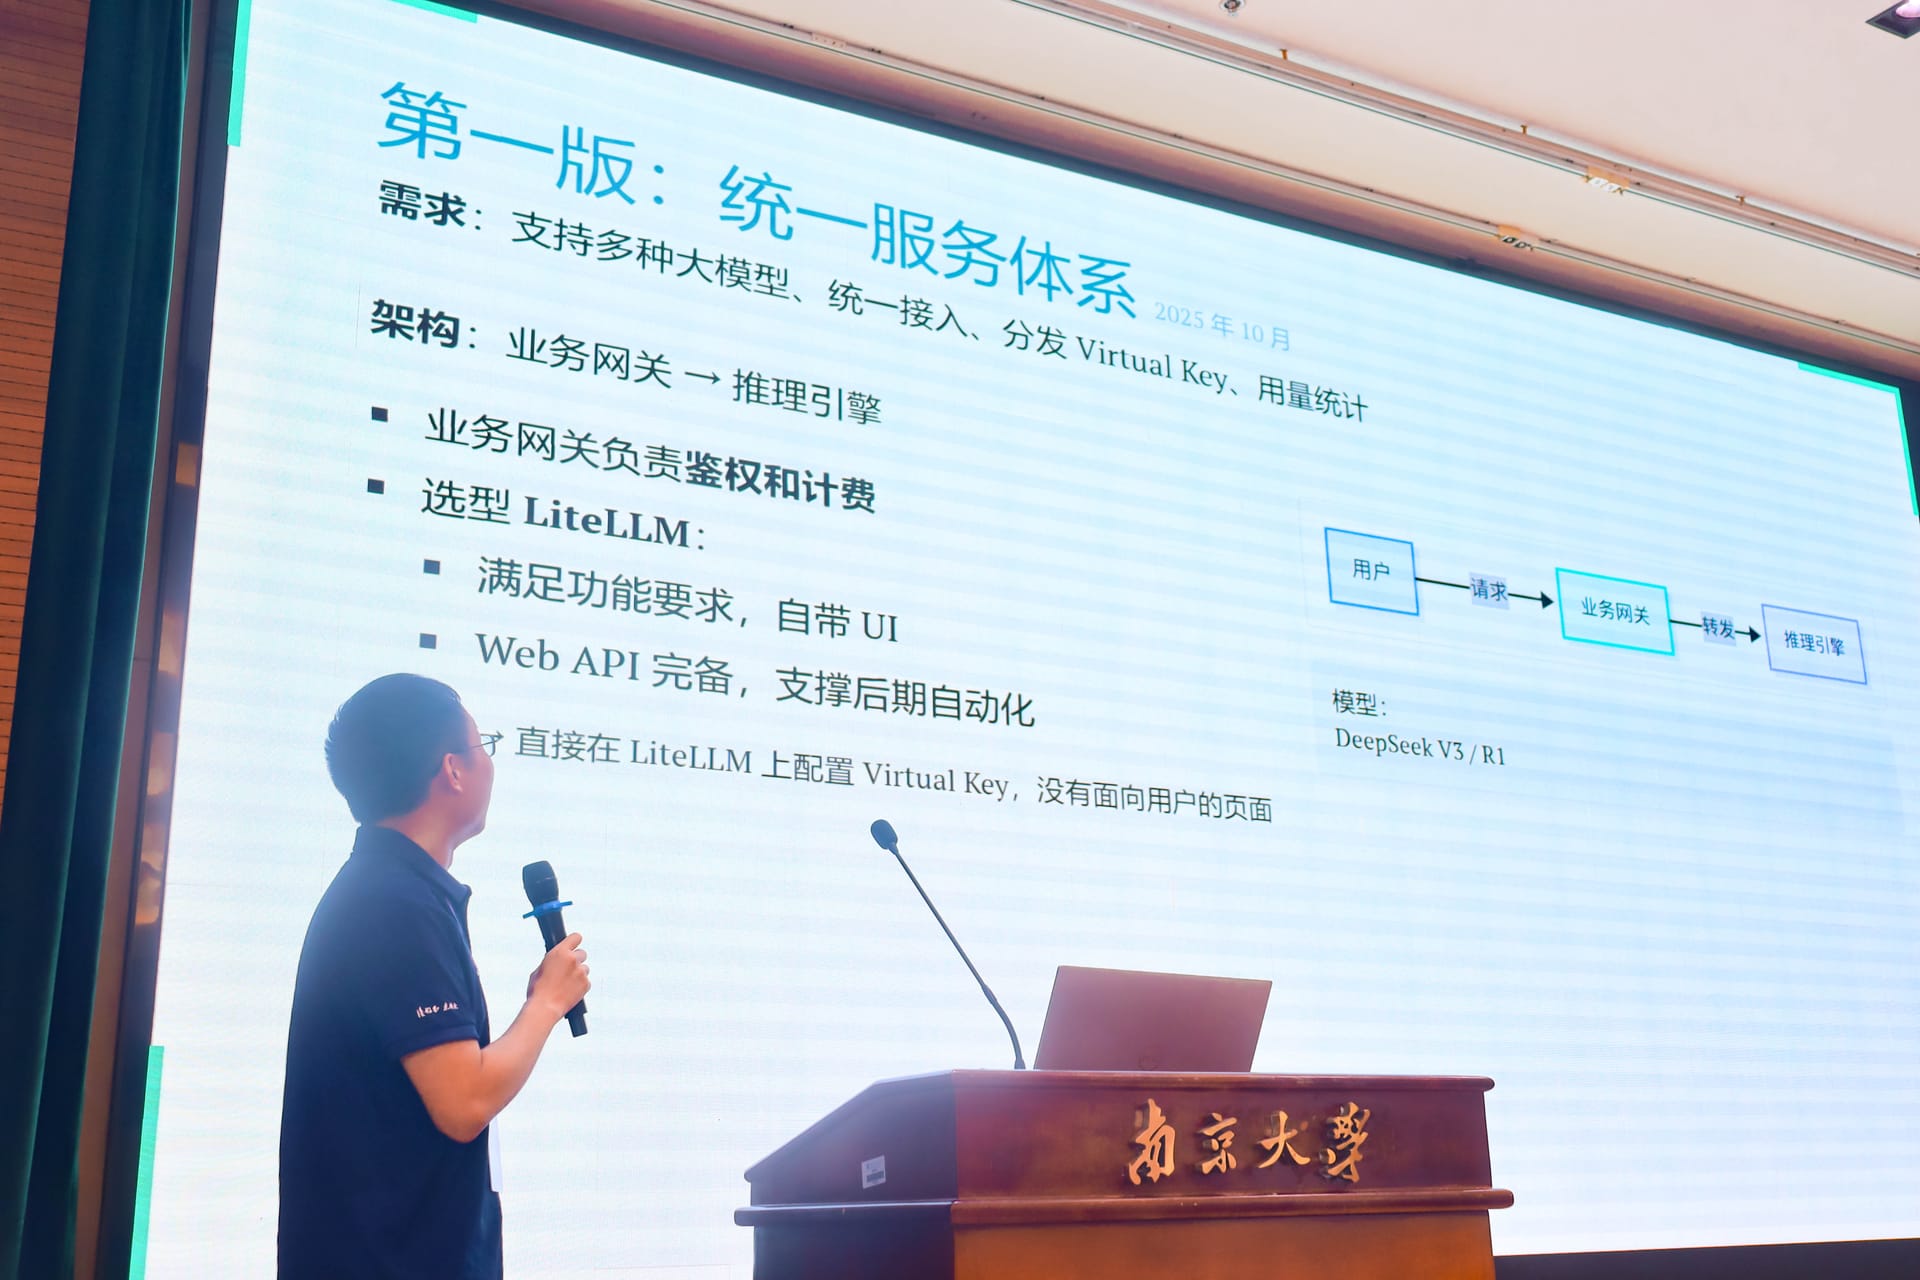
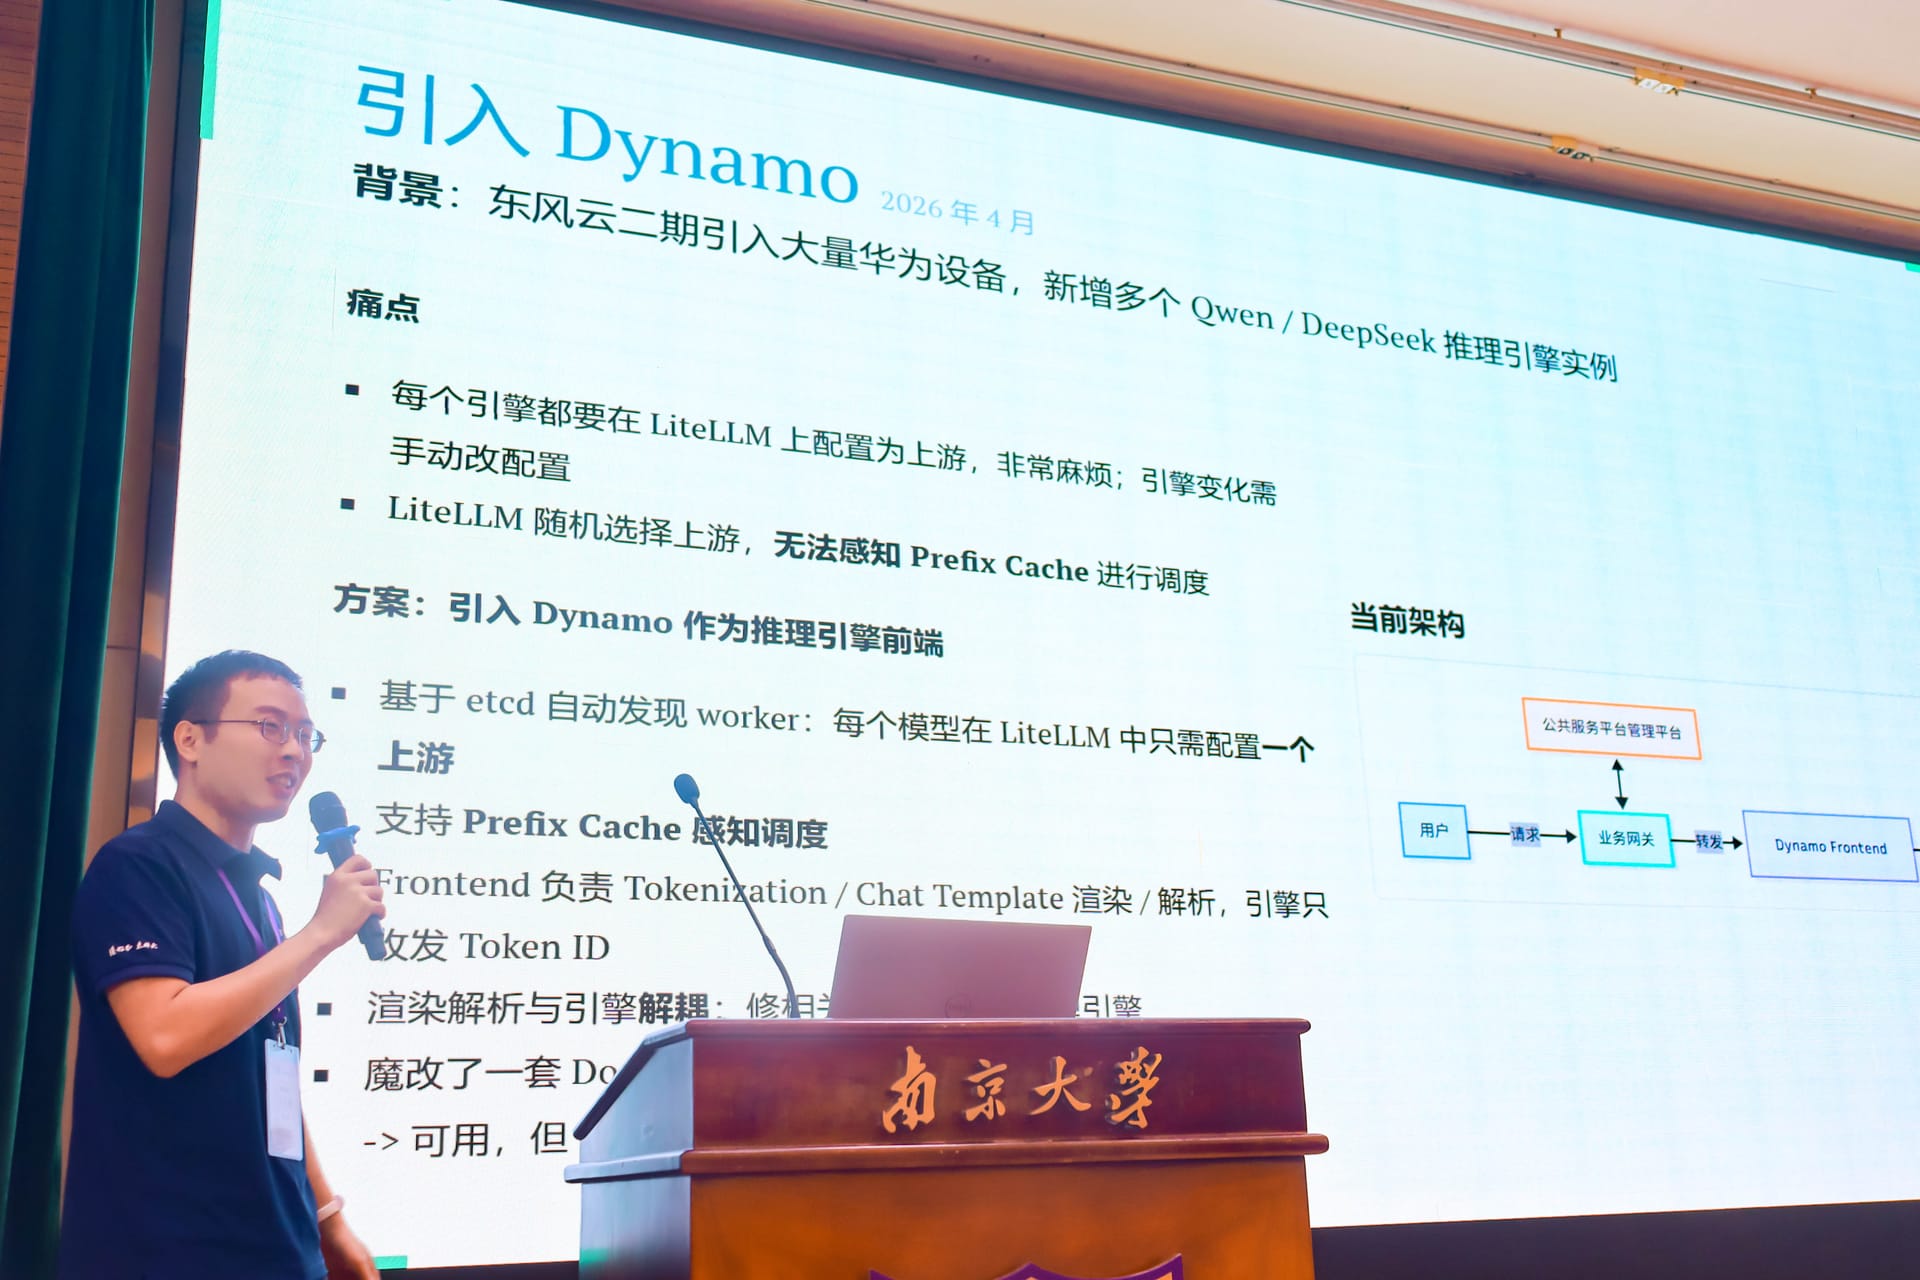
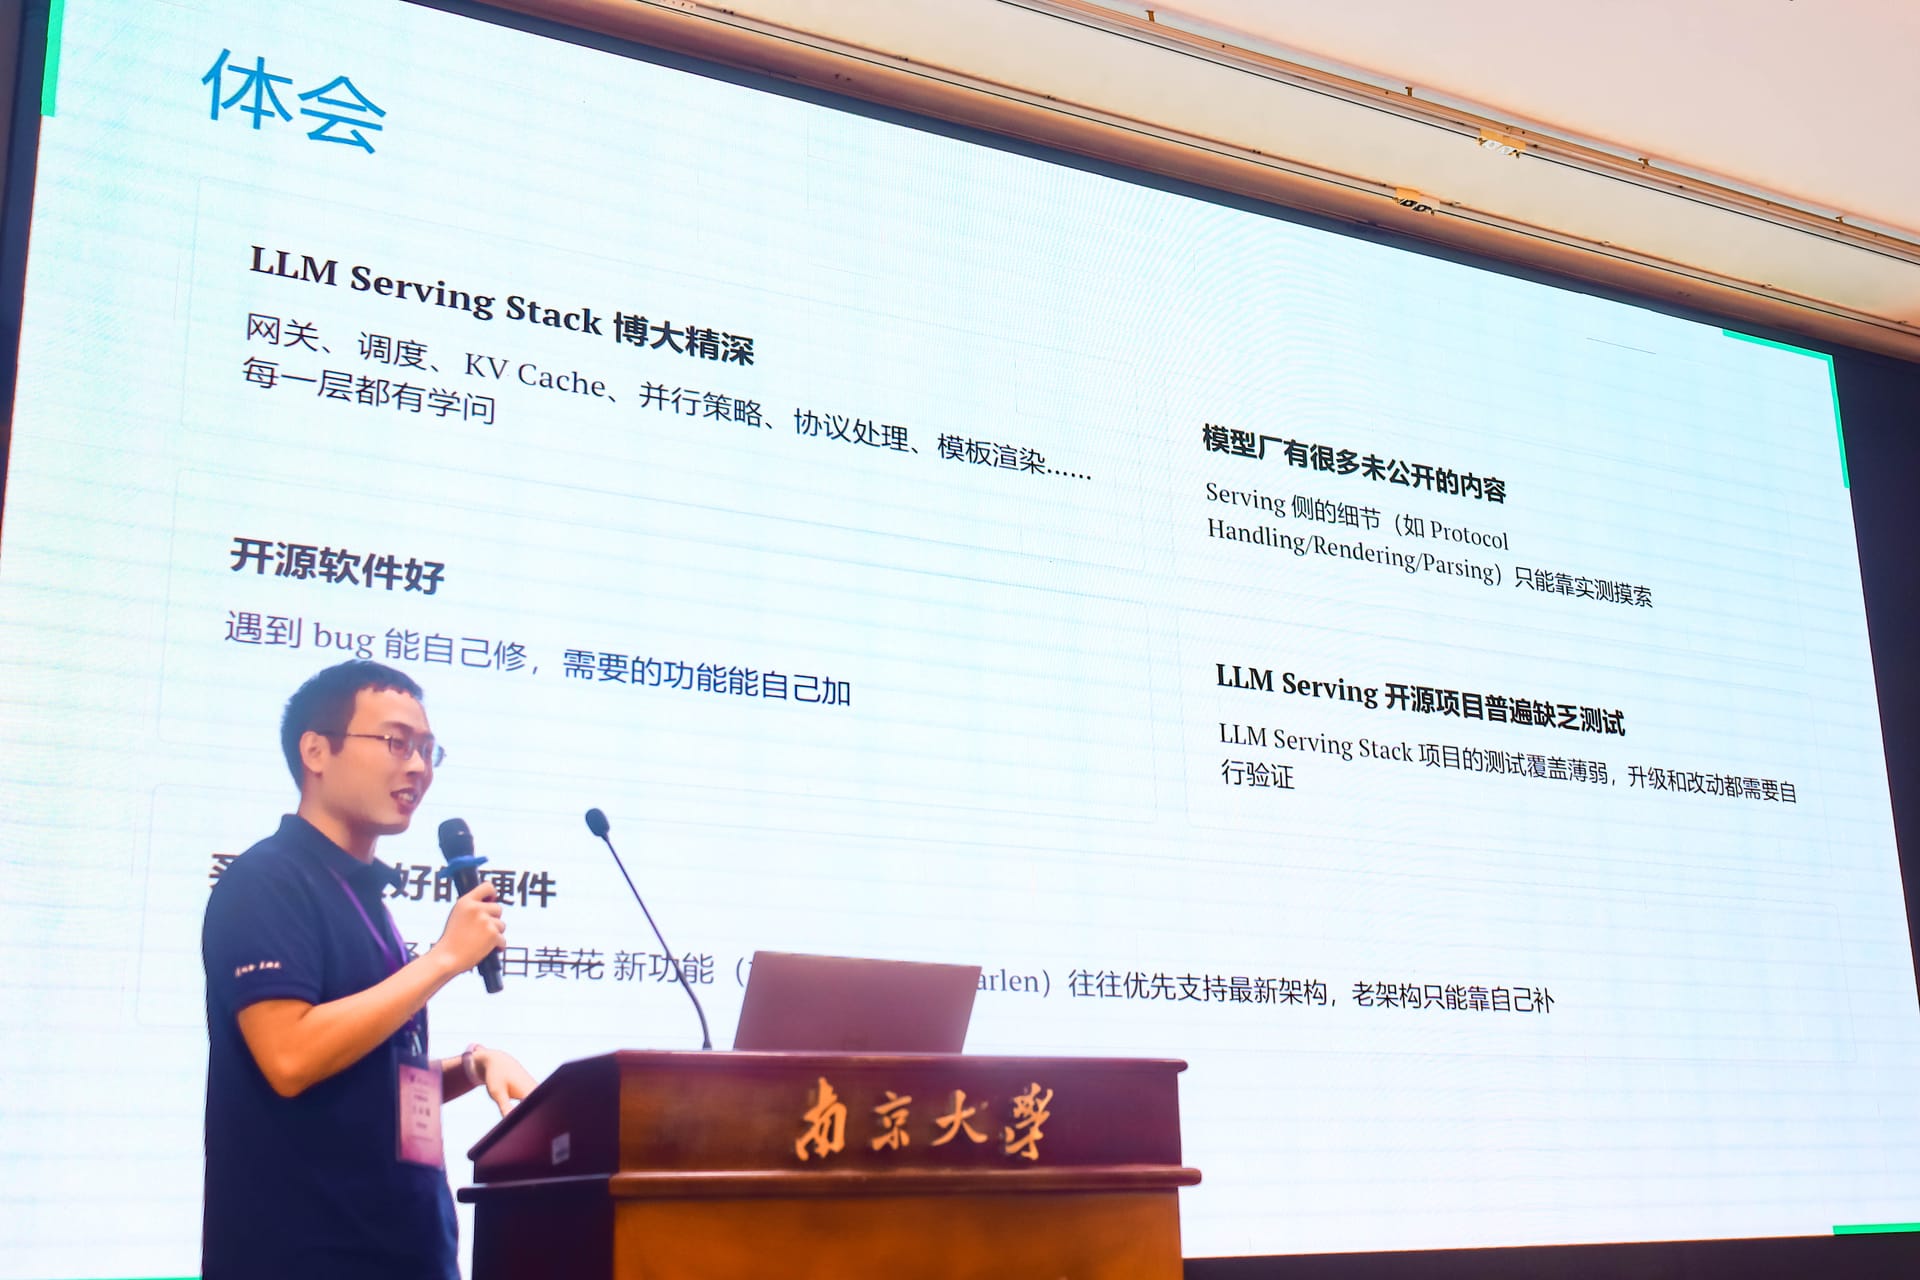
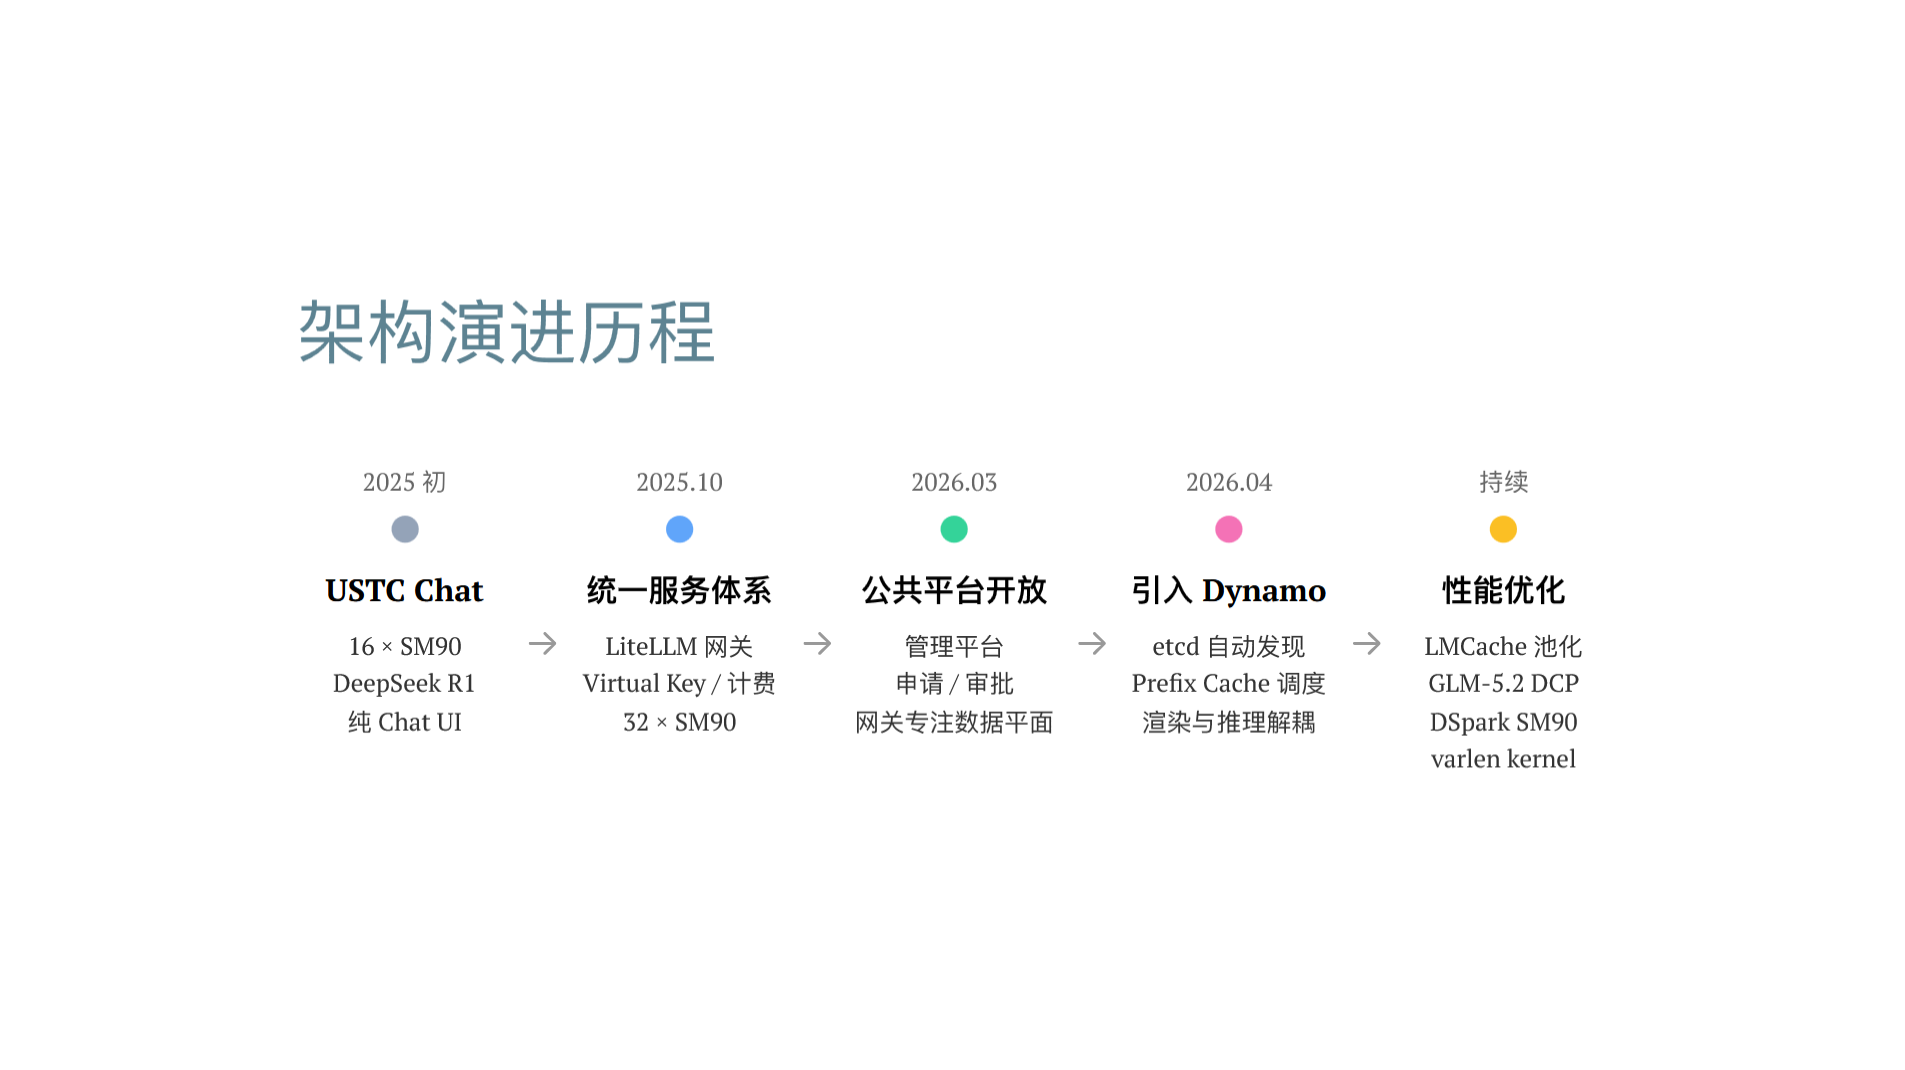
中国科学技术大学的王永福分享了 USTC 大模型公共服务平台 (chat.ustc.edu.cn) 的建设实践与踩坑记录。平台架构历经四次演进:从 LiteLLM 统一网关,到新增申请审批管理平台,再到引入 NVIDIA Dynamo 推理前端,并持续叠加 LMCache、DCP、DSpark 等性能优化——引入 LMCache 后,Prefix Cache 命中率从 72.3% 提升到 96.8% 。
更难能可贵的是回馈上游的开源贡献:为 GLM-5.2(744B 参数、1M 上下文)改造 vLLM DCP 以支持 DSA,提交 PR #46178;为 DeepGEMM 补出 SM90 varlen kernel,kernel 提速 1.8~1.9 倍。报告后半,王永福分享了亲历的 7 个 self-host LLM 踩坑实录:RoCE ARP 请求风暴、鲲鹏 920 缺少 ARMv8.3 扩展导致 SIGILL、FlashInfer 采样 kernel 卡死等,引发全场共鸣。
最后,王永福简单介绍了下平台现状。目前,该平台日活 500~1000 人,日处理 Token 超 100 亿、日请求约 50 万,大模型已深度融入日常科研教学。
e-Science中心的开源基础设施
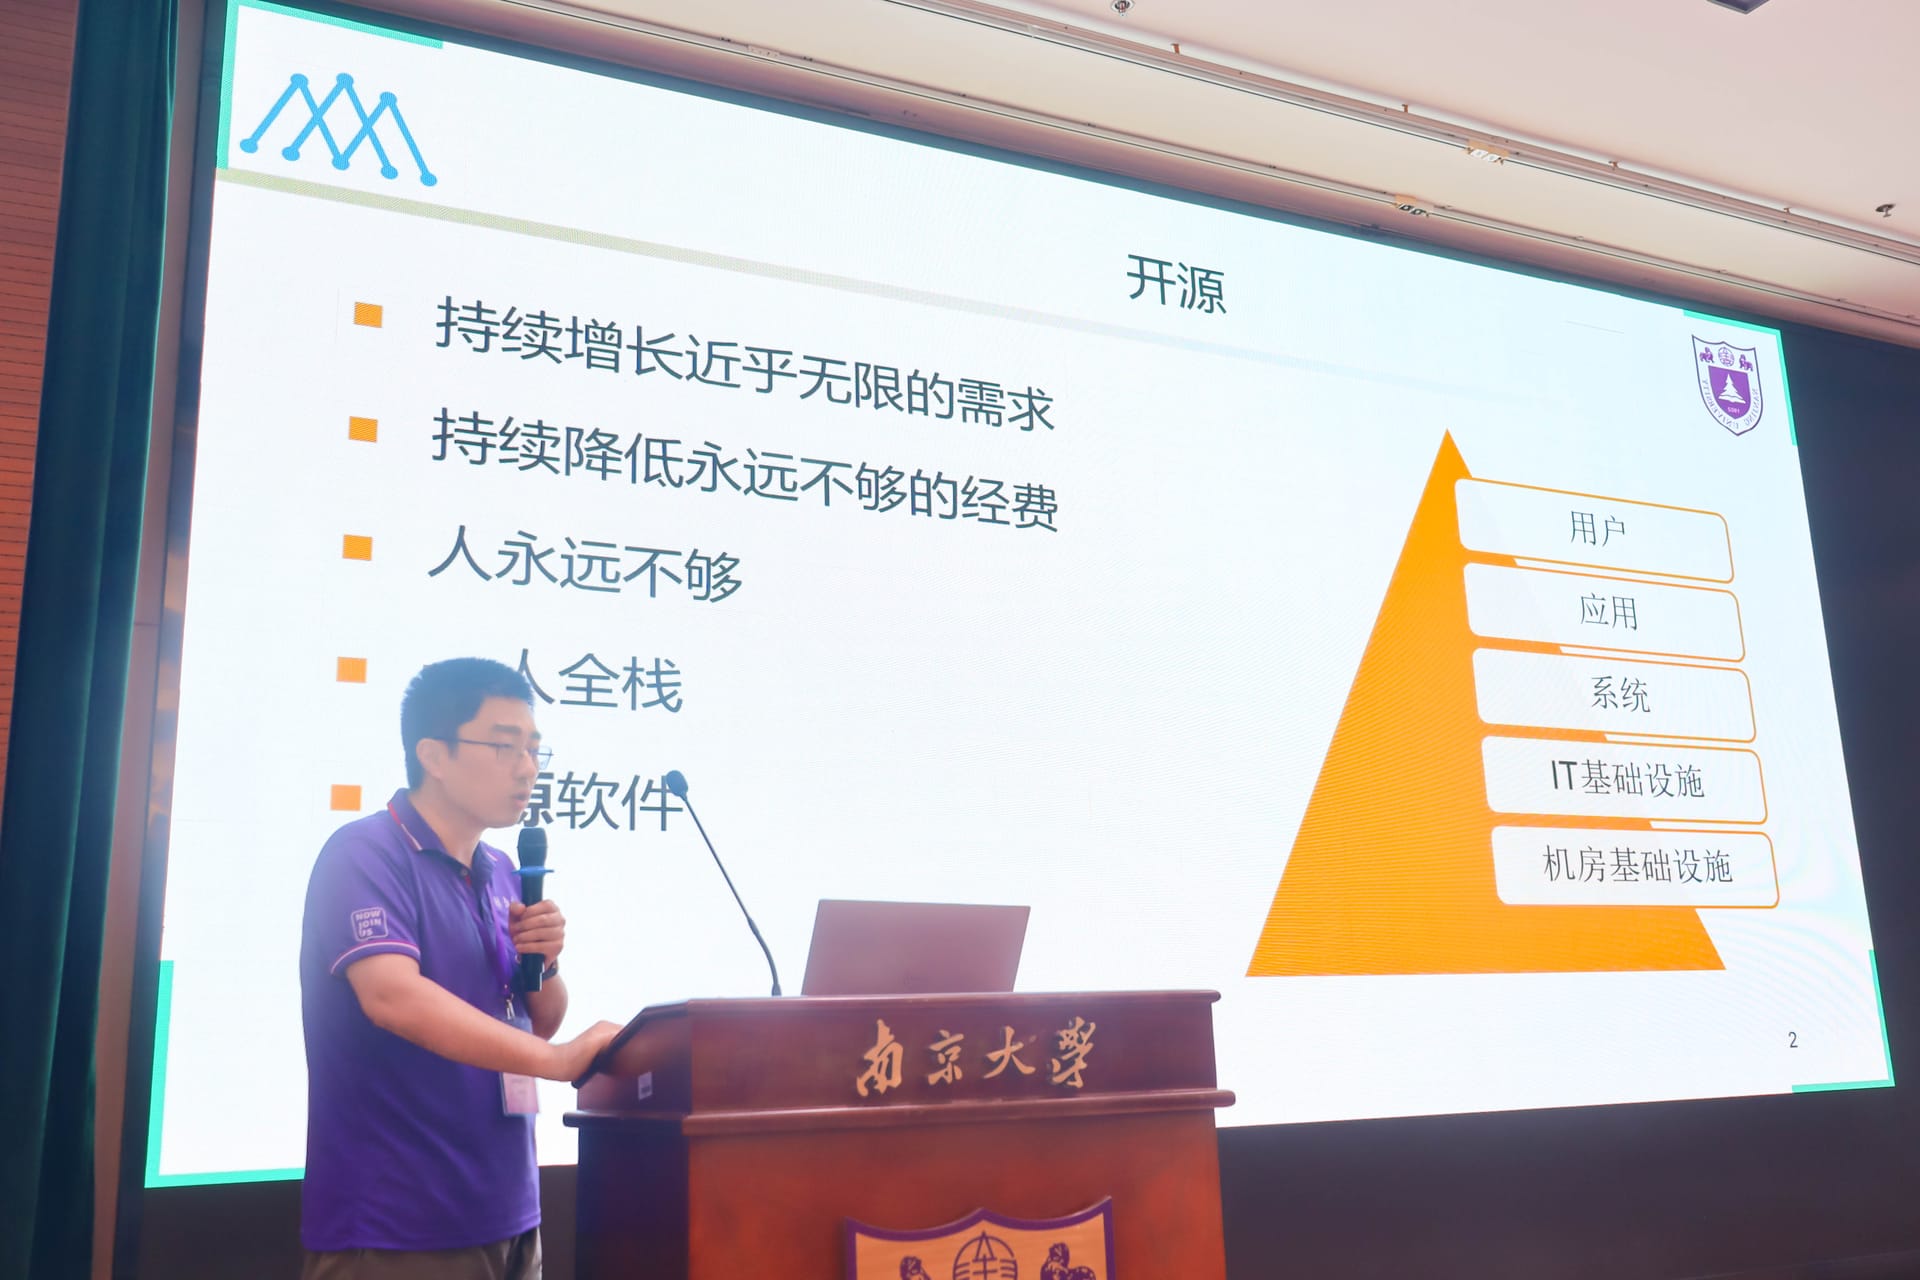
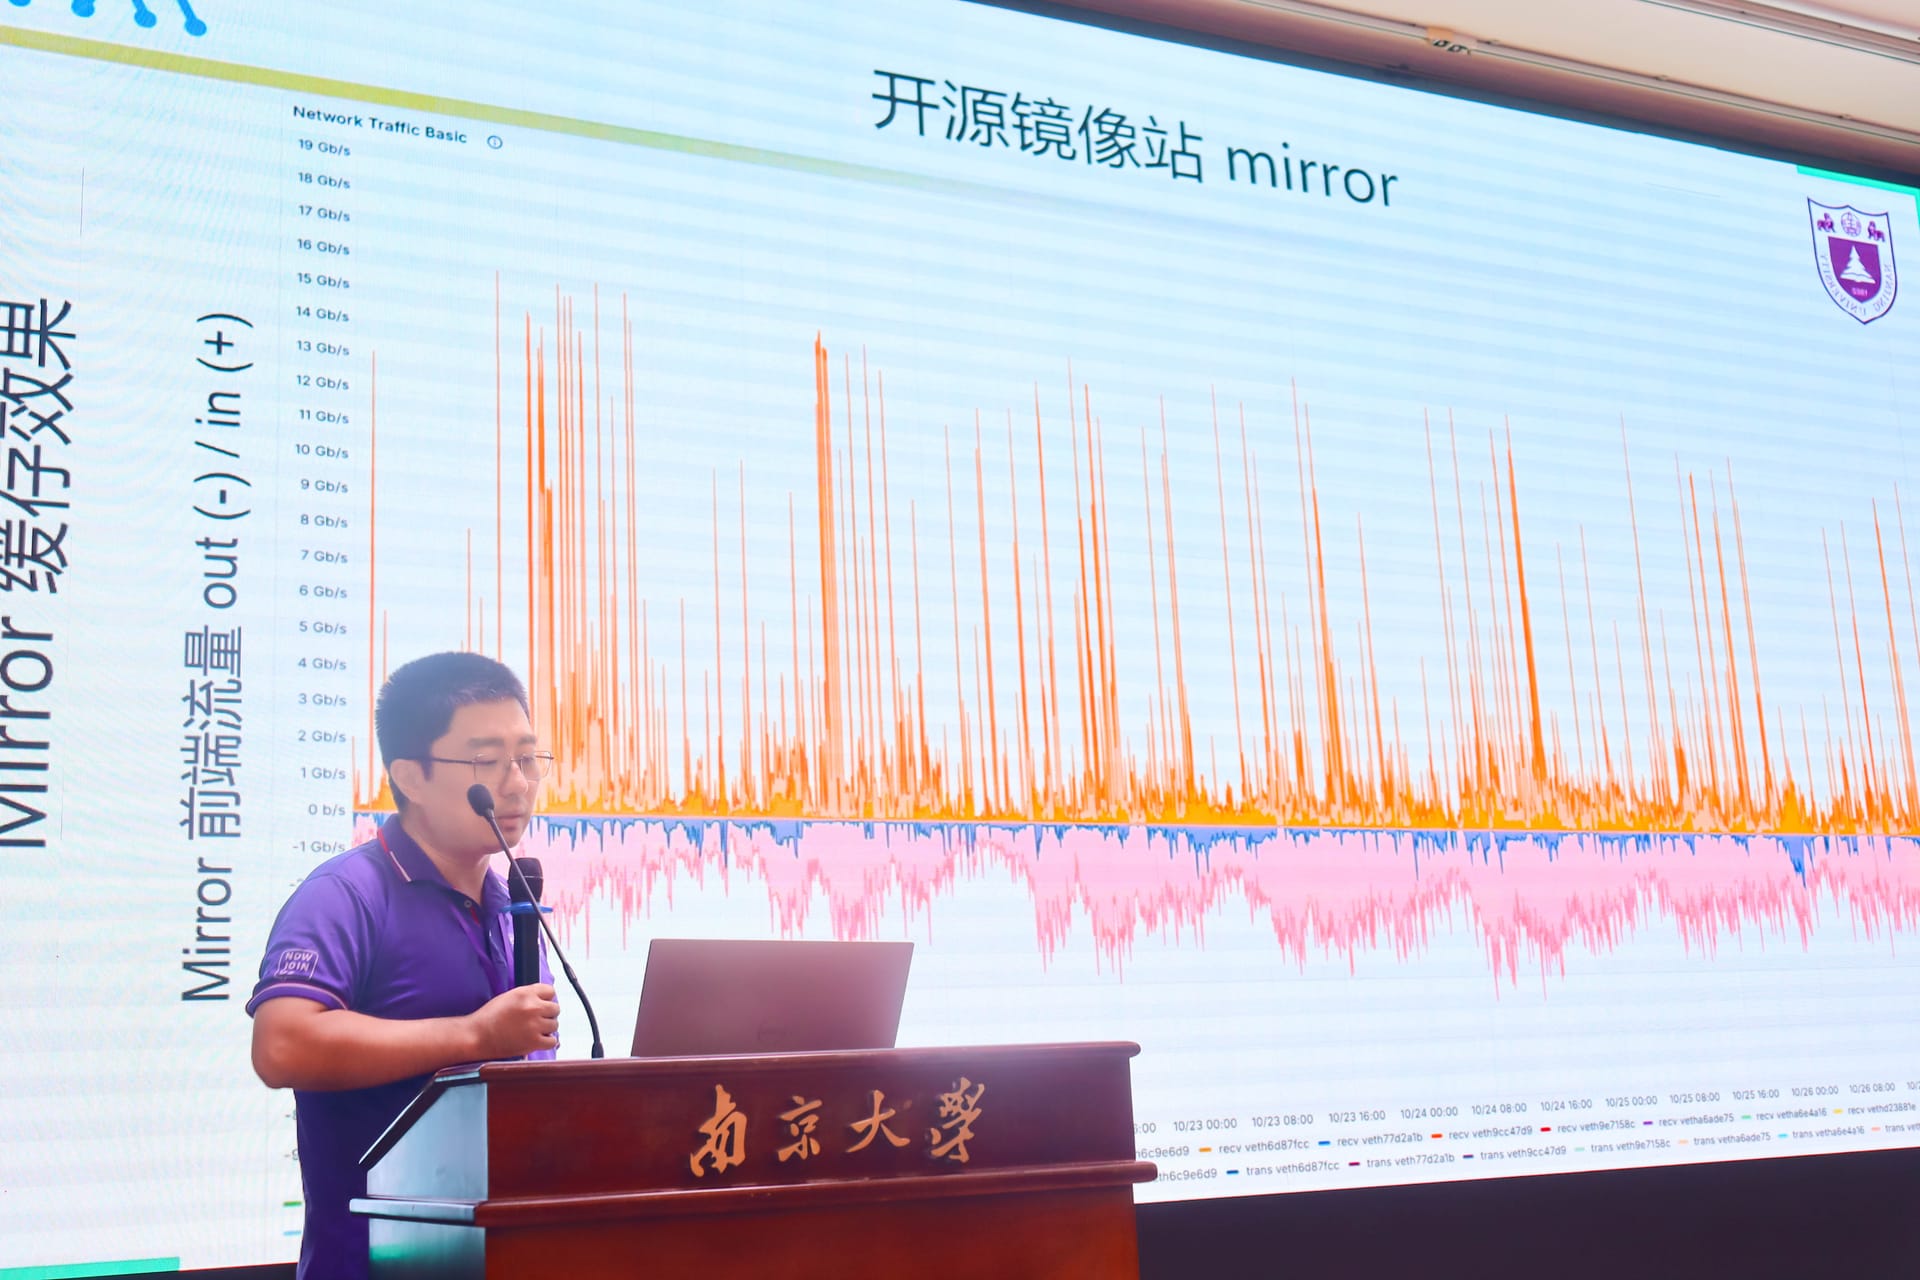
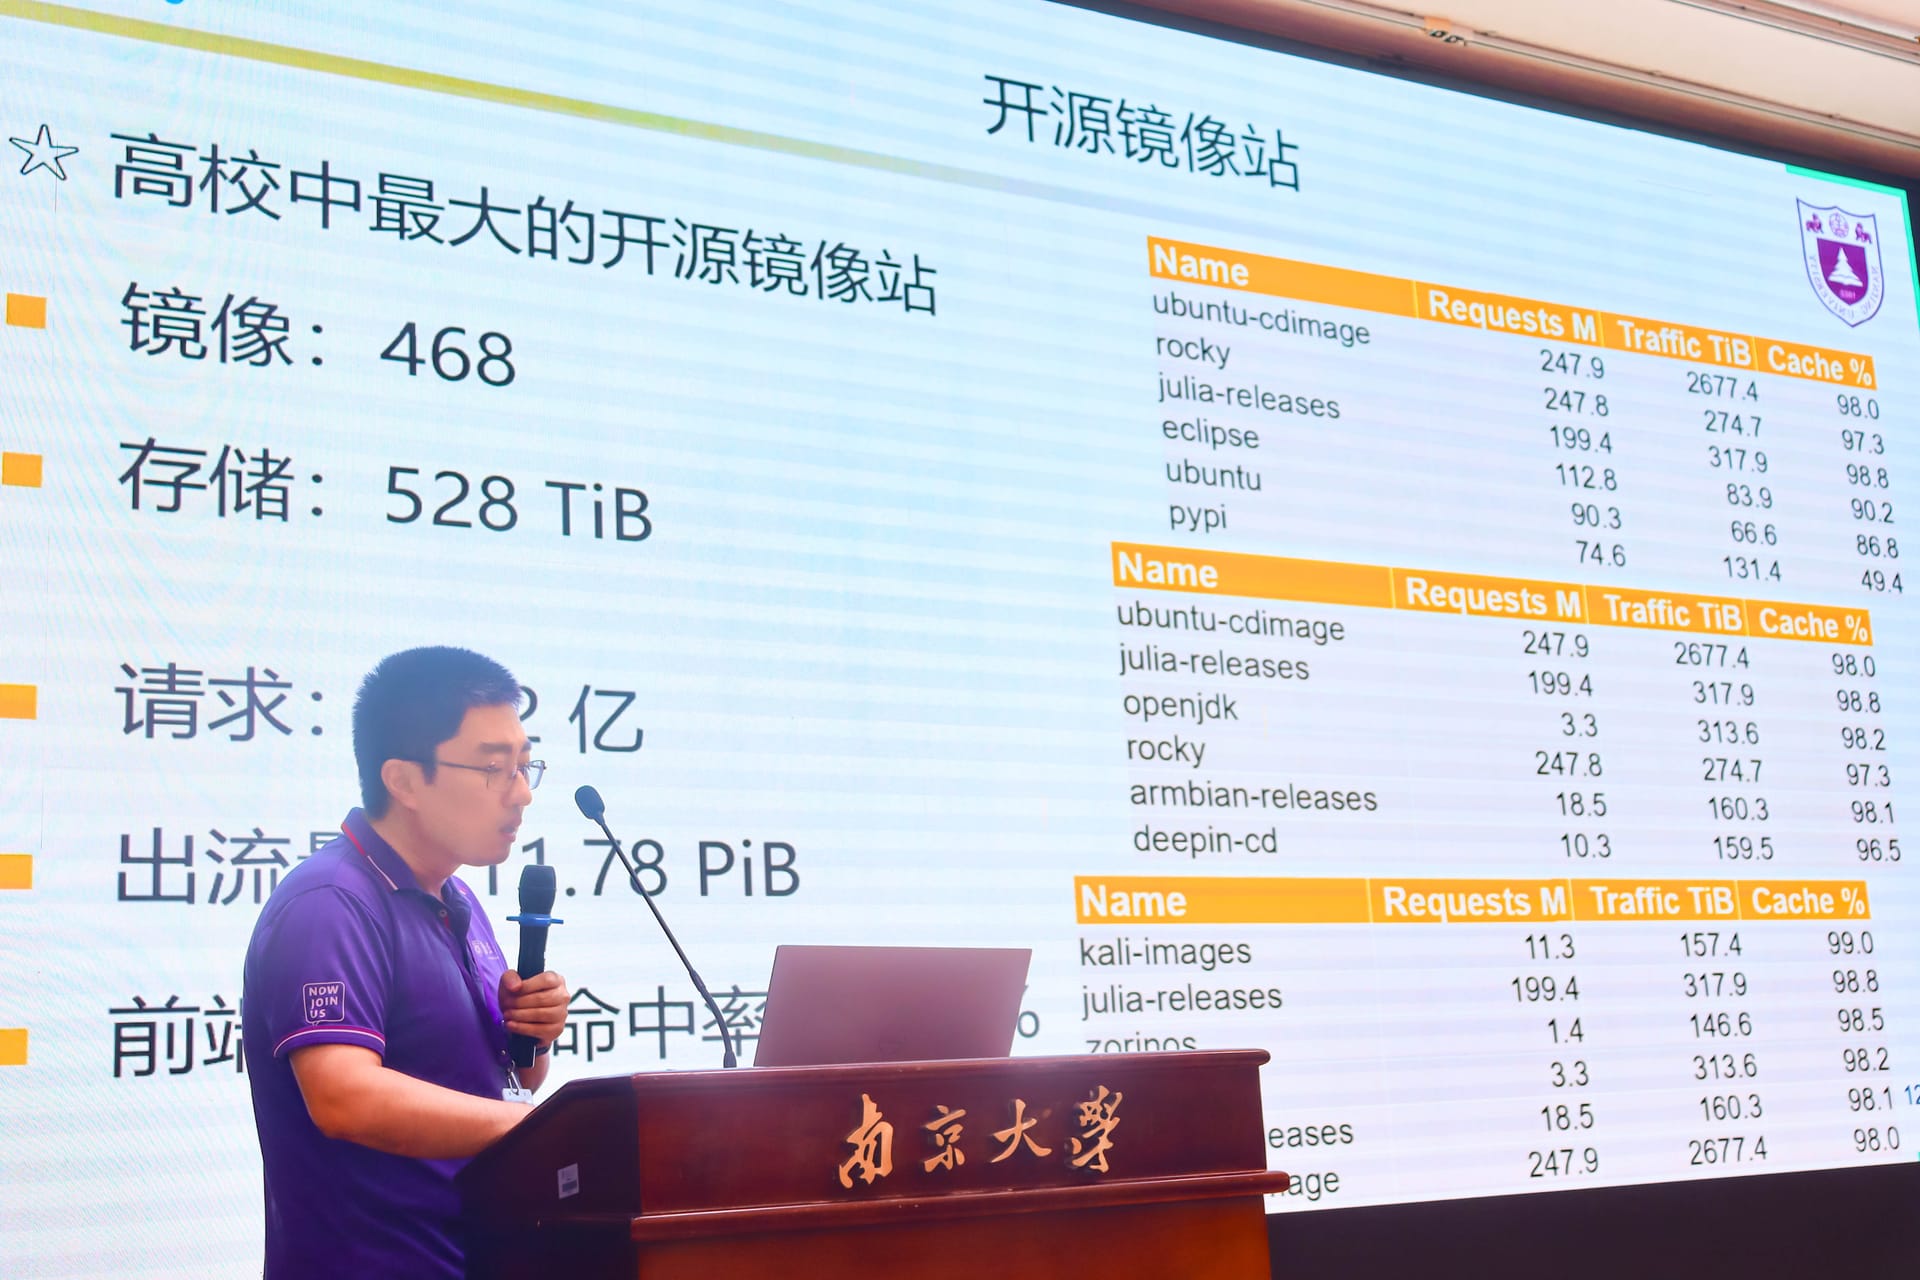
最后,姚舸分享了 e-Science 中心在有限经费和人力的条件下,用开源软件建设 e-Science 科研信息化服务生态的实践。南京大学开源镜像站已是高校中规模最大的镜像站:468 个镜像、存储 528 TiB,月独立 IP 约千万。
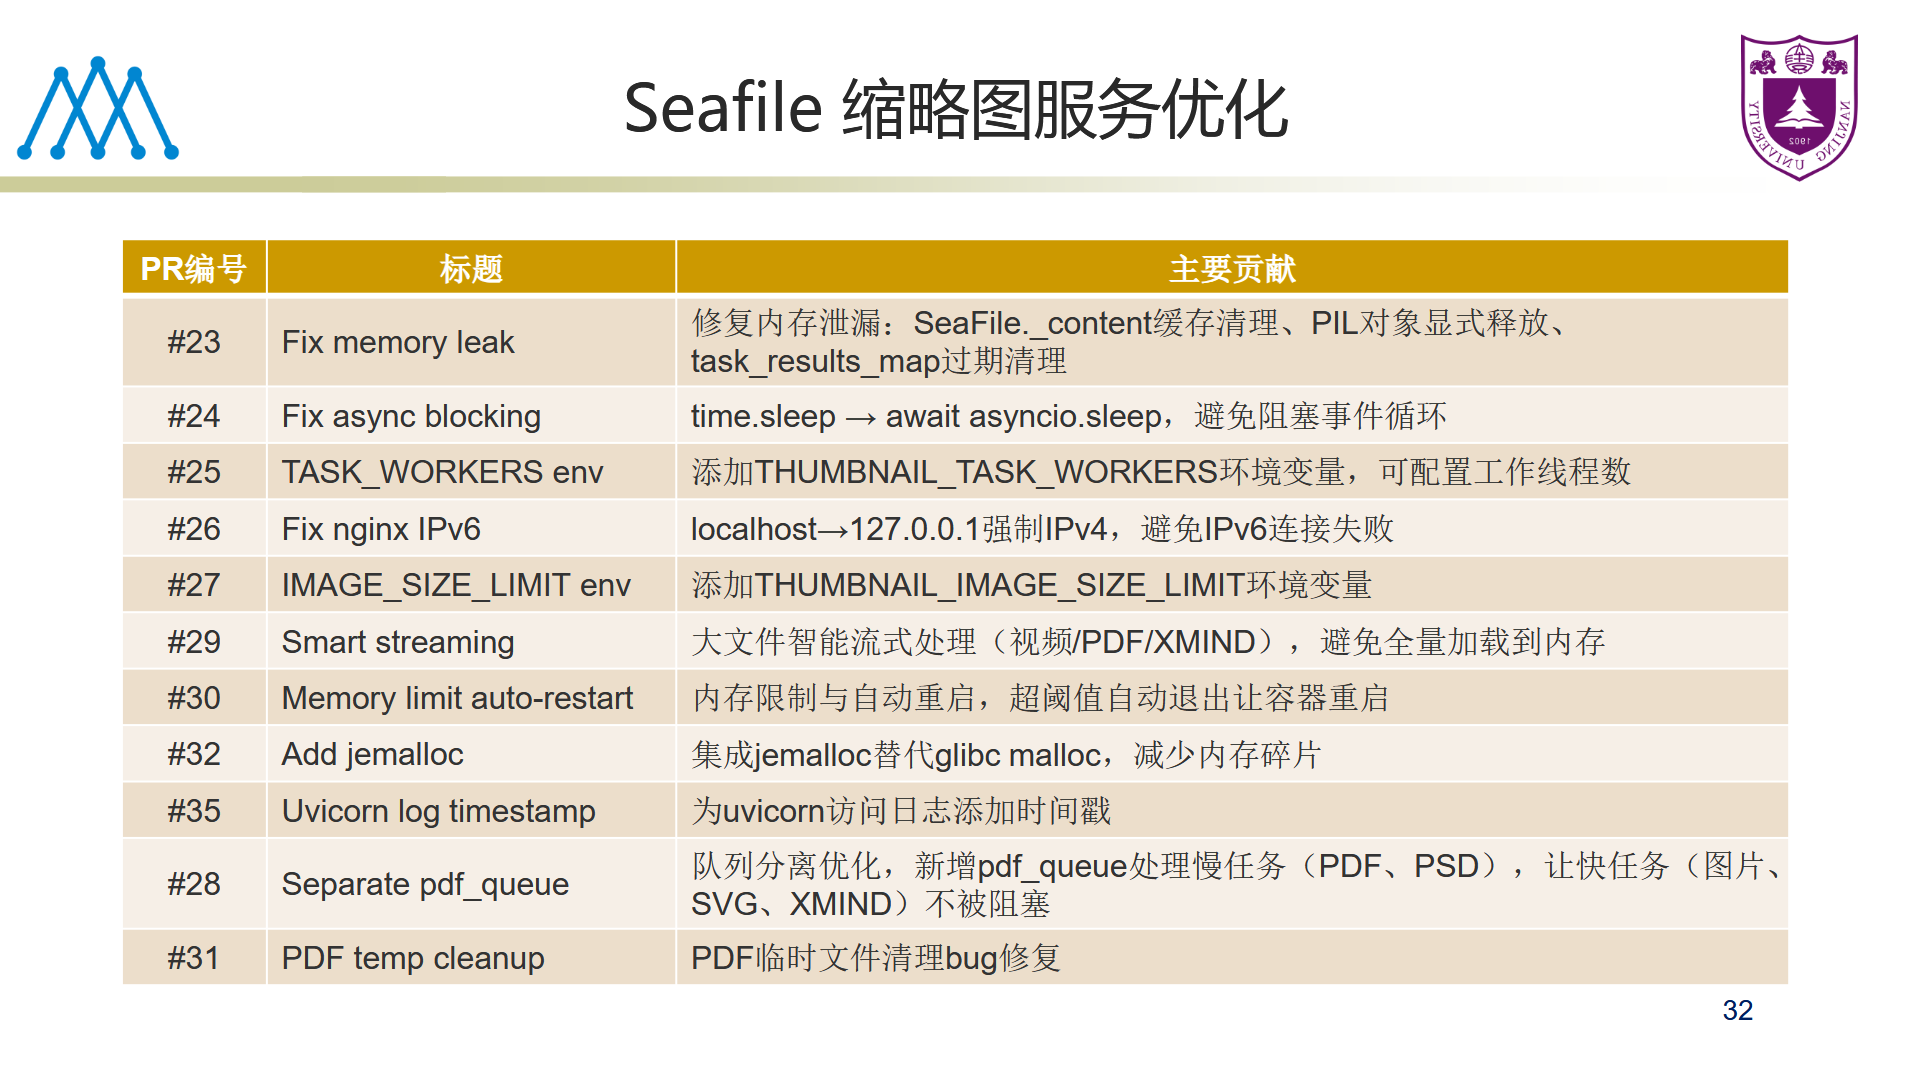
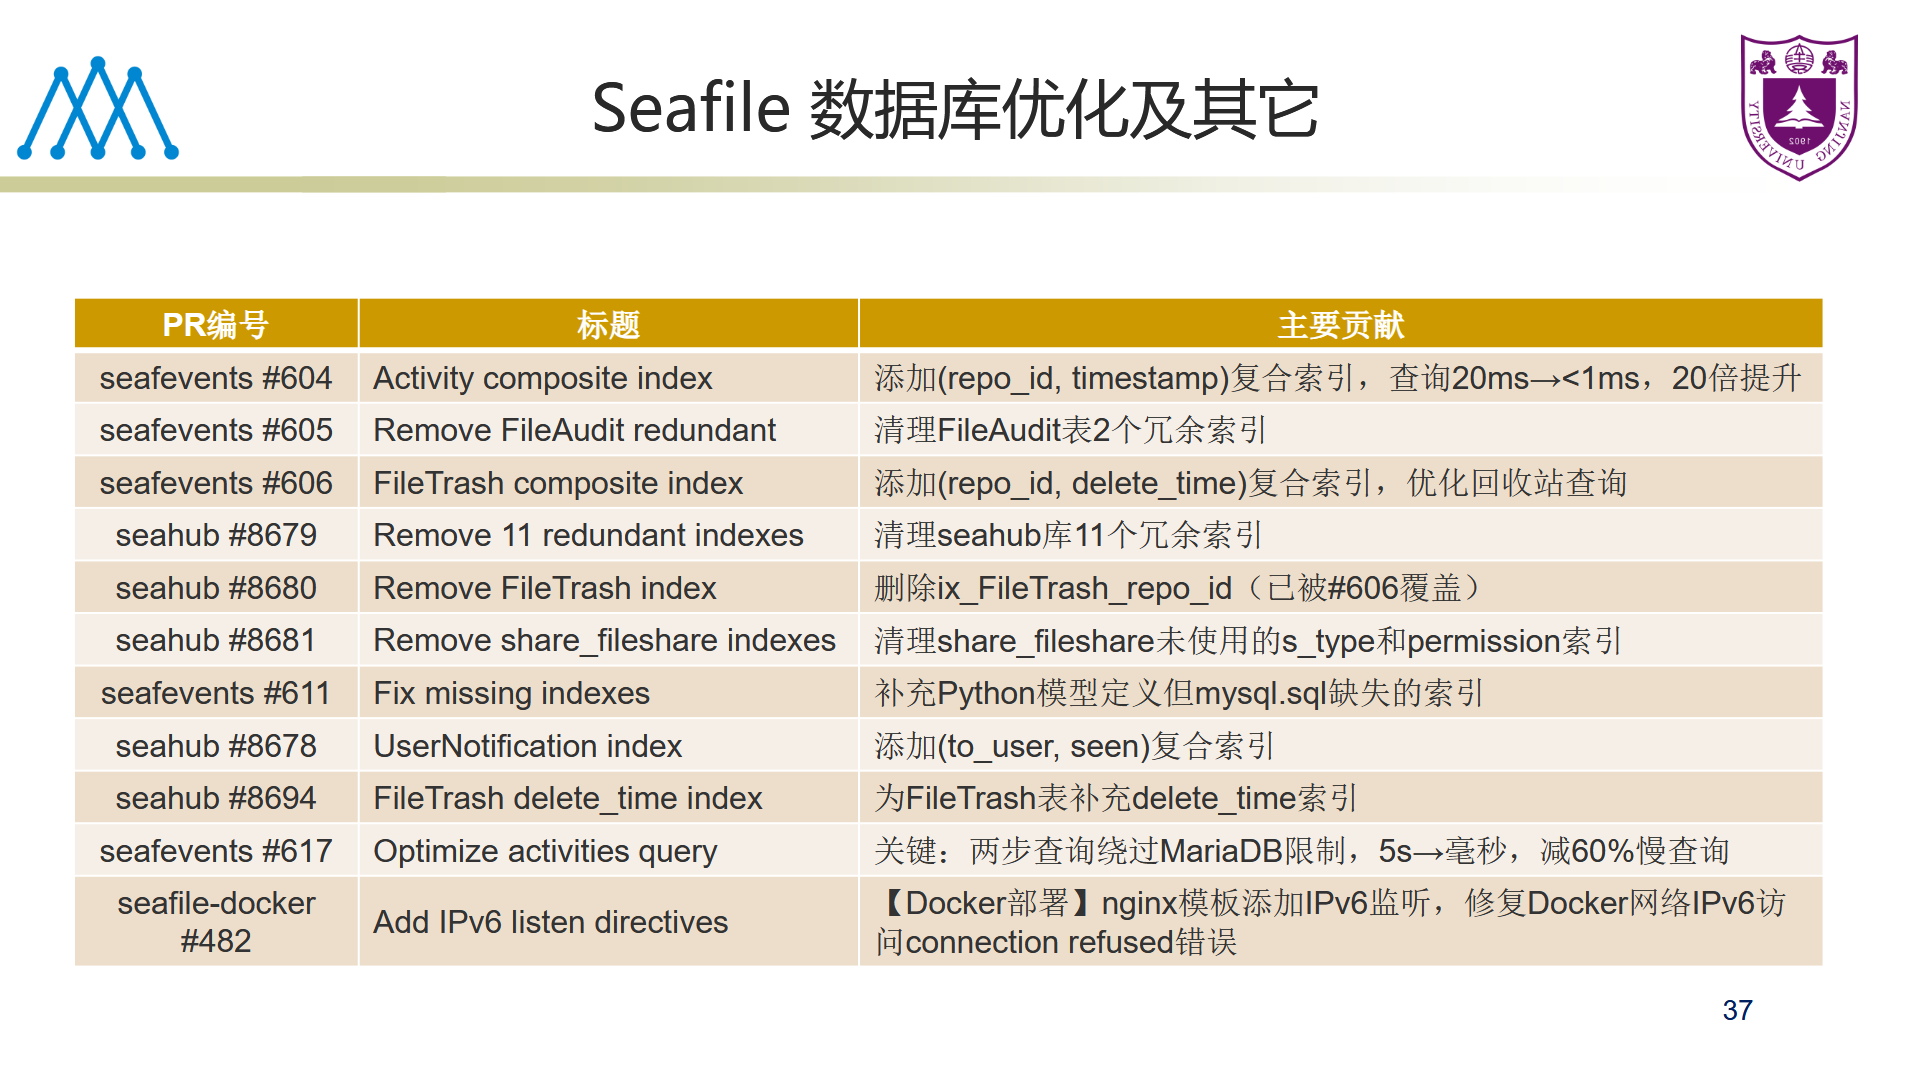
为支撑这一规模,中心基于原始 ngx_cache_purge 老版本开发了 nginx-cache-refresh 模块实现精细化缓存刷新(同步后仍保留 99.69% 容量的有效缓存),并持续回馈上游。除了针对 Nginx Cache 的优化开发以外,借助 AI 技术发展赋能,充分发挥多年运维经验,过去一年中心还提交了多项代码贡献:tunasync 的 rsync 退出码容错、nginx-module-vts 的 SIGSEGV 与死锁修复、Seafile 服务(Box 云盘)的多个 PR……其中,针对 Seafile 服务的内存泄漏和各类性能问题修复后,服务性能需求从 32 核 64GB 降到 8 核 16GB,节省 75% 资源;一行异步阻塞修复使吞吐从 15 提升到 180+ req/s。
此外,中心还用开源项目 Anubis(工作量证明)抵御 AI Bot 对 GitLab 的全量扫描,保障用户的使用体验。如今,Box 云盘(约 5.8 万用户)、协同表格(约 9 万用户)、GitLab、测速、密码管理、时钟同步(占中国 DNS NTP 应答约 6%)、日志监控等全套自建基础设施,共同构成了南大师生科研、管理、教学中“润物细无声”的开源服务底座。
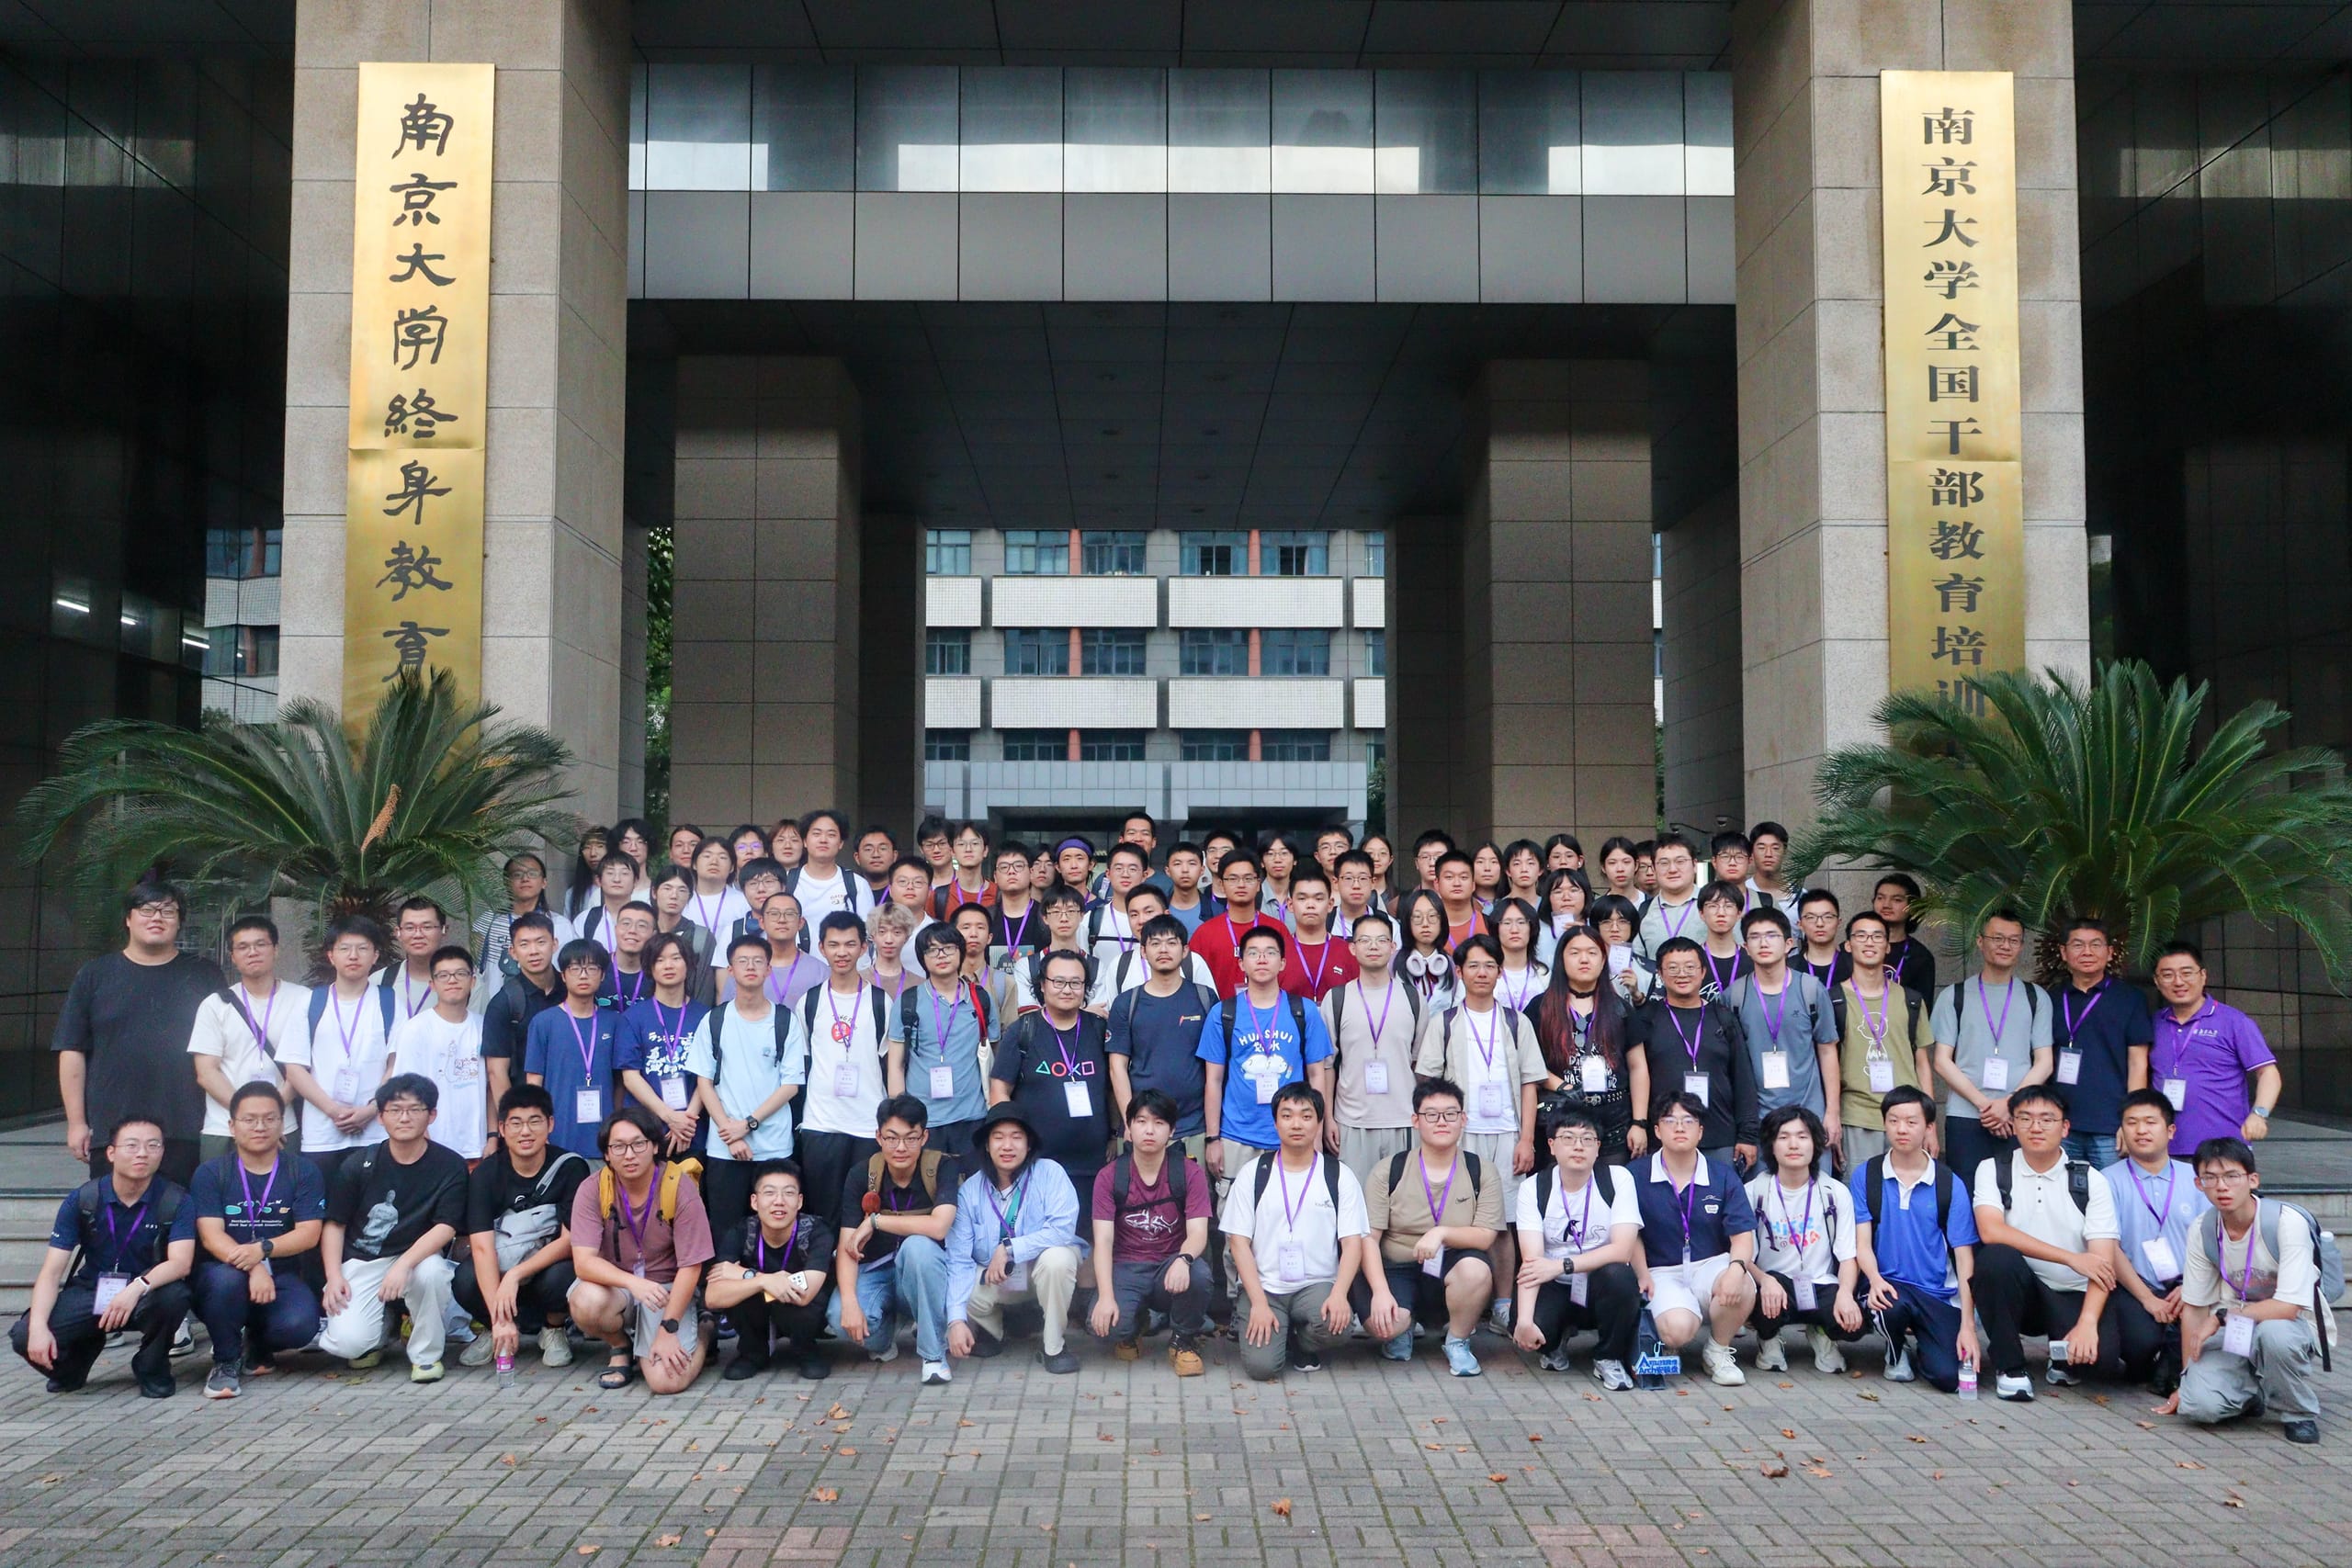
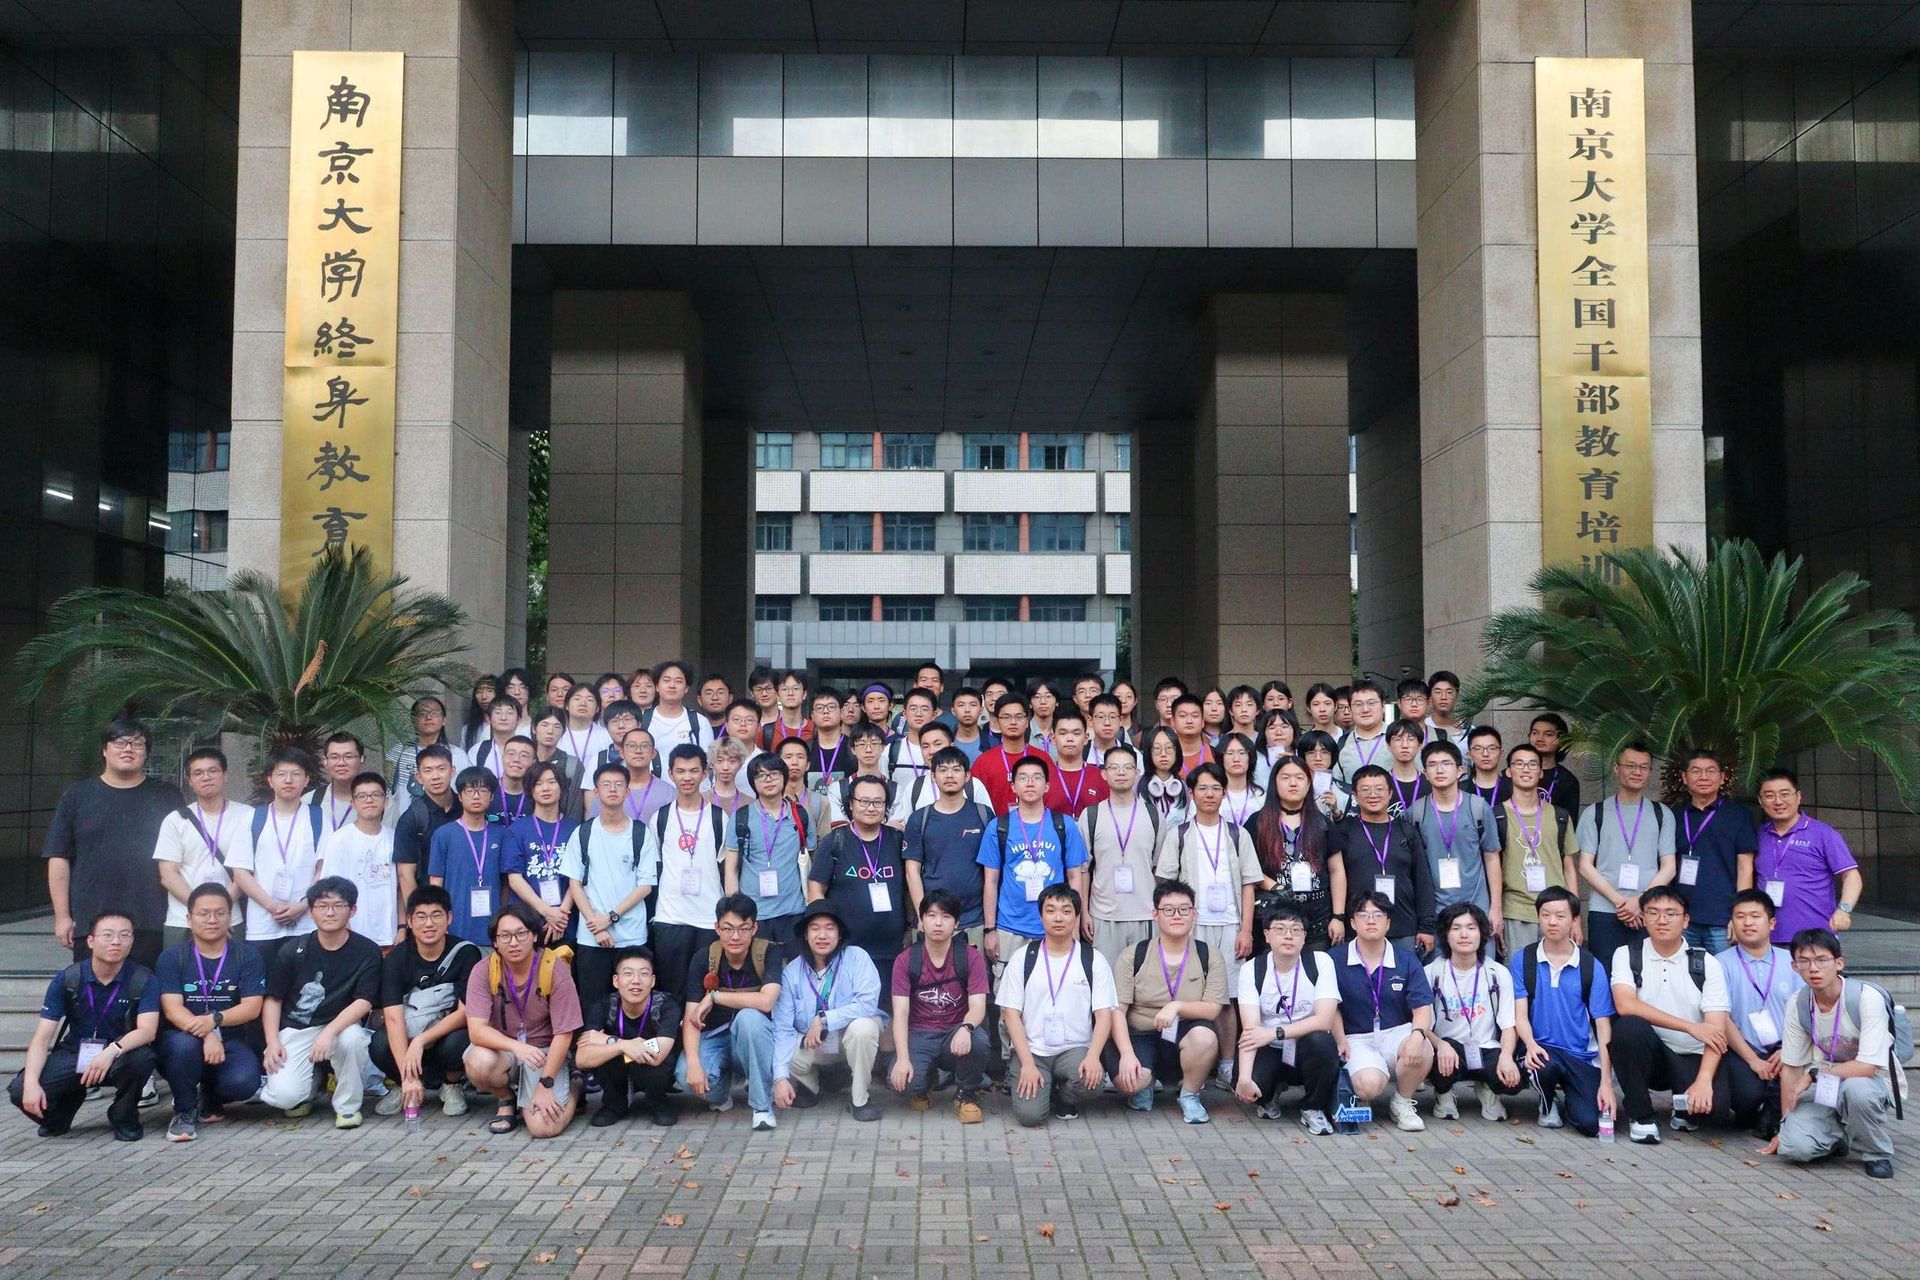
不觉间已至黄昏,报告在热烈讨论中落下帷幕。参会者合影留念,为本次会议的白天日程画上圆满句号。
相关报道
照片